 aistudy 메인
ID3 는 어떤 조건에서는 매우 효율적일 수 있지만, 그 효용성 범위를 넘어서서 사용되어서는 안 됩니다. ID3 는 많은 수의 패턴들이 있고, 각 패턴들이 긴 길이의 비수치 변수값 (속성값) 으로 구성되어 있을 때 유효하게 사용될 수 있습니다. 이러한 패턴들의 일부의 클래스의 종류 (class membership) 는 사전에 주어집니다.
그 작업은 방대하게 많은 데이터를 체계적으로 검사하고, 변수값들의 최소 조합이 클래스의 종류를 결정하기에 충분하다는 것을 발견하는 것입니다.
ID3 에서는 문자로 된 예들이 정확하게 분류될 때까지 변수들이 어떻게 순서대로 검사되는 지를 결정합니다. 예를 들면, 전체 변수들 중에서 단지 아주 작은 부분(핵심 속성)만이 분류 목적을 위해 사용될 필요가 있다는 것을 알게 됩니다. 문자로 된 예들에 대해 얻어진 이러한 결과가 원래의 데이터를 포함하는 훨씬 더 큰 패턴 집합을 잘 대표한다면, ID3 를 사용함으로써 매우 큰 이득(Gain)이 얻어지게 될 것입니다.
덧붙여서 식별트리를 발견한 결과로서, 클래스의 종류는 변수값들의 어떤 조화에 의존한다는 사실은 검사가 이루어지는 과정을 결정하는 기본 메커니즘에 대한 깊은 통찰력을 제공하게 됩니다.
다음에 Quinlan (1983) 의 예로서 그 과정을 실증하고, 더 일반적인 과정을 표현합니다.
패턴의 집합을  (I) 라고 하고, 신장(Height), 머리색깔(Hair), 눈색깔(Eyes) 같은 3가지 변수가 다음과 같은 비수치 변수값을 가집니다 :
클래스의 종류는  (o) 와
 (a) 입니다. 이때 훈련 패턴 집합
 (I) 는 다음과 같이 총 8개의 관측 예시로 주어집니다 :
| 패턴 번호 | 신장 (Height) | 머리색깔 (Hair) | 눈색깔 (Eyes) | 소속 클래스 (Class) | 원전 수식 표기 이미지 |
|---|---|---|---|---|---|
| 1 | tall | dark | blue | Class a |  |
| 2 | short | dark | blue | Class a |  |
| 3 | tall | blond | blue | Class o |  |
| 4 | tall | red | blue | Class o |  |
| 5 | tall | blond | brown | Class a |  |
| 6 | short | blond | blue | Class o |  |
| 7 | short | blond | brown | Class a |  |
| 8 | tall | dark | brown | Class a |  |
여기서  (I) 는 모든 가능한 변수값의 조합 (2 × 3 × 2 = 12개) 을 모두 포함하지 않는다는 것을 알 수 있습니다. 즉 12개의 가능한 조합 중에서 8개만을 나타낸 불완전 집합입니다.
ID3 방법의 목적은  (I) 의 모든 패턴들을 구분하기에 충분한 최적 테스트의 순서를 찾아내는 것입니다. 이를 통해
 (I) 에 포함되지 않았던 나머지 4개의 미관측 패턴이나 새로운 데이터에 대해서도 동일한 식별 규칙을 성공적으로 일반화하여 적용할 수 있게 됩니다.
ID3 는 정보이론적(Information-theoretic) 접근 방식을 사용합니다. 그 과정은 정보에서는 가장 큰 이득(Gain)을 얻고, 엔트로피에서는 가장 큰 감소를 가져오는 변수를 검사하는 것입니다.
테스트의 다양한 단계에서의 엔트로피를 평가해 봅시다 :
 (o) 는 0.5, 클래스
 (a) 도 0.5 의 동일한 확률이 부여되므로 시스템의 초기 엔트로피는 최대값인 1 bit 가 됩니다.
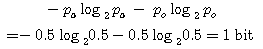
 (a) 클래스이고, 3개는
 (o) 클래스입니다. 따라서 테스트 전 시스템의 엔트로피는 다음과 같습니다 :
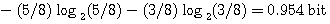
이 시점에서 "어떤 변수가 클래스 종류를 구분하는 데 가장 효율적인가?" 하는 핵심 의문이 발생합니다. 3개의 후보 변수인 신장(Height), 머리색깔(Hair), 눈색깔(Eyes)을 모두 고려하여, 각 변수를 분기 테스트했을 때 얼마만한 정보 이득(Information Gain)이 얻어지는지를 비교 검증합니다.
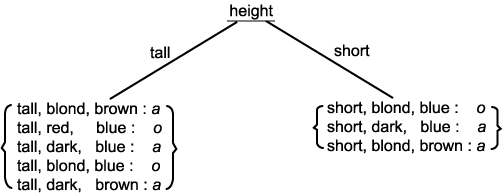
• "tall" 가지의 엔트로피 : 5개 패턴 중 2개는 a, 3개는 o
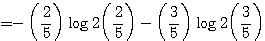 = 0.971 bits (원전 표기: 0.917 bits)
• "short" 가지의 엔트로피 : 3개 패턴 중 1개는 o, 2개는 a
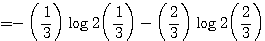 = 0.918 bits
• 테스트 전 시스템 엔트로피 :
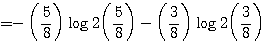 = 0.954 bits
• "신장" 분할 후 가중치 엔트로피 Entropy(I, "height") :
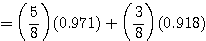 = 0.951 bits
• 신장 테스트에 의한 정보 이득 (Information Gain) :
Entropy(I) - Entropy(I, "height") = 0.954 - 0.951 = 0.003 bits
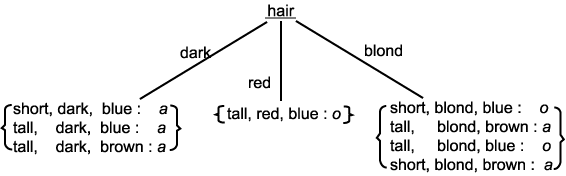
• "dark" 가지의 엔트로피 : 3개 모두 a → 0 bit (완전 순수, 추가 정보 불필요)
• "red" 가지의 엔트로피 : 1개 모두 o → 0 bit (완전 순수, 추가 정보 불필요)
• "blond" 가지의 엔트로피 : 4개 중 2개는 a, 2개는 o
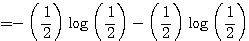 = 1.0 bit
• "머리색깔" 분할 후 가중치 엔트로피 Entropy(I, "hair") :
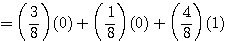 = 0.5 bits
• 머리색깔 테스트에 의한 정보 이득 (Information Gain) :
Entropy(I) - Entropy(I, "hair") = 0.954 - 0.5 = 0.454 bits (압도적 최대치!)
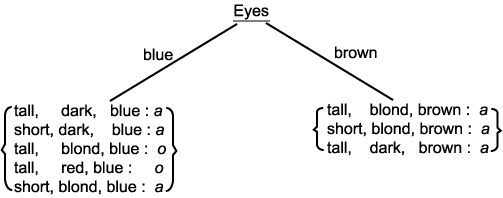
• "blue" 가지의 엔트로피 : 5개 중 2개는 a, 3개는 o
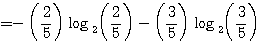 = 0.971 bits
• "brown" 가지의 엔트로피 : 3개 모두 a → 0 bit
• "눈색깔" 분할 후 가중치 엔트로피 Entropy(I, "eyes") :
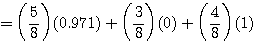 = 0.607 bits
• 눈색깔 테스트에 의한 정보 이득 (Information Gain) :
Entropy(I) - Entropy(I, "eyes") = 0.954 - 0.607 = 0.347 bits
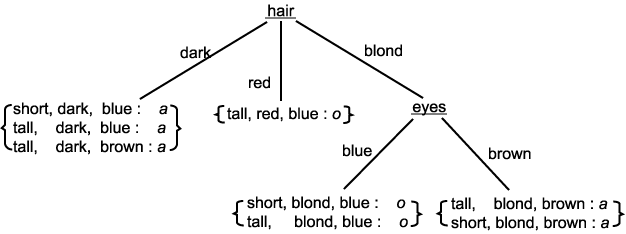
1) 그림 1의 신장은 0.003 bits의 매우 적은 정보 이득만을 줍니다. 반면 머리색깔은 0.454 bits, 눈색깔은 0.347 bits를 나타냅니다. 따라서 ID3 메커니즘에 따라 정보 내용에서의 이득이 가장 큰 "머리색깔"이 트리의 루트(Root Node)로 최종 선택됩니다.
2) 이어서 2번째 Level에서는 "blond" 가지(4개 샘플, a:2, o:2)에 대해 남은 변수인 "눈색깔"을 테스트함으로써 blue는 o, brown은 a로 완벽히 분리되어 엔트로피 0에 도달합니다. 이 결과가 바로 아래의 2-Level Decision Tree 입니다.
일반적인 경우,  (N) 개의 문자로 표현된 패턴들이 클래스
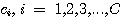 (c_i, i = 1, 2, 3, ..., C) 에 속하는 패턴 집합으로 분할됩니다.
클래스  (c_i) 에서의 모집단은
 (N_i) 입니다. 각 패턴은
 (K) 개의 변수를 가지며, 각 변수는
 (J_k) 개의 값들을 가집니다. (여기서는 단순화시켜서 모든 변수들이
 (J) 개의 값들을 가지는 것으로 합니다). 효율적인 decision tree 를 생성하기 위한 ID3 방법은 다음과 같은 단계를 거칩니다 :
1 Step 1. 엔트로피의 초기값을 계산한다.
훈련 집합에서 모든 패턴들에 대해 어떤 클래스에 속하는지 표시됩니다. 그러므로  (N) 개의 패턴으로 구성된 시스템을 위한 초기 엔트로피는 다음과 같습니다 :
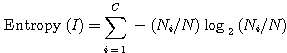
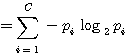
2 Step 2. decision tree 의 root node 가 될 변수를 선택한다.
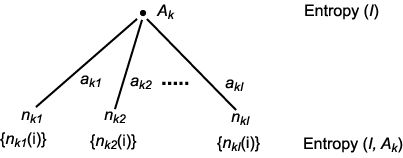
 (A_k,
 ) 에 대해
 (J) 개의 변수값
 (a_kj) 에 따라 원래의 모집단을 1 level 모집단으로 분할합니다. 각 가지에는
 (n_kj) 개의 패턴들이 속합니다.
 (n_kj) 내에서 클래스
 (c_i) 에 속하는 패턴의 수를
 (n_kj(i)) 라 할 때, 각 가지의 엔트로피는 다음과 같이 계산됩니다 :
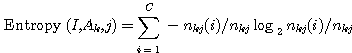
 를 테스트한 후의 전체 가중 시스템 엔트로피는 다음과 같습니다 :
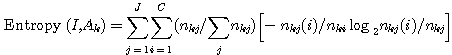
 를 테스트한 결과로서 엔트로피의 감소(정보 이득)는 다음과 같습니다 :
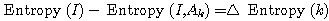
 (A_ko) 를 선택합니다.
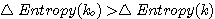
 는 decision tree 의 Root 가 되고 1 level 구조는 아래 그림 5 와 같이 형성됩니다 :
3 Step 3. decision tree 의 다음 level 을 만든다.
모든 가지들에 대해 나머지 잔여 변수  (A_k') 상에서 테스트하여, 정보 내용에서 최대의 이득을 얻거나 엔트로피가 최대 감소하는 변수를 Level-1 노드로서 사용할 변수로 순차 선택합니다.
4 Step 4. Step 1 에서 Step 3 까지 반복한다.
모든 하위 모집단(subpopulation)이 하나의 클래스로 통일(완전 순수)되고 시스템 엔트로피가 0 이 될 때까지 위의 과정을 재귀적으로 반복합니다.
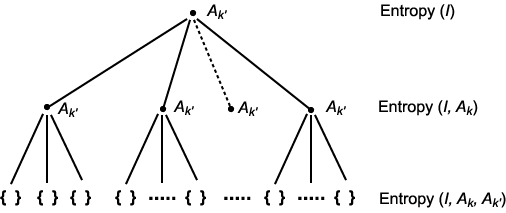
ID3 방법에서 기본적인 작업은 각 가지에 대해 엔트로피를 계산하는 것입니다. 여기서는  (K) 개의 변수 각각이
 (J) 개의 값을 가지는 것으로 가정해왔습니다.
 에 대해
 번의 계산을 수행합니다.
 개의 노드 각각이
 개의 가지를 가지므로,
 (K - 1) 개의 변수 각각이
 (J²) 번의 계산을 하게 됩니다.
그러나 트리의 레벨이 증가하면서 여러 개의 가지들이 단일 클래스로 순수해짐에 따라 계산의 부담은 점차 감소하게 됩니다. 추정하여 보면  (L-level) 의 트리는
 (L/2-level) 의 완전히 확장된 decision tree 정도의 복잡성을 보이는 것으로 추정됩니다.
Quinlan (1983, p. 464) 은 계산 부담에 대해 다음과 같이 서술합니다 :
"ID3 는 많은 대상을 다루기 위해 특별히 고안된 것이며, 문제의 어려움과 함께 계산 시간이 선형적으로 증가하는 것은 다음과 같은 요소들 때문입니다 :"
 N)
 K)
 Jˣ)
계산의 요구에 대한 Quinlan 과 우리의 서술은 근본적으로 동일합니다.