 aistudy 메인
Tom Mitchell 은 사례로부터 단일개념을 학습하는 하나의 일관된 수학적·논리적 틀을 제공하였다.
버전 공간(Version Space, VSH,D)이란 표현 가능한 전체 가설 공간(Hypothesis Space) H 중에서, 현재까지 관측된 모든 훈련 데이터셋 D의 긍정 사례와 부정 사례에 전혀 모순되지 않고 완벽하게 일치(Consistent)하는 모든 가설들의 부분집합을 의미합니다.
머신러닝 이전의 초기 인공지능 연구는 학습을 '가설을 마구잡이로 생성하거나 직관적으로 추측하는 과정'으로 보았습니다. 그러나 톰 미첼은 "기계학습(개념 학습)이란 사전에 정의된 거대한 가설 공간 H 내에서 훈련 데이터와 일치하는 정답 가설을 효율적으로 찾아내는 체계적인 탐색(Search) 문제"로 재정의하였습니다.
주어진 객체 인스턴스들의 집합에서 어떤 대상이 특정 범주(예: '스포츠를 즐기기에 좋은 날', '아치', '악성 종양')에 속하는지 여부를 결정하는 불리언 함수(Boolean Function) c : X → {0, 1}를 유도하는 과업입니다.
가설 h가 훈련 집합 D의 모든 긍정 사례에 대해 1(참)을 반환하고, 모든 부정 사례에 대해 0(거짓)을 반환할 때 가설 h는 데이터 D와 일관된다고 정의합니다.
버전 공간 안에 수만~수억 개의 일치 가설이 존재할 수 있지만, 버전 공간 기법은 이 모든 가설을 일일이 나열하지 않고 오직 양 끝단의 경계(G와 S)만으로 전체를 완벽히 표현합니다.
Mitchell 은 먼저 개념의 표현에서 그것의 일반화된 정도에 따라 순서를 매길 수 있다고 보았다.
예를 들어, 다섯 장의 카드에 대해서 ∃c1 : RED(c1) 은 "다섯 장 중 적어도 한 장은 빨간색이다" 라는 것이며, 이는 "적어도 두 장이 빨간색이다" 라는 뜻인 ∃c1, c2 : RED(c1) ∧ RED(c2) 보다는 일반적이다. 왜냐하면 적어도 두 장의 빨간색 카드를 가지는 모든 다섯 장의 카드의 조합이 빨간색 한 장만 가지는 경우에 포함되기 때문이다.
이렇게 일반화의 정도에 따라 규칙공간의 모든 개념들의 순서를 매길 수 있다. 훈련사례만 주어진 초기 상태에서 가장 구체적인 개념은 훈련사례 그 자체가 될 것이고, 가장 일반적인 개념은 널 (Null) 진술로서 모든 것을 다 포괄하는 개념 — 즉, 모든 제약과 조건이 떨어진 사례 전체를 일컫는 진술 — 이 될 것이다.
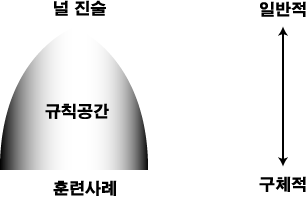
인스턴스 공간 X와 가설 공간 H에서 두 가설 h1, h2 ∈ H에 대해, h2가 참으로 분류하는 모든 인스턴스를 h1 역시 참으로 분류할 때, 우리는 h1이 h2보다 "더 일반적이다(More-General-Than or Equal to)"라고 정의하며 기호로 h1 ≥g h2로 표기합니다.
이러한 규칙공간에서 선택가능한 가설집합 H 를 상정할 때 H 중 가장 일반적인 것들을 G 집합이라 하고, 가장 구체적인 집합을 S 라 하자. 그러면 H 는 G 와 S 로 경계지어지는 집합이 될 것이다. Mitchell 은 이러한 가설집합 H 를 사례에 아직 저촉되지 않은 가설집합이라 하고 이를 버전공간 (Version Space) 이라 불렀다. 따라서 버전공간 H 는 현재까지 제시된 모든 사례를 수용하는 규칙공간이 된다.
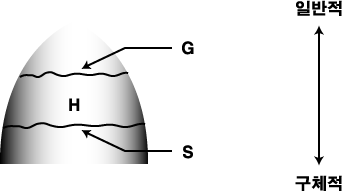
현재까지 관찰된 모든 데이터 D와 일관되는 가설들 중 '가장 일반적인(Most General)' 극단 가설들의 집합입니다. 어떤 부정 사례도 포함하지 않도록 조건을 최소한으로 특수화(Minimal Specialization)하여 유지합니다.
현재까지 관찰된 모든 데이터 D와 일관되는 가설들 중 '가장 구체적인(Most Specific)' 극단 가설들의 집합입니다. 모든 긍정 사례를 포함할 수 있도록 조건을 최소한으로 일반화(Minimal Generalization)하여 유지합니다.
유한한 인스턴스 공간과 가설 공간에서, 버전 공간 VSH,D에 속하는 모든 가설 h는 다음 조건을 만족하며 완벽하게 복원됩니다 :
Mitchell 은 이러한 버전공간 중 필요한 개념을 생성하는 학습과정을 대안제거 학습알고리즘 (Candidate-elimination Learning Algorithm) 이라 하였다. 이는 처음에 집합 H 는 모든 표현가능한 개념으로서 구성되지만 훈련사례가 주어지게 되면서 그것에 저촉되는 대안개념 (Candidate Concept) 들이 버전공간에서 제거되게 된다. 이러한 제거과정에서 마지막까지 남는 대안개념이 찾고자 하는 개념이 되는 것이다.
G 집합은 가설 공간에서 가장 일반적인 단일 가설로 초기화하고, S 집합은 가장 구체적인 가설로 초기화합니다 :
• G0 = { ⟨ ?, ?, ?, &dots;, ? ⟩ } (모든 인스턴스를 긍정으로 분류)
• S0 = { ⟨ ∅, ∅, ∅, &dots;, ∅ ⟩ } (어떤 인스턴스도 긍정으로 분류하지 않음)
1. G 집합에서 x를 긍정으로 분류하지 못하는 모든 가설을 제거합니다.
2. S 집합의 각 가설 s에 대해, 만약 s가 x와 일치하지 않는다면 :
- s를 S에서 제거합니다.
- x를 포함하도록 s의 최소 일반화(Minimal Generalization) 가설들을 모두 구해 S에 추가합니다. 단, 추가되는 가설은 G의 어떤 원소보다 구체적이거나 같아야 합니다.
3. S 집합에서 다른 원소보다 더 일반적인 잉여 가설들을 제거합니다.
1. S 집합에서 x를 긍정으로 잘못 분류하는 모든 가설을 제거합니다.
2. G 집합의 각 가설 g에 대해, 만약 g가 x를 긍정으로 잘못 분류한다면 :
- g를 G에서 제거합니다.
- x를 배제하도록 g의 최소 특수화(Minimal Specialization) 가설들을 모두 구해 G에 추가합니다. 단, 추가되는 가설은 S의 어떤 원소보다 일반적이거나 같아야 합니다.
3. G 집합에서 다른 원소보다 더 구체적인 잉여 가설들을 제거합니다.
긍정사례 (Positive Instance) 가 주어지면 이를 포함하는 개념이 남고 나머지가 제거되며 따라서 일반화로 진행된다. 그런데 이러한 진행과정은 최소한의 일반화 및 구체화과정만을 허락하고 필요 이상은 진행하지 않는다. 즉, 긍정사례가 주어졌을 때 해당 사례를 포함할 수 있는 최소한의 일반화, 다시 말하면 해당 사례를 포함하는 것 중 최대의 구체화만을 수행한다는 것이다. 이런 식으로 집합 H 는 차츰 좁혀지며 결국 우리가 원하는 개념만이 남게 된다.
| 사례 유형 | 영향을 받는 경계 | 조작 연산 | 역할 및 목표 |
|---|---|---|---|
| 긍정 사례 (+) | S 경계 집합 (Specific) | 최소 일반화 (Minimal Generalization) 예: ∅ → 구체값, 구체값 → ? |
사례를 놓치지 않도록 S 경계를 위(G 방향)로 끌어올림 |
| 부정 사례 (-) | G 경계 집합 (General) | 최소 특수화 (Minimal Specialization) 예: ? → 다른 속성값으로 한정 |
오답 사례를 배제하도록 G 경계를 아래(S 방향)로 끌어내림 |
긍정 사례는 아래에서 위로 S를 밀어 올리고, 부정 사례는 위에서 아래로 G를 끌어내립니다. 두 경계가 서로를 향해 좁혀져 오다가 최종적으로 S와 G가 단 하나의 동일한 가설 h*로 일치하게 될 때(S = G = { h* }) 비로소 완벽한 목표 개념 학습이 완성됩니다.
톰 미첼의 고전 '운동하기 좋은 날(EnjoySport)' 문제를 단순화한 4가지 기상 속성의 실제 숫자 계산 과정입니다 :
| 속성명 | 가능한 구체값 | 경우의 수 | 가설에서 취할 수 있는 값 (구체값 + '?') |
|---|---|---|---|
| 1. 날씨 (Sky) | 맑음, 흐림, 비 | 3가지 | 3 + 1 = 4가지 (맑음, 흐림, 비, ?) |
| 2. 기온 (Temp) | 따뜻함, 추움 | 2가지 | 2 + 1 = 3가지 (따뜻함, 추움, ?) |
| 3. 습도 (Humidity) | 보통, 높음 | 2가지 | 2 + 1 = 3가지 (보통, 높음, ?) |
| 4. 바람 (Wind) | 강함, 약함 | 2가지 | 2 + 1 = 3가지 (강함, 약함, ?) |
학습이 완전히 끝나지 않아 버전 공간에 여러 개의 가설이 남아 있는 상태에서도, 버전 공간은 새로운 인스턴스를 매우 지능적으로 분류할 수 있습니다.
새로운 인스턴스 x가 S 집합의 모든 가설에 의해 긍정으로 판정된다면, S보다 일반적인 버전 공간 내의 모든 가설도 반드시 x를 긍정으로 판정하므로 100% 확실한 긍정입니다.
새로운 인스턴스 x가 G 집합의 어떤 가설에 의해서도 긍정으로 판정되지 않는다면, G보다 구체적인 버전 공간 내의 모든 가설도 x를 부정으로 판정하므로 100% 확실한 부정입니다.
버전 공간 내의 일부 가설은 긍정으로, 다른 가설은 부정으로 판정할 때입니다. 이때는 가설들의 다수결 투표(Majority Vote)를 사용하거나 판정을 보류합니다.
버전 공간이 아직 수렴하지 않았을 때, 학습기는 가설들 간의 의견 대립이 50:50으로 가장 팽팽하게 갈리는 인스턴스 x를 스스로 찾아 교사(Oracle)에게 라벨을 질문할 수 있습니다. 이 단 하나의 인스턴스에 대한 라벨만 얻으면 결과가 긍정이든 부정이든 버전 공간의 절반 이상이 즉시 제거되므로, 최소한의 질의 횟수로 가장 빠르게 수렴하는 '능동 학습(Active Learning)'의 이론적 토대가 되었습니다.
톰 미첼의 버전 공간과 대안제거 알고리즘은 1970~80년대 기계학습을 독자적인 컴퓨터 과학의 핵심 분과로 정립시키는 데 지대한 공헌을 하였습니다.
기계학습을 엄밀한 탐색 공간(Search Space)과 검색 연산자(일반화/구체화)의 문제로 정식화하여, 인공지능 탐색 이론(A* 알고리즘 등)과 기계학습 이론을 완벽하게 통합시켰습니다.
"사전 가정(편향)이 없는 가설 공간(예: 모든 불리언 함수의 멱집합)에서는 관측되지 않은 사례를 일반화할 수 없다"는 사실을 증명하여, 모든 기계학습 알고리즘의 심장인 '귀납적 편향(Inductive Bias)' 개념을 정초했습니다.
버전 공간이 허용 오차 ε(?낆떎濡? 이내로 좁혀지기 위해 필요한 표본 복잡도(Sample Complexity)를 분석하는 과정에서, 레슬리 밸리언트(Leslie Valiant)의 PAC(Probably Approximately Correct) 학습 및 블리머(Blumer)의 가설 복잡도 이론에 결정적인 영감을 주었습니다.
블랙박스 인공신경망과 달리, 데이터와 일치하는 모든 가설의 상한(G)과 하한(S)을 완벽하게 투명하게 보존하므로, 어떤 예측에 대해서도 100% 명확한 논리적 근거와 불확실성 범위를 제시할 수 있습니다.
마이크로소프트의 프로그래밍 바이 이그잼플(Programming by Example : FlashFill, 엑셀 자동 채우기)과 지능형 에이전트 인터페이스에서 사용자의 몇 가지 예시로부터 함수를 유도하는 핵심 엔진으로 발전했습니다.
버전 공간은 사전 확률이 균일하고 우도가 0 또는 1인 베이지안 사후 확률 분포(Bayesian Posterior Distribution)의 서포트(Support)와 수학적으로 정확히 일치함을 증명하여 통계적 학습 이론과 기호 학습을 연결했습니다.
버전 공간은 이론적으로 완벽한 우아함을 지녔으나, 현실의 복잡한 대규모 데이터에 적용될 때 명확한 실용적 한계를 드러냈습니다.
| 한계 항목 | 버전 공간의 고전적 문제점 | 현대 기계학습의 해결책 |
|---|---|---|
| 노이즈(Noise)에 대한 취약성 | 단 하나의 라벨링 오류나 이상치(Outlier)가 유입되면 S가 G를 넘어서서 버전 공간이 완전히 붕괴(VS = ∅(怨듭쭛??) | 확률적 소프트 제약, 서포트 벡터 머신(SVM)의 슬랙 변수, 정규화(Regularization) 손실 함수 |
| 표현력의 한계 (Expressiveness) | 가설 공간이 연언(Conjunction) 형태에 국한될 때 효율적이며, 이접(Disjunctive: A 또는 B)을 허용하면 경계 크기 폭발 | 의사결정나무(Decision Tree), 랜덤 포레스트(Random Forest), 딥 신경망의 다층 비선형 표현 |
| 경계 집합의 조합 폭발 | 속성 수와 데이터가 증가하면 G 집합과 S 집합의 크기가 지수함수적으로 증가하여 메모리 한계 봉착 | 점진적 경사 하강법(SGD) 및 파라미터 최적화 기법 |
실제 시스템에서 VS = ∅(怨듭쭛??가 발생하면 (1) 훈련 데이터에 노이즈가 존재하거나, (2) 실제 목표 개념이 가정된 가설 공간 H로 표현할 수 없는 경우입니다. 현대 연구에서는 다수결 투표를 가중치화하거나, 가장 적은 수의 사례를 위반하는 가설을 선택하는 완화된 버전 공간(Relaxed Version Space) 기법을 사용합니다.
버전 공간의 핵심인 대안제거 알고리즘(Candidate Elimination Algorithm)이 실제 다차원 훈련 데이터셋(긍정 및 부정 인스턴스)을 만나면서 어떻게 S 집합과 G 집합을 한 단계씩 갱신해 나가는지를 명쾌하게 보여주는 명강의 영상입니다.
💡 영상 안내 : 톰 미첼의 저서에 등장하는 고전 데이터셋 예제를 바탕으로, S 집합과 G 집합의 초기화, 긍정 사례에 의한 S의 일반화, 부정 사례에 의한 G의 특수화, 중복 가설 제거 과정을 시각적으로 상세히 추적합니다.
버전 공간과 함께 기계학습 이론의 기틀을 마련한 핵심 개념들을 함께 탐구해 보세요.