Discourse Analysis
AI Topics
: Discourse Analysis
사람을 위한 일을 하기 위하여, 컴퓨터
프로그램은 사람이 원하는 것이 무엇인지를 우선 알아야 한다. 언어 대화는 사람이
이러한 정보를 전달하기 위한 아주 편한 방법이다. 따라서 컴퓨터에 의한 자연언어
이해의 응용 중에 중요한 것은 컴퓨터와 이의 사용자 간의 대화를 이루는 것이라
하겠다. 그러나 여러 이유에 의해 대화를 이해하는 것은 지극히 힘든 일이다.
Xerox에서 만든여행계획의 질의응답 시스템인
GUS와 고객간의 응답 예를 보여주는 화면이다. 가는 글씨는 GUS, 굵은 글씨는
고객의 말을 나타낸다.
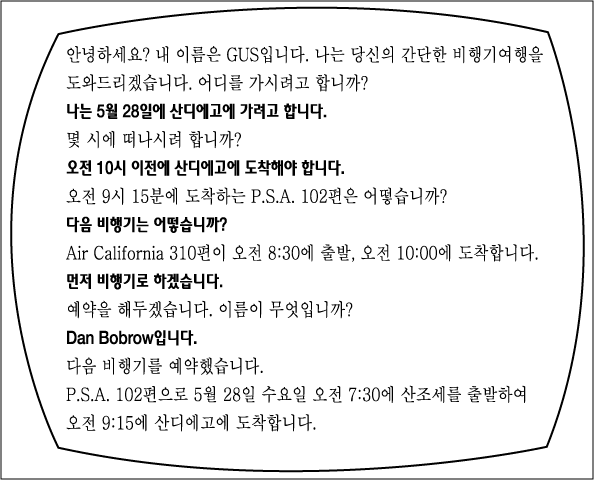
위 화면은 다음과 같은 문제점들을 설명하여 주는데, 효율적인 대화 이해를
위해서는 이러한 문제점들이 해결되어야 한다.
- 대화의 주도권 : 만일 프로그램이 대화의
주도권을 갖고, 사용자는 단순히 프로그램의 질의에 대한 응답만을 한다면 일은
간단해 진다. 이런 경우 프로그램은 사용자가 선택할 수 있는 아주 적은 경우의
응답만을 고려하면 된다. 그러나 자연적인 대화의 경우, 참가하는 사람들 간에
대화의 주도권이 교환되며, 이 때 사용자가 주도권을 가졌다면, 프로그램은 보다
광범위한 내용을 준비하여야 한다. GUS의 예에서 사용자의 첫 번째와 두 번째
대화는 사용자가 주도권을
갖는 경우이다. 이렇듯 대화의 주도권이 교환되는 경우를 혼합-주도 대화(Mixed-Initiative
Dialogues)라고 한다.
- 간접적인 대화 행위 : 사람들은 항상
그들이 의미하는 것을 직접적으로 명확하게 표현하는 것만은 아니다. 때로는
질문된 내용에 대하여 간접적으로 응답할 수 있는데, 이의 예가 두 번째 대화의
경우이다. 응답의 경우만이 아니고, Speech Acts
도 이에 해당한다. 사실에 관한 간단한 서술도 이들이 직접적으로
의미하는 이상의 내용을 전달하는 경우가 있다. 만일 사용자가 GUS에게 "나는
담배를 싫어한다."라고 하였다면, 이는 결국 금연석을 원한다는 의미로 이해해야
할 것이다. (참조 : P.R.Cohen "Elements of a Plan-based Theory of Speech
Acts" 1979)
- 암시된 가정 : 사람들은 종종 옳지 않은
가정을 갖고 질문을 하는 경우가 있다. 이렇게 가정이나 예상이 그릇되었을 때는
응답자가 이를 지적하여 주어야 한다. 예로써, 사용자가 GUS에게, "나에게
안양으로 가는 대한항공 비행편을 말해달라" 라고 물었을 때, GUS는 단순히
"None"이라고 대답할 수 있을 것이다. 이때 안양으로 가는 비행기를
물어본 것은 안양에는 공항이 있다고 가정한 것이다. 만일 "None"인
이유가 안양에는 공항이 없기 때문이라면 이를 밝혀 주어야한다. 어떤
요청에 대하여 최소의 만족되지 않는 전제조건의 집합을 계산하여내는 손쉬운
방법이 있어야 한다. (참조 : S.J.Kaplan, "Appropriate Responses to Inappropriate
Questions", in Elements of Discourse Understanding" 1981)
- 대용어(Anaphoric references) : 대화는
연속적인 이야기보다 대용어를 많이 사용하게 되는데, 이들은 화자들 간에 이미
언급한 것들을 인용하게 된다. 예로써, 세 번째 대화에서 "다음 비행편은
어떤가 ?"이라든지,
네 번째의 "먼저 비행기" 등의 경우가
된다.
- 문장의 조각 : 비록 대부분의 글은 완전한
문법적 문장으로 구성되지만, 대화의 경우는 그렇지 못하다. 예로써, 다섯 번째
대화에서 단순히 이름만 답변한 것은 문장의 일부이다. 대체로 이들은 응답하여야 할 질문에 있는 문법이 완전한 문장의
일부로부터 유도할 수 있는 것들이다.
이러한 어려움에도 불구하고, 대화를 이해하기 위해서는
다음을 포함한 제공되는 모든 정보를 이용하는 것이 중요하다. (참조 : A.K.Joshi,
Elements of Discourse Understanding 1981)
- 대화의 목표를 향한(goal-driven) 성격.
- 대화의 현재 초점.
- 각 참가자의 현재 생각에 대한 모델.
- 모든 참가자에 의해 적용되는 대화의 법칙.
이미 우리는 이러한 네 가지
중, 앞에서 두 가지의 내용을 다루었다. 이는 문장의 경우에서와 공통으로 유용하기
때문이다. 나머지 두 가지 내용은 대화의 이해를 위하여 중요하기에 여기서 논의하기로
한다.
(1) 각자의 생각에 대한 모델링
프로그램이 지능적으로 대화에 참여하기
위해서는, 프로그램이 세상에 관한 자기의 의견을 표현할 수 있는 것은 물론, 세상에
관한 지식을 표현할 수 있어야 되며, 더 나아가 프로그램의 생각에 대한 다른 사람의
생각 등도 표현할 수 있어야 한다. 조금 과장한다면 '네가 알고 있는 것을 내가 안다는
것을 또한 네가 알고, 그러한 사실을 내가 안다는 것을 다시 네가 아는 것'인데,
이러한 사고력이 항상 필요한 것이다.
각 대화 참여자(혹은 이야기에서
각 등장인물)에 대한 개개의 생각을 표현하기 위해서는, 다음의 내용이 필요하다.
(1)의 경우는 하나의 데이터베이스로써
모든 참여자의 생각을 나타내게 되지만, (2)의 경우는, 한 사람이 생각하는 것을
다른 사람이 것들과 구분하여야 한다. 이를 위한 방법중의 하나는 분할된 의미회로(semantic
nets)를 사용하는 것이다. 그림 1은 분할된 공간(space)을 이용한 것이다.
여기서는
세 가지 다른 공간이 존재한다.
- S1은 Mary가 Bill을 때렸다(hit)고 생각한다.
- S2은 Sue가 Bill을 때렸다고 생각한다.
- S3은 누군가가(주어져 있지 않은) Bill을 때렸다고
생각한다. 이런 종류의 완전하지 못한 생각도 처리할 수 있어야 하는데, 왜냐하면
이들은 "Who hit Bill?"과 같은 질문에 기본이 되는 형태이기 때문이다.
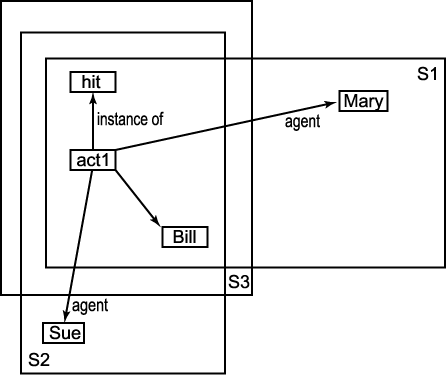
그림 1 세 개의 믿음 공간(belief spaces)을 보여주는
분할된 의미회로(semantic net)
(2) 대화의 가정(postulate)
대화의 경우에는 기본적으로 존재하는
규칙들이 있다. 이들은 보통 많은 경우에 잘 적용되나, 적용되지 않는 경우에는 위반되는
것 자체가 무엇인가를 의미하게 된다. 이러한 대화의 가정에 대한 규칙들 중 몇 가지는
다음과 같다.
- 충성심 조건(sincerity condition) : A로부터
B가 R을 하기를 원하는 요청이 이루어지려면, A는 B가 R을 원하여야 하고 B가
R을 할 수 있다고 생각하여야 하며, 동시에 A는 B가 기꺼이 R을 할 것이라고
생각하여야 하며, 또한 B가 아직 R을 하지 않았다고 생각하여야 한다. 만일 A가
B에게 이러한 조건 중의 하나를 물어 본다면, 이는 곧 R을 요청하는 것으로 B는
해석하여야 한다. 예로써,
A : Can you open the door?
- 합리성 조건(reasonableness condition) :
A에 의해서 B가 R을 행하기를 요청하는 것이 합리적이기 위해서는, R이 행하여지기를
원하는 이유가 A에게 있어야 하고, A는 B가 R을 기꺼이 하리라고 생각하는 이유가
있어야 하며, B가 R을 행하려고 계획하지는 않았다고 생각하는 이유가 있어야
한다. 합리성 조건은 종종 요청에 대한 이유를 요구하는 기본을 제공하면, 앞에서
논의한 충심성 조건과 함께 다음의 대화 교환에 대한 일관성을 설명한다.
A
: Can you open the door?
B : Why do you want it open?
- 적합성 조건(appropriateness condition)
: 대화가 적합한 것이기 위해서는, 대화가 올바른 정보를 지녀야 하고, 화자의
생각을 정확히 반영하면서도 간결, 명백하여야 하며, 또한 정중하여야 한다.
이러한 조건은 다음의 대화에서 A의 응답을 설명하여준다.
A : Who won
the race?
B : Someone with long, dark hair.
A : I thought you knew
all the runners.
A는 B의 불완전한 응답으로부터 B가 경기에서의 승리자가
누구인지를 모른다는 것을 추론하여 냈고, 이는 B가 안다면 안다고 말하였을
것이기 때문이다.