
식별 (Perception)
인공지능 : Elaine Rich 저서, 유석인.전주식.한상영 편역, 상조사, 1986 (원서 : Artificial Intelligence, McGraw-Hill, 1983, Artificial Intelligence (2nd ed, 1991)), Page 309~325
3. 제한 조건 만족 문제 - 왈츠 알고리즘 (Waltz Algorithm)
이 세계에는 많은 물체들이 존재하고 있다. 우리는 때때로 이 물체들의 각각이 무엇인지를 알고져 한다. 즉, 이는 이세계에 존재하는 여러 자료들을 분석하여 과연 그 자료들이 무엇을 나타내고 있는가를 알아내는 문제로 주어질 수 있다. 사람들은 이 세계의 여러 물체들을 식별하는 데에 다양한 방법들을 이용한다. 즉, 보고 (vision) , 듣고 (hearing) , 만지고 (touch) , 냄새를 맡고 (smell) , 또한 맛을 보기도 (taste) 한다. 이 여러 방법들 중에서 특히 인공 지능학에서 깊게 연구되는 것은 보고, 듣는 방법이다. 이 장에서는 이 두 방법에 대해 이때까지 연구되어 온 여러 결과들을 검토할 것이다.
물체를 식별한다는 것은 쉬운 일이 아니다. 왜냐하면, 첫째, 보든 물체 각각을 일반적이고 쉽게 판별할 수 있는 일련의 물체 형상 조건들을 정해야 되고 또한 이러한 조건들을 모든 물체 각각에 효율적으로 적용해야 되는 법이 필요하기 때문이다.
먼저 우리는 물체를 식별하는 문제가 무엇을 뜻하는지를 정확히 정의해 보고자 한다. 만일 우리가 음향파와 같은 일종의 신호를 감지했다면, 이는 즉 우리가 이 신호를 식별한 것이다. 그러나 이 시점에서의 식별이라는 것은 단지 그 신호에 대해 적절한 응답을 하는 최종 목적을 위한 첫 단계일 뿐이다. 적절한 응답을 산출키 위하여 우리는 첫째로 그 신호를 분류해야 한다. 전형적으로 이 분류하는 과정은 상하 수직 관계로 행하여 진다. 예를 들면, 어떠한 문장을 분석하는데 있어서, 우리는 첫째로 주어진 각각의 소리가 어떠한 것인가를 밝혀내고, 이 소리들을 일련의 단어들로 합성하고 마지막으로 이 단어들을 하나의 뜻이 있는 문장 산출을 위해 주어진 문장 구조에 합성하는 것이다. 길거리에 있는 한 장면을 식별하고자 할 때에는 우리는 먼저 그곳에 존재하는 모든 선들을 식별해 내고, 물체와 그들의 음영을 이루고 있는 모든 선들을 같이 놓은 다음에, 마지막으로 우리가 익숙해져 있는 집이나 마당들의 영상을 산출하기 위해 이러한 선들을 합성하는 것이다. 이와 같은 상하 수직 관계로 행해지는 과정은 우리가 모든 물체를 식별하고자 할 때 쓰여지는 상하 수직 관계와 일치한다.
불행하게도, 주어진 신호를 식별하는 실제적인 상하 수직 관계 과정은 우리가 위에서 묘사한 과정보다 더 복잡하다. 여기에 처한 많은 이유들이 있지만 첫째로 한 시점에서 행해지는 분류 과정이 그 시점 이하 또는 이상에서 행해지는 과정들과 서로 얽혀지기 때문이다. 다음과 같은 예에서 이를 쉽게 알 수 있다.
담화를 이루고 있는 일련의 신호들 중의 한 부분이 다음과 같은 소리들로 구성되어 있다고 가정에 보자:
k a t s k a r s
그러면 다음 단계는 이러한 소리들을 단어들로써 구성해 보는 것이다. 여기에는 적어도 두 가지 방법이 있다.
위와 같은 분류를 포함하는 문자의 구조에 대한 지식이 없이는 위 둘 중의 올바른 것을 가려내는 것은 가능하지 않다. 왜냐하면 다음과 같은 두 문장에서 보이는 것처럼 위의 둘 모두가 가능하기 때문이다.
The cat scares all birds away.
A cat's cares are few.
위 예에서 보이는 것과 같이 식별 과정의 한 시점에서 결정할 수 없는 문제가 영상처리 문제에서도 존재한다. 그림 1 을 생각해 보자. 이 시점에서 그림에서 존재하는 모든 선들이 식별되었다 하자 그러면 다음 단계는 이 선들을 이용하여 이 그림에 존재하는 여러 물체들로 합성하는 것이다. 허나 우리가 왼편으로부터 시작하여 A 로 수직선을 포함하는 물체를 지나서 보기 전에는 이 물체의 끝이 어디인지를 (이 예에서는 물체의 끝이 더 영장된다) 알 수가 없다.

그림 1
식별 처리에 있어서 두 번째 어려운 점은 주어진 신호가 가지는 여러 특성들의 상대적 현상이다. 이점이 식별처리에 있어 절대적인 패턴 매칭 (pattern-matching) 방법이 사용되어지지 않는 까닭이다. 예를 들면, 어떠한 두 사람도 똑같이 말하지 않는다. 실제로 동일한 사람이라도 주어진 단어를 똑같이 말하지 않는다. 그림 2 가 이를 예증해 주고 있다. 이는 "Alpha get's alpha beta" 를 말할 때에 첫 부분에 의해 산출되는 스펙트럼 (spectrum) 을 보여 주고 있다. 이 스펙트럼은 소리 에너지가 시간의 함수로써 어떻게 청각 주파수 범위에서 분포되어지는가를 보여 준다. 이 예에서 우리는 단어 'alpha'에 의해 산출되는 두 개의 다른 패턴을 볼 수가 있다. 영상처리에서도 역시, 단지 상대적인 측정만이 이루어질 수 있다. 예를 들면 그림 3 에서 보여지는 것과 같이 똑같은 장면을 나타내는 두 가지 다른 그림이 존재할 수 있다. 하나는 이 장면을 가까이서 본 것이고, 다른 하나는 멀리서 본 것이다.

그림 2 담화 처리 신호들의 차이점

그림 3
세 번째 중요한 관심사는 실제 세계에서는 한번에 한 신호를 식별한다는 것이 거의 가능하지 않다는 점이다. 담화 처리에 있어, 예를 들면 일련의 한 개의 단어들을 수긍할 수 있는 정확한 비율로 기계 처리한다는 것은 가능하다. 허나, 계속되는 담화에서, 일련의 단어들이 쏟아져 나올 때, 이 문제는 더욱 더 어려워진다. 이러한 문제점은 'cat scare' 예에서 이미 예증되어졌다. 이 문제점이 어떻게 어려워지는가를 보기 위해, 그림 4 와 같은 담화 파장을 생각해 보자. 이 그림은 담화 속의 단어들에 대한 각각의 소리와 그들이 어떻게 이루어져 있는가를 분석하고 있는데, 우리는 여기에서 'the' 와 'ower' 의 단어들 사이에 어떠한 뚜렷한 경계 기준이 없다는 것을 알 수 있다.

그림 4
유사한 문제점이 영상 처리 문제에도 일어나고 있다. 그림 5 가 단순한 선으로 이루어진 장면을 보여주고 있다. 그러나 이와 같은 단순한 예에서도 많은 물체들의 부분들이 다른 물체들에 의해 그 형상이 불확실시 되어지고 있는 것을 알 수 있다.

그림 5 다른 물체에 의해 불확실시 되는 문제
이러한 어려움에도 불구하고, 담화나 영상 처리를 위한 여러 방법들이 개발되어지고 있다. 담화 처리에 관해 개발된 여러 결과들이 [Reddy, 1976; Walker, 1976; Lea, 1980] 에 수록되어 있고 영상 처리를 위한 결과들은 [Winston, 1975b ; Brady, 1981 ; Marr, 1982] 에 있다. 이러한 분야들을 개발하기 위해, 전체 처리 과정을 몇 개의 준과정으로 나누는 것이 바람직하다. 우리는 여기에서 이러한 담화나 영상을 분석하는 과정을 다음과 같은 5개 준과정으로 나누어 본다.
위에 열거한 여러 과정들을 하나의 시스템 (system) 으로 합성하기 위한 한 방법이 8-2-2 절에서 주어진 흑판 (blackboard) 에서 보여진다.
흑판은 복잡한 상태에 있는 일을 처리하는데 유용한 하향성 (top-down) 그리고 상향성 (bottom-up) 인식 과정을 같이 이용할 수 있는 좋은 방법 중의 하나이다. 또한 이것은 인식 과정이 단순히 왼쪽에서 오른쪽으로 진행하는 것보다 좀더 불확실한 지역으로 향해 진행할 수 있도록 하여 주는 여러 지점들을 쉽게 이용할 수 있게 해준다. 처음의 쉽게 인식되어지는 부분을 아일랜드 (Island) 라 부른다. 이 방법은 상당히 유용한데, 왜냐하면 한 문장의 몇 단어들 (때때로 운이 좋으면, 대부분의 중요한 단어들) 은 똑똑히 발음이 되고, 나머지 단어들은 그렇지 않기 때문이다.
피상적인 분석 방법으로는 대부분의 식별 작업이 불가능한 정도로 너무 복잡하여진다. 입력의 각각 요소에 여러 가지 해석이 적용될 수 있어서 이러한 요소들이 결합될 때 생각되어지는 해석의 수는 너무나 많아진다. 허나 때때로 좀더 정확한 분석 과정을 통해 이러한 결합으로 생각되어지는 수의 많은 부분들이 실제적으로 일어날 수 없다는 것을 알아낼 수 있다. 이러한 자연적 제한들은 사용하는 방법의 복잡성을 다룰 수 없는 정도에서 추구할 수 있는 정도로 줄여주는 이해 과정에서 개발되어질 수 있다. 이 절에서는 식별 문제에 있어 이러한 방법을 사용하는 한 예를 볼 것이다.
문제 풀이에 있어 제한 조건 (constraints) 들을 이용하는데 두 개의 중요 단계들이 있다.
1. 주어진 문제를 분석하여 어떠한 제한 조건들이 있는가를 결정한다.
2. 1 단계에서 나온 제한 조건들을 효율적으로 이용하는 '제한 조건 만족 방법의 알고리즘' (constraint satisfaction algorithm) 을 적용하여 문제를 해결한다.

그림 6
이러한 단계들을 예증키 위해 선으로 구성된 그림을 명칭화하는 문제에 관한 왈츠방법 [Waltz, 1975] 을 검토할 것이다. 그림 6 에서 보여지는 그림을 생각해 보자. 이러한 그림이 입력으로 주어졌다고 가정하거나 또는 보다 더 낮은 단계의 과정이 주어진 입력 사진으로부터 이러한 선들을 산출했다고 가정해 보자. 분석 과정에서의 다음 단계는 이 선들이 묘사하고 있는 물체를 결정하는 것이다. 이를 위해 우리는 먼저 그림에서의 각각의 선을 다음들의 하나로써 지칭할 필요가 있다.
보다 더 복잡한 그림에 대해서는 대패질한 면들 사이의 뾰족한 틈 (cracks) 과, 그림자들과 뒷 배경 사이의 그림자-가장자리 (shadow edge) 등과 같은 또 다른 가장자리 모형들이 또한 생각되어질 것이다. 여기에서 설명하는 방법은, 실제로 이러한 또 다른 가장자리 모형들이 또한 생각되어질 것이다. 여기에서 설명하는 방법은, 실제로 이러한 또 다른 가장자리 모형들을 다루는 곳에서도 적용되어질 수 있다. 허나. 좀더 쉽게 설명하기 위해 단지 위의 세 가지 모형들에 대해서만 생각할 것이다. 실제로 우리는 세 개의 면들이 함께 만나 이루는 3 면체-각정 (trihedral vertice) 들로 형성되는 그림만을 생각할 것이다. 그림 7 은 이러한 그림의 예이고 그림 8 은 이러한 그림의 예가 아니다.

그림 7

그림 8
우리가 풀고자 하는 문제는 그림에 있는 각각의 물체를 인식하는 것이다. 이를 위해 우리는 먼저 그림에 있는 모든 선들을 명칭하여 어는 선들이 물체들 사이의 경계들에 해당하는가를 알고자 한다. 우리는 위에서 주어진 세 가지 선 모형들을 이용할 것이다. 경계선에 대해 그 선의 어느 쪽이 물체에 해당하고 그림 어느 쪽이 윗 배경에 해당하는가를 알기 위해 그 방향 제시를 필요로 할 것이다. 이는 주어진 선에 주어질 수 있는 네 개의 명칭들을 유도한다. 우리는 이 선 명칭을 위해 그림 9 에 주어진 네 가지 전형적 명칭 (label) 들을 이용한다. 이러한 명칭등의 예로써 그림 9 에 있는 각각의 선에 이러한 명칭을 붙이면 그림 10 과 같이 되어진다.

그림 9

그림 10
이러한 네 가지 선모형들을 가졌을 때 N 선들로 이루어진 그림들에 대해 명칭할 수 있는 가지 수는 4N 이 될 수 있다. 그 중의 어떠한 것을 정확한 것으로 고를 수 있을 것인가? 여기에서 관찰할 수 있는 중요한 점은 모든 각각의 선을 그의 끝에서 다른 선들과 함께 각정 (vertex) 을 이룬다는 점이다. 우리가 고찰하고 있는 상면체 그림에서는 가능한 모든 각정들을 만드는 데에는 단지 4 가지 형태들이 존재한다. 이러한 네가지 형태들은 그림 11 에서 보여진다. 90 도 미만의 뾰족한 각들과 90 도 이상의 뭉툭한 각들 사이에서는 차이점이 FORK 와 ARROW 사이를 구별해 주는 중요한 요인이 된다는 것을 제외하고는 각정의 돌려진 위치랄지 각정이 나타내는 각의 크기는 중요하지 않다. 만일 존재하는 여러 종류의 각정들에 대해 어떠한 제한 조건들이 있다면, 각정을 이루며 들어가는 선들에 대해 그 해당하는 제한 조건들이 있을 것이며, 결국 가능한 선 명칭들의 수는 그만큼 줄어들 것이다.

그림 11
그러한 각정 제한 조건들을 찾기 위해 우리는 먼저 네 가지 형상의 선들의 각각이 다른 선들과 각정에서 합쳐질 수 있는 최대 가지 수를 생각한다. 형사의 각정은 각각 4 개의 명칭들을 가질 수 있는 두 개의 선들을 포함하기 때문에 이러한 각정을 이루는데에는 16 가지 수가 있을 수 있다. FORK, T, 그리고 ARROW 형상의 각정들은 각각 3 개의 선들을 포함하기 때문에 이러한 각각의 각정을 이루는 데는 64 가지 수가 있을 수 있다. 이렇게 보면, 삼면체 각정을 이룰 수 있는 총 가지 수는 208 이 된다.
허나, 실제로 이러한 명칭들의 매우 소수 부분만이 실제의 물체를 나타내는 선 그림들에 존재할 수 있다. 이는 삼면체 그림의 한 각정을 이루고 있는 면들이 놓여 있는 평면 (plane) 들에서 보여진다. 이 3 개의 평면들은 분명히 3 차원 공간을 8 개의 부분 (각각 8 분호 (octant) 로 불리움) 들로 나눈다. 왜냐하면 각각의 면 (face) 이 이 공간을 반으로 나누고 어떠한 면도 파여져 있지 않기 때문이다. 즉, 삼면체 그림에서 일어날 수 있는 어떠한 각정도 공간을 몇 개의 (1 에서 8 사이) 메꾸어진 8 분호로써 나눈다는 것이다. 그래서 일어날 수 있는 모든 각정들의 명칭들을 찾기 위해 우리가 필요로 하는 것은 단지 8 분호들을 메꿀 수 있는 모든 방법들을 생각하고, 이렇게 메꾸어진 것들을 보는 방법들, 그리고 발견된 가정들의 형상들을 기록하는 것이다.

그림 12

그림 13

그림 14
이러한 과정을 예증하기 위해, 그림 12 에 보이는 그림을 생각해 보자. 이 그림은 A 각정의 면들에 해당하는 평면들이 교차되면서 이루어지는 8 개 8 분호들 중의 1 개를 포함하고 있다. 이 그림을 나머지 7 개 8 분호들의 각각으로부터 본다 하고, 그에 대한 A 각정의 형상과 명칭을 기록한다고 하자. 그림 13(a) 는 이의 결과를 보여주고 있다. 우리가 이 7 개 묘사되어지는 것들로부터 여기에 존재하는 약간의 변화있는 방향과 각도를 무시한다면 우리는 그림 13 (b) 에서 보여지는 것처럼 단지 3 개의 다른 현상들로 구별되어지는 것을 알 수 있다. 만일 우리가 이러한 과정을 물체를 메워 주고 있는 7 개의 8 분호들에 대해 (만일 모든 8 개의 8 분호들이 메워진다면, 각정은 존재할 수 없다.) 계속 행한다면 우리는 가능한 3 면체 각정들과 그들의 명칭들에 대한 환전한 일람표를 얻을 수 있다. ([Clowes, 1971] 에 서 개발된 것과 동일) . 이러한 일람표는 그림 14 에서 주어지고 있다. 우리가 말한 208 가지 이론적으로 가능한 명칭들 중에서 다니지 18 가지가 실제로 가능하다는 것을 주시하라. 이와 같이 하여, 우리는 실제 그림들에 존재하는 선들이 명칭될 수 있는 방법 위에 존재하는 커다란 제한 조건을 발견했다.
물론 이 시점에서 우리는 단지 단순한 삼면체 각정들이 명칭될 수 있는 방법
위헤 존재하는 제한 조건들을 발견했다.그림 8에서 보여지는 것처럼 많은 그림들이
비삼면체 각정들을 포함하고 있다. 더욱이 많은 그림들이 장면 묘사를 분석하는데
매우 큰 역할을 하는 그림자 영역을 포함하고 있다. 이러한 변화있는 요소들이 생각되어질
때 위의 18 개 각정 명칭들보다 더 많은 명칭들을 필요로 한다. 허나 이러한 요소들이
허용되어질 때 이론적으로 가능한 명칭 가지 수는 208 보다 훨씬 많아지는데 그러나
이론적으로 가능한 각정 수 대 실제적으로 가능한 가정 수의 비율은  보다 훨씬 적어 진다. 그러므로 이러한 방법은 보다 큰 규모의 문제에 확장되어질
수 있을 뿐만이 아니라 그렇게 되어야만 한다.
우리가 풀고자 하는 문제의 영역을 분석하여 그 영역에 존재하는 물체들이 만족하는 일련의 제한 조건들을 유도한 후에는 이러한 제한 조건들을 그 영역에 대한 입력을 분석하는데 적용할 필요가 있다. 이를 위해 우리는 3-6-7 절에서 설명된 '제한 조건의 만족 방법' 을 이용한다. 때때로 왈츠-알고리즘이라 불리우는 이 방법을 이루고 있는 주요 개념은 제한 조건들이 밝혀지는대로 그들을 적용하여 생각되어질 수 있는 모든 가능한 명칭들의 수를 되도록 줄여나간다는 것이다. 이를 위해 우리는 먼저 하나의 각정을 뽑아 그에 대한 가능한 모든 명칭들을 구한다. 그다음 우리는 그 옆의 각정으로 옮겨가서 그에 대한 모든 명칭들을 구한다. 우리가 처음 각정으로부터 두번째 각정까지 계속해서 구해진 선은 단지 한 개의 명칭으로 끝나는 것이 틀림이 없고, 이 명칭은 이 선이 들어가는 두 개의 각정들에 대해 절대 모순이 없다. 그래서 이 두 각정들의 하나에 주어진 어떠한 명칭도 그 다른 각정에 대해 모순이 된다면 이는 제거될 수 있다. 다음은 그 처음 두 개의 각정들에 인접한 또다른 각정에 명칭이 주어질 수 있다. 새로운 제한 조건들이 이 명칭으로부터 생각될 것이고 이러한 조건들은 이미 명칭화된 이 전의 각정들에 파급되어져서 이들 3 개의 각정들에 대한 가능한 명칭들의 수는 더욱 줄어들 것이다. 이러한 과정이 그림에 있는 모든 각정들이 명칭될 때까지 계속되어진다.

그림 15
한 예로써, 그림 15(a) 에 주어진 간단한 그림을 생각해 보자. 우리는 그림 15(b) 에서 보이는 것처럼 모든 경계 가장자리들을 명칭하는 것부터 시작한다. 그럼 각정들의 명칭화를 각정 1 에서부터 시작해 보자. 알려져 있는 선 명칭들과 모순이 없는 유일한 각정 명칭은 13 이다. 각정 2 에서는 유일하게 모순이 없는 명칭은 6 이다. 나머지 경계 각정들의 각각에 대해서도 역시 단지 1 개의 모순이 없는 명칭이 존재한다. 이러한 명칭들은 그림 15(c) 에서 가로로써 표현되고 있다. 이번에는 각정 7 을 생각해 보자. 단지 각정 7 을 보아서는 5 개의 FORK 명칭들 중의 어떠한 것도 가능한 것처럼 보인다. 허나, 우리가 각정 2 에 대해 발견한 유일한 명칭으로부터 각정 2 와 각정 7 사이의 선은 + 로 명칭되어야만 한다는 것을 알 수 있다. 이는 그 각정이 볼록한 각정을 나타내기 때문에 당연한 것이다. 이 사실을 이용하여 우리는 나머지 4 개의 가능한 FORK 명칭들을 제거할 수 있다. 이리하여 단지 명칭 (8) 만이 가능하다. 이와 같이 계산된 완전한 명칭화는 그림 15(d) 에서 보여진다. 이리하여 우리는 각정 명칭에 대한 제한 조건들을 적용하는 것에 의해 3 개의 볼록한 가장자리들에 의해 형성되어지고 있는 각정 7 을 알아냈다.
이제 우리는 명칭화-알고리즘 (the labeling algorithm) 을 좀더 자세히 열거할 수 있다. 이는 다음과 같다 :
|
명칭화 (Label) 1. 장면과 경계를 이루는 모든 선들을 발견하여 그들에게 명칭을 준다. 이러한 선들은 어떠한 각정들도 그 외부에 존재하지 않는 외부 선을 발견하는 것에 의해 주어질 수 있다. 2. 분석되어지는 그림들의 각정들에 일련 번호들을 매긴다. 이 번호들은 명칭화 과정에서 각정들이 명칭되는 순서에 해당한다. 다음과 같은 방법으로 번호를 결정한다 : 1) 그림의 가장자리에 있는 어느 한 각정으로부터 시작한다. 경계를 이루는 선들이 알려져 있으므로 그들을 포함하는 각정들은 내부에 있는 각정들보다 좀 더 제한 조건들이 많다. 2) 그 각정으로부터 인접해 있는 번호가 주어지지 않은 각정을 따라 움직여서 모든 가장자리 각정들에 번호들이 주어질 때까지 계속한다. 3) 번호가 주어진 각정으로부터 인접해 있는 번호가 주어지지 않은 각정으로 움직이는 것에 의해 내부 각정들에게 번호들을 준다. 언제든지 이미 명칭이 주어진 각정의 옆에 있는 각정을 명칭하는 것에 의해 제한 조건이 최대한으로 이용되어질 수 있다. 3. 각각의 각정 V 을 순서대로 찾아가서 다음과 같은 방법으로 명칭을 준다 : 1) 그림 14 에 주어진 일련의 가능한 각정 명칭들을 이용하여 V 에 대한 가능한 명칭들을 유도한다. 2) 부분적 (local) 제한 조건들을 이용하여 이들 명칭들 중에 제거될 수 있는 명칭들이 있는지를 본다. 이를 위해 V 에 인접해 있고 이미 방문되어졌던 각각의 각정 A 를 조사한다. V 에 대한 각각의 가능한 명칭에 대해 A 에 대해 주어진 가능한 명칭들 중에 적어도 한 개가 V 와 A 사이에 존재하는 선을 명칭할 수 있는가를 본다. 이러한 것이 가능치 않은 모든 명칭들을 V 를 위한 일련의 가능한 명칭들로부터 제거한다. 3) V 에 주어진 일련의 가능한 명칭들을 이용하여 V 와 인접해 있는 각정들을 위한 명칭들을 제한한다. 지난번 단계에서 방문되어진 각각의 각정 A 에 대해 다음과 같이 행한다. ① A 에 대한 각각의 명칭에 대해 만일 이것이 V 에 대한 명칭들 중의 적어도 1 개와 모순을 일으킨다면 이를 A 에 대한 가능한 명칭들로부터 제거한다. ② 만일 어떠한 명칭들이 제거되어졌다면 A 에 인접해 있는 각정들을 조사하여 이제 A 에 주어진 보다 제한된 일렬의 명칭들과 모순이 있는지를 본다. ③ 이러한 과정을 계속하여 모든 인접해 있는 각정들에게 명칭들에게 주어지게끔 하거나 또는 현존하는 일련의 명칭들에게 더 이상의 변화가 일어나지 않게끔 한다. |
이 알고리즘은 주어진 그림에 대해 존재하는 유일하고 정확한 명칭들을 언제든지 발견할 것이다. 그러나 만일 그림이 애매모호하다면 이 알고리즘은 적어도 한 각정이 두 개 이상의 명칭들을 가지고 끝날 것이다.
실제로 왈츠 (waltz) 에 의해 설명된 것처럼 이 알고리즘은 뾰족한 틈이나 그림자들을 포함하는 보다 복잡한 그림들에 적용되어졌었다. 허나, 이 알고리즘은 이용되는 각정 형상들의 일람표에 관계없이 여전히 잘 행하여질 수 있었다. 실제로, 지난 절에서 암시한 바와 같이 이 알고리즘의 유용성은 문제 영역의 크기가 증가함에 따라 같이 증가해서 이론적으로 가능한 각정 가지 수에 대한 실제적으로 가능한 각정 수의 비율은 줄어든다. 예를 들면 왈츠-알고리즘은 그림에서 그림자 선들로 부분적 (locally) 으로 나타내는 그림자 정보를 전체적 (glabally) 인 제한 조건에 적용하는 방법으로써 이용했다.
이 장에서 우리는 식별 작업을 하는데 따른 주요 어려움들을 열거했다. 그 다음 우리는 이러한 어려움을 극복하는 하나의 방법으로써 제한 조건 만족 문제 방법을 이용할 수 있다는 것을 설명했다.
때때로 담화나 영상 처리에 관한 문제들은 어느 특정한 작업을 푸는 단독 프로그램 작성에 있어 중요하다. 허나 이들은 또한 로보틱 (robotics) 이라 불리우는 분야에서 중요한 역할을 담당하고 있다. 로보틱 분야는 그의 최종 목적으로써 어느 정도 자율적으로 행동할 수 있는 지능있는 로보트를 구성하는 분야이다. 이러한 로보트를 위해 식별하는 능력은 필수적이다. 로보트 분야와 관련된 이론들은 [Paul, 1981] 에서 소개되고 있다. 산업 분야에서의 로보트 응용에 관해서는 [Engelberger, 1980] 에서 거론되고 있다.
1. 담화 처리와 영상 처리의 작업들 간의 상존하는 5 개의 문제점들을 열거하라.
2. 복잡한 식별 패턴을 이해하는데 어려운 여러 이유들 중의 하나는 만일 패턴이 2 개 이상의 물체들로 구성되어 있다면 여러 종류의 예측하기 어려운 현상들이 물체들 사이에서 일어날 수도 있기 때문이다. 예를 들면 "Could you go?" 라는 절이 말해졌을 때 j 라는 소리가 Could 와 you 라는 두 단어들 사이에서 일어난다. 담화에 있어 이와 같은 현상이 일어나는 다른 예를 들어라. 또한 영상에 있어 그러한 예를 들어라.
3. 다음 그림들 중의 어떠한 것이 3 면체 그림인가?
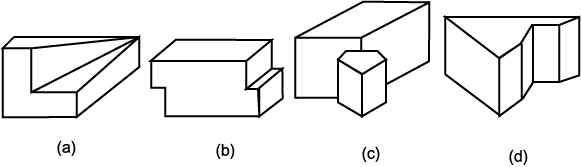
4. 3 절에서 평면들의 교차로 이루어지는 공간의 1 개의 8 분호를 차지하는 삼면체 물체의 각정이 명칭되는 모든 방법들이 분석되어졌다. 7 개 8 분호들을 통해 2 개를 차지하는 물체들의 각정에 대한 이러한 분석법을 생각해 보라.
5. 그림 7 에 있는 각각의 그림에 대해 왈츠-알고리즘이 어떻게 명칭을 주는 지를 보여라.
6. 왈츠-알고리즘을 설명할 때에 우리는 먼저 각각의 각정 V 에 대해 그에 관해 주어질 수 있는 모든 명칭들을 찾아냈다. 그 다음 우리는 V 와 관련된 일련의 명칭들을 제한하기 위해 모든 인접해 있는 각점들을 조사했다. 그 다음 우리는 각각의 인접한 각정 A 에 대해 V 에 관한 알고 있는 정보가 A 에 대한 명칭들을 좀더 제한할 수 있는데 쓰일 수 있는지를 검토했다. 왜 우리는 단순히 각각의 인접한 각정을 한번에 방문하여 이러한 단계를 행할 수 없는가?
7. 왈츠-알고리즘이 유일한 명칭을 줄 수 없는 애매모호한 그림의 일예를 들어라.