하드웨어와 정보
컴퓨터와 인간지능 : Donald G. Fink 저, 이기호 역, 이화여대 출판부, 1986, Page 125~144
일반적인 개념으로는 컴퓨터란 빠른 속도의 계산기라고 하는데 이 견해는 부분적으로만 옳은 말이다. 컴퓨터는 사실상 정보를 조직하고 변형시키기 위하여 잘 정의된 과정을 수행할 수 있는 일반적인 기호처리 기구이다. - 파이겐 바움 (E. A. Feigenbaum) 과 펠드만 (Julian Feldman)
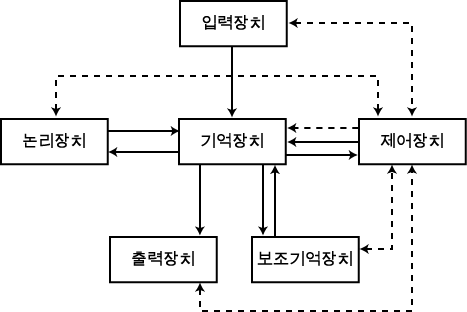
이제 컴퓨터 시스템의 "작업" 이 컴퓨터 하드웨어가 프로그램이 제공하는 입력 정보를 어떻게 받아들이는지 궁금해진다. 즉 정보를 어떻게 통과시키며 어떻게 그것을 식별, 계산, 저장, 조절하는지 그리고 마지막 결론을 어떻게 제시하는지 궁금한 것이다. <그림 1> 은 컴퓨터 시스템의 여섯 개 기본장치를 나타낸다. 이 그림에서 직선은 주정보 (subject matter information ; 초기 자료, 중간 결과, 그리고 답) 의 길을 나타낸다. 점선은 제어 정보 (control information ; 컴퓨터로 하여금 프로그램을 수행하게 하는 "내부의" 정보) 의 길을 나타낸다.
그림 1 컴퓨터 시스템의 기본적 장치. 직선은 데이터나 지시 등과 같은 계산의 일을 나타내고, 점선은 제어장치로부터 혹은 제어장치로 가는 제어정보의 흐름을 나타낸다.
제 3 장에서는 컴퓨터가 정보를 어떻게 다루는지에 대해 일반적인 고찰을 하였다. 제어장치 (control unit) 는 컴퓨터 시스템의 "주요한 부분 (master-mind)" 이다. 그것은 프로그램에 의해 제공되는 외부의 지시를 인식하고, 각자의 임무를 수행하기 위해 다른 장치를 가리키는 내적인 지시들을 만든다. 기억장치 (memory unit) 는 자료와 지시의 중앙 저장소이다. 즉 그것은 지시된 것과 같은 자료와 명령을 저장하고 검색한다. 논리장치 (logic unit) 는 논리와 산술적인 기능을 수행하면서 자료를 변형시킨다. 입력장치 (input unit) 는 컴퓨터의 외부로부터 (컴퓨터의 "주위") 자료와 지시, 정보를 컴퓨터로 옮긴다. 출력장치 (output unit) 는 주위 (enviroment) 에 정보를 준다. 그것은 오퍼레이터로 하여금 컴퓨터의 작업을 감시하도록 하며 답을 인쇄한다 (혹은 천공시킨다).
문제가 주어질 때 사람들이 수학의 표에서 값을 찾아보거나 모르는 단어를 사전에서 찾는 것처럼, 컴퓨터는 명확히 진술되지 않은 정보를 프로그램에서 "찾는다." 그러한 정보는 외부에 있는 기억장치 (external storage unit) 에 의해 컴퓨터에 제공된다. 정보가 주기억장치에 저장하기에 너무 많거나 복잡하다면 계산하는 동안에 생기는 정보를 외부에 있는 기억장치에 저장시켜야 할지도 모른다. 외부에 있는 기억장치는 대체로 주기억장치보다 훨씬 많은 용량을 갖는게 보통이다. 즉 사실상 테이프나 천공카드를 필요에 따라 늘림으로써 기억장치의 용량은 무한히 확장될 것이다.
전형적인 계산에 연산은 다음과 같은 주요한 단계를 포함한다. 즉 입력장치는 천공카드나 혹은 테이프의 형태로 된 프로그램을 가진다. 시작 단추를 누르면 제어장치는 입력장치로 하여금 카드나 테이프를 "읽도록" 지시하고, 프로그램 데이터와 지시를 프로그램에 명시된 위치의 저장시키는 기억장치에 옮기도록 지시한다. 입력장치는 프로그램의 마지막 자료가 읽혀졌을 때 제어장치에 신호를 보낸다.
그러면 제어장치는 첫째 지시사항은 읽고 그 뒤에 오는 다른 장치를 가리킨다. (이런 연산은 대표적으로 기억장치에서 논리장치의 레지스터 (임시 기억장치의 교호 접속회로의 모임) 로 자료를 옮기는 것을 포함하고, 계속해서 데이터에 지시된 연산을 수행하기 위해 논리장치에 보내는 명령과, 기억장치나 다른 레지스터 내에 있는 저장소에 관한 프로그램 안에서 명백히 설명되거나 또는 지시 내에서 정한 단어에 의해 수행되는 "표준" 연산이 된다 ("add" 를 위한 명령 안에 포함되는 것처럼).
첫째 지시가 완료되면, 프로그램 계수기는 하나가 수행되었다는 것을 기록하고 제어장치가 둘째 것을 읽기 위해 기억장치로 되돌아 오면, 그것이 수행되고 기록하게 된다. 그렇게 해서 이와 같은 과정은 마지막 지시가 수행될 때까지 계속된다.
이 과정의 어느 단계에서 제어장치는 무엇이 진행되고 있는지 오퍼레이터에게 알려주는 출력장치를 부른다. 이것은 중간 또는 마지막 과정에 저장되어 지시가 그것을 인쇄하도록 명령할 때마다 나타난다 (부정확한 패리티 비트, 부적당한 지시, 일관성이 없는 논리, 그리고 레지스터나 혹은 기억장치에 있어서 장소의 부족과 같은). 잘못이 제어장치에 탐지되면 제어장치는 계산하는 것을 중지시키고, 이것을 오퍼레이터에게 알리기 위해 출력장치를 지시한다. 대체로 대수롭지 않은 오류 (error) 는 출력 인쇄기나 혹은 라벨에 이해 명시된다.
만약 오퍼레이터가 어떤 기억장소에 기억된 데이터의 정확여부를 확인하고자 한다면 오퍼레이터는 (단추를 누르거나 혹은 콘솔 타이프라이터에 보조 지시를 타이핑함으로써) 그 위치의 내용을 인쇄하도록 지시할 수 있다. 기억된 프로그램 하나하나의 요소와 자신의 프로그램에서 대응하는 요소를 비교하기 위해 기억된 전체 프로그램이나 다른 모든 것을 인쇄하도록 지시하기도 한다. 오류가 있을 때는 (정확한 데이터, 지시, 기억장소 등에서 타이핑에 의해 정확하게) 오퍼레이터는 잘못이 발견되었던 곳으로부터 계산을 다시 하도록 제어장치를 지시한다.
컴퓨터 오퍼레이터와 프로그래머들은 많은 시간을 오류를 찾고 고치는 데 소비해야 한다. 이것을 "결함 제거하기 (debugging)" 라 하는데 계산하는 시간보다도 훨씬 더 많은 시간이 걸린다. 프로그램에서 결함을 제거하는 데 걸리는 시간과 지리함을 덜기 위해 오류가 있는 곳과 오류의 성질을 찾고 나타내는 컴퓨터 자체 사용 기술이 개발되어 왔다. 이런 절차는 "기계보조 프로그래밍 (machine-aided programming)" 이라고 한다. 다음 장에서 설명하겠지만 이런 기술은 오류를 고칠 뿐만 아니라 프로그램을 조립하거나 다른 부호로 번역하는데 사용되는 매우 좋은 도구이다.
정보는 컴퓨터 연산에서 기계적인 형태, 전기적인 혹은 자기적인 형태로서 필수적으로 있어야 한다. 컴퓨터 장치의 하나가 정보를 읽으면 다른 것은 그것을 제시한다. 어떤 것이 정보의 의미를 인식하면 다른 것은 그것을 조작하고 옮긴다. <그림 1> 에서 화살표의 흐름이 보여주는 것처럼 모든 단말장치는 정보를 옮긴다. 정보는 전류의 흐름에 따라서 컴퓨터의 단말장치 사이에서 옮겨진다. 전류는 지속시간이 10 억 분의 몇 초밖에 안 되는 매우 짧은 펄스 (pulse) 라는 전류 내에서 흐른다. 특정한 때에 그런 펄스가 있다는 것은 비트 '1' 을 나타내고 없는 것은 비트 '0' 을 나타낸다.
컴퓨터 언어의 문자는 문자를 나타내는 코드에 따라서 결정된 펄스가 있는 것 (1) 과 없는 것 (0) 의 모임 ("string") 에 의해 표현된다. 그런 숫자에서 각 비트의 위치는 "펄스 위치 (pulse site)" 라고 불리운다. 즉, 펄스가 있는지 없는지가 발견되는 곳이다. <그림 2> 는 영숫자 (mnemonic character) 11110011 (모델 1401 언어에서 C 를 나타낸다) 에 대한 펄스가 자리를 보여준다. 직선의 펄스는 1 들이고, 점선 (부재의) 펄스는 0 들을 나타낸다.
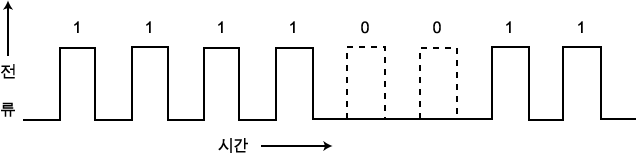
그림 2 수 11110011 을 나타내는 펄스 체인.
문자를 나타내는 비트들은 하나씩 옮겨지거나 ("순서적으로"), 또는 한 묶음으로 함께 옮겨진다 ("나란히"). 하나의 회로가 순서적으로 펄스를 옮길 수 있는 반면에, 펄스들이 한 묶음으로 나란히 옮겨질 때엔 각 비트에 분리된 회로가 제공되어야 한다. 결국 비트들이 나란히 한꺼번에 다루어지면 옮겨지는 속도도 빨라진다. 그러나 그것에 상응하여 더 많은 회로가 요구된다. 연속적이냐 혹은 한꺼번에 옮기는냐의 선택은 속도와 복잡성 중 컴퓨터의 능력과 비용의 경제적인 균형을 이루려는 고안자에 의해 결정되는 선택의 문제이다.
컴퓨터 프로그램에서 주어진 연산은 앞의 연산이 완료될 때까지 시작해서는 안 된다. 동기적인 (synchronous) 컴퓨터에서는, 상당히 속도가 빠른 전기 시계가 백만 분의 몇 초의 순서로 들어오는 시간 간격을 재고, 그리고 하나의 연산은 앞의 연산을 위해 필요한 시간이 지날 때까지 시작하지 않는다. 비동기적인 (asynchronous) 컴퓨터에서는 어떤 시계도 필요치않다 ; 대신에 각 컴퓨터 장치는 연산이 완료되었을 때 "앞으로 (go-ahead)" 란 신호를 보낸다. 이 신호는 다음 연산의 수행을 시작하라는 것이다. 이 두 가지 방법 중의 선택은 복잡성과 속도의 균형 문제이다. 동기적인 컴퓨터는 하나의 시간 간격이 완료될 때까지 기다려야 하는 시간 소비가 있는 반면, 비동기적인 컴퓨터는 각 연산에 실제로 요구되는 시간을 맞춘다.
인간으로부터 컴퓨터로 정보를 옮기는 것은 거의 키보드 (keyboard)(주석 : 이런 점에서, 컴퓨터는 인쇄되는 단어의 방법들을 선택했다. 키보드는 책, 잡지, 신문, 보고서 그리고 편지 등을 쓰는 데 사용된다. 정보의 양은 조정하기에 너무 방대하다.) 에 의한다. 컴퓨터와의 커뮤니케이션은 각 키 (key) 의 문자를 옮기는 전신타자기 ("콘솔 키보드") 의 글자판을 통해서 제공된다. 키들이 차례로 눌러지면 펄스 스트링이 연속해서 뒤따르고 이것들은 타이핑의 내용이 지시하는 것처럼 컴퓨터의 다른 장치로 들어간다. 컴퓨터에 입력 정보를 집어 넣는 일은 이 타자기로 할 수 있다. 그러나 손으로 타이핑하는 것이 너무 늦기 때문에 이것은 현실적으로 불가능하다. 1 분에 50 개 단어를 빠른 속도로 타이프하더라도 콘솔 타자는 1 초당 50 비트 정도만 펄스 스트링으로 만들 수 있다. 그러나 빠른 컴퓨터내에서 다른 장치들은 1 초당 몇 백만 개의 비트들을 다룰 수 있도록 고안된다. 콘솔 타자기는 프로그램을 중지시키고 계산을 지켜보고 오류를 찾아서 고치며 일반적으로 오류가 발생하는 따위의 예기치 않은 사태를 위해 필요하다.
이미 알고 있듯이 입력 정보는 (즉, 프로그램의 자료와 지시 그리고 외부의 저장소에서 뽑을 수 있는 다른 자료들) 빠른 속도로 컴퓨터에 옮겨질 수 있도록 중간 기억장치로 먼저 옮겨진다. 이 과정은 값비싼 컴퓨터 시간을 절약할 뿐만 아니라 입력 정보를 영구적으로 기록한다.
가장 많이 사용되는 중간 기억장치의 매체는 천공된 카드이다 (그림 3).

그림 3 홀레리스 (Hollerith) 코드를 사용한 전형적인 펀치 카드. 맨 위에 있는 부호들은 그것 바로 아래에 천공된 구멍들에 의해서 표현된다.
카드는 직사각형의 구멍이 천공되는 960 개의 자리 ("위치") 를 갖는다. 이 960 개는 각 행 12 개씩, 80 개의 열로 정돈된다. 한 열에는 하나 혹은 그 이상의 구멍들이 하나의 문자를 나타낸다. 한 개의 구멍은 10 진수를 나타내며 두 개의 구멍이 뚫리는 것은 문자들, 그리고 1, 2, 혹은 3 의 구멍들은 각각 부호들을 나타낸다. 문자를 나타내는 구멍의 각 형태는 물론 다르다. 이 코드를 사용하여 80 개의 문자들이 한 카드에 수용될 수가 있다. 다른 코드는 정보를 카드 위에 더욱 많이 채워지도록 한다.
구멍들은 키펀치 (keypunch) 라고 하는 기계 내에서 만들어진다. 기계의 판 위에 있는 각각의 키가 쳐지면 키 위의 문자에 해당하는 코드가 천공된다. 그러면 카드는 다음 열로 옮겨진다. 80 개 열 모두 천공되면 카드는 자동적으로 옮겨져 쌓이고 새 카드가 내려온다. 그리고 정보가 카드에 천공이 될 때까지 그 동작은 계속된다.
다른 기억 매체로는 원래 정보 전달을 위해 고안된 종이 테이프가 있다. 대표적인 종이 테이프는 일곱 개의 구멍에 대한 자리를 갖는데 그것은 테이프를 가로지르는 열 안에서 정돈된다. 테이프 키펀치에 의해 생기는 둥근 구멍은 키보드에 문자를 나타내는 형식으로 자리를 잡는다. 각 키를 누르면 그 문자에 대한 구멍이 천공되고 테이프는 다음 열로 간다.
천공 카드와 종이 테이프의 가격은 비싸지는 않지만 그것들은 1 평방인치당 제한된 수의 구멍만 수용할 수 있다. 정보는 자기 테이프에 더 많이 조밀하게 채울 수 있다. 그리하여 이런 형태의 중간 기억매체는 긴 프로그램이나 많은 자료를 취급해야 할 때 사용된다. 컴퓨터를 위한 자기 테이프는 녹음기에서 사용되는 것과 원리가 비슷하지만 컴퓨터 테이프가 더 넓게 더 섬세하게 만들어졌다. 자기 테이프의 배열은 종이 테이프와 유사하다. 즉 열은 테이프의 길이에 수직이 되게 가로로 배열되었다. 자기 테이프의 기록하는 헤드 (head) 는 몇 개의 구획 (section) 을 갖는데 그것들 각각은 1 들이나 혹은 0 들을 나타내는 자리를 자기화할 수 있다.
자기 테이프의 큰 이점은 높은 용량을 제외하고는 자기 테이프의 내용을 지울 수 있다는 것이다 ("erase head" 로 자기를 제거한다). 따라서 오류를 정확히 고칠 수 있으며, 이미 최신의 것으로 된 오래된 정보나 혹은 전체 테이프는 어떤 계산이 끝난 후 지워서 사용할 수 있다.
고밀도 자기 테이프 20 인치의 한 롤 (roll) 은
 비트를 저장할 수 있다. 그런 배열 내에 있는 특정한 문자나 단어를 합리적인
시간 내에 발견하기 위해서는 그 테이프가 더 빠르게 움직이고, 테이프 자체에 해를
주지 않으면서 정확하고 빠르게 멈출 수 있어야 한다. 이런 기능을 하는 테이프는
이것의 설계에 함께 협력해 온 기계와 전기 기술자들의 노력에 의한 결과이다.
자기 테이프는 적당히 자기화된 전류를 기록장치 부분에 적용하는 키보드로 자기화될 수 있다. 대체로 천공된 카드가 먼저 만들어지고, 그리고 이들은 분리된 작업으로 테이프에 옮겨진다. 카드나 혹은 테이프에 손으로 타이프를 쳐서 느린 속도로 씌여진 정보 기록은 빠른 속도로 컴퓨터에 적당하게 옮겨진다. 천공 카드 위에 있는 정보는 카드 리더 (card reader) 에 의해 옮겨진다. 카드는 각 열 (column) 의 구멍 형태가 결정될 수 있도록 위치가 정해진다. 구멍이 있고 없음은 금속으로 된 손가락으로 탐지된다. 천공되지 않은 카드는 그 손가락이 카드 밑에 있는 금속판에 전류를 흐르게 하는 것을 막는다. 구멍이 있을 때 손가락은 금속판과 전기적인 접촉을 하고 전류를 흐르게 한다. 12 개의 손가락이 각 열에 제공된다. 어떤 특정한 손가락과 구멍과의 만남에 따라 전류는 손가락에 연결된 12 개의 회로 중 하나 혹은 그 이상에 흐르게 된다. 이 전류는 문자들을 나타낸다. 단지 12 개의 손가락에 의해 카드는 한 열씩 순서적으로 읽혀진다. 또는 960 개의 손가락에 의해 한꺼번에 읽혀질 수도 있다. 카드를 읽는 것이 손으로 타이프를 치는 것보다 빠르지만 아직은 컴퓨터 표준에 의해서 속도가 매우 느리다. 많은 양의 입력 정보를 취급할 때는 카드 전체를 한꺼번에 나란히 읽는 것이 더 유리하다. 입력 수행에서 소비된 시간이 중요하지 않을 때는 한 열씩 읽는 것으로 충분하다.
카드는 구멍이 있는 자리에서 빛을 발하는 광선으로써 읽혀진다. 구멍이 있을 때 빛은 전류가 만들어진 광전자관으로 통과한다. 이런 작업은 손상되는 것을 보호해 줄 분만 아니라 매우 빠르다. 병렬 광선감지기를 사용하면 카드 리더는 분당 2,000 장 정도의 카드를 읽고, 초당 최대한 20,000 비트 정도를 읽을 수 있다. 종이 테이프는 손가락이나 광선을 사용하는 것과 비슷한 방법으로 한 열씩 또는 몇 개의 이웃한 행을 한 단위로 한꺼번에 읽을 수 있다.
자기 테이프는 "리딩헤드 (reading-head)" 를 사용해서 읽는다. 이 장치는 레코딩 헤드 (recording-head) 와 비슷하다. 그것을 각 열에서 자기화될 수 있는 각 자리마다 여러 부분으로 나눈다. 자기화된 자리가 헤드의 한 부분을 지날 때 그 자리가 1 을 나타내도록 자기화된다면 어떤 한 방향으로 전류가 유도되고, 0 을 나타내도록 자기화된다면 그 반대 방향으로 유도된다. 그 자리들은 매우 조밀하게 채워지기 때문에 한 번에 하나의 열만을 읽는 것이 실제적이지만 한 열에 있는 모든 자리들이 (보통) 한꺼번에 읽혀진다.
카드나 테이프 리더 (tape reader) 로 만들어진 전류들은 보통 컴퓨터에는 적합하지 않으므로 컴퓨터의 장치들이 알아서 조작할 수 있는 비트 코드로 바꿔야 한다. 키보드 부호들이나 구멍의 형태를 컴퓨터 코드로 바꾸는 과정이 부호화하기 (encoding) 이다.
|
10 진수 |
2 진수 |
|
0 1 2 3 4 5 6 7 8 9 |
0000 0001 0010 0011 0100 0101 0110 0111 1000 1001 |
콘솔 타이프라이터의 숫자들을 살펴보자. 이들 10 진수를 그것들과 같은 2 진수로 바꾼다고 가정하자.
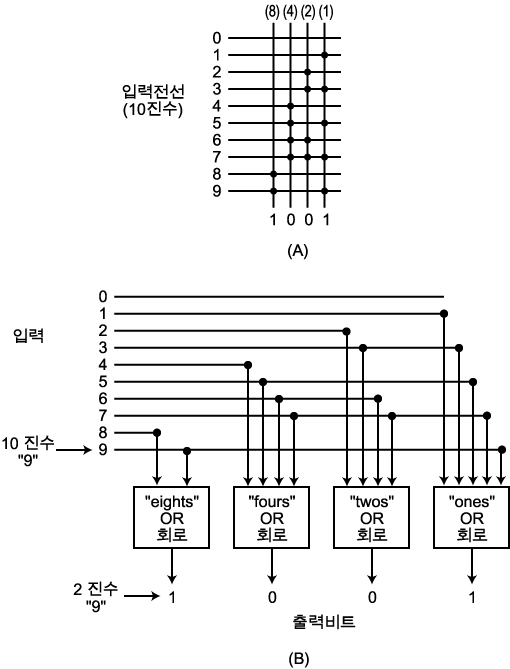
그림 4 부호화 회로. (A) 10 진수를 동등한 2 진수로 부호화하는 일반적인 형태를 나타낸다. (B) 4 개의 "혹은 (or)" 회로들을 이용한 특별한 회로이다. 화살표는 10 진수 9 를 2 진수 1001 로 부호화하는 것을 보여준다.
네 개의 출력 전선에 의해 교차된 입력 전선들은 이 표로 나타낼 수 있다 (그림 4-A). 입력 전선은 0 에서 9 까지의 숫자 키에 연결된다. 네 개의 출력 전선들은 그것과 동일한 2 진수의 4 개의 비트를 나타낸다.
교점에 1 비트나 나타나는 곳에 화살표로 표시한다.
따라서 만약 9 의 입력 전선에 전류가 흐르면, 그것과 같은 2 진수의 첫 번째와 네
번째 비트에 1 들이 나타나야 한다 ( ).
표를 살펴보면 1, 3, 5, 7 혹은 9 의 10 진수 전선에 전류가 흐를 때는 가장 오른쪽 비트가 1 이라는 것이 나타난다. 마찬가지로 4, 5, 6 혹은 7 에 전류가 흐를 때는 왼쪽에서 두 번째 비트가 1 이다. <그림 4-B> 에 나타나는 것처럼 연결된 4 개의 "혹은" 회로는 10 진수를 2 진수로 코드화할 것이다.
"혹은 (or)" 회로로 구성된 비슷한 회로들은 어떤 자연 언어 문자를 비트로 코드화할 수 있다. 모델 1401 언어에서 (제 4 장), 64 개의 문자와 부호들은 각각 8 개의 비트를 갖는다 (단어 표시와 패리티 비트를 포함해서) ; <그림 4-B> 의 방법 뒤에 8 개의 "or" 회로에 적당히 연결된 64 개의 입력 전선을 갖는 회로는 8 개의 출력 전선에 비트 코드를 만든다.
이와같이 코드화하는 회로들은 (부호화 회로) "다수를 위한 하나 (one-for-many)" 의 장치이다 ; 즉, 하나의 입력 전선만이 각 문자에 전류를 통과시키는 반면, 많은 출력 전선들은 그 하나의 입력에 의해 전류가 흐르게 된다. 더 복잡한 회로들은 여러 개의 입력 전선에 있는 몇 개의 문자 ("단어" 를 받아들이며 더 큰 수의 출력 전선에 출력 비트들을 제공함으로써 "다수를 위한 다수 (many-for-many)" 를 기초로 코드화할 수 있다.
비트코드에서 문자로 옮기는 반대의 과정을 부호 해독 (decoding) 이라 하고, "하나를 위한 다수 (many-for-one)" 의 과정이다. 여러 개의 입력 전선들은 문자를 나타내는 비트들을 받아들이고, 하나의 출력 전선은 그것에 일치하는 문자가 있다는 것을 지시한다. 2 진수로부터 이와 동일한 10 진수로 부호를 해독할 때 앞에서 주어진 표를 사용한다. 오른쪽 열은 입력을 나타내며 왼쪽 열은 출력이다. 적절한 회로는 "그리고 (and)" 회로인데 이것은 모든 입력이 1 일 때만 1 인 출력을 만든다. 각각의 입력은 1 혹은 0 이기 때문에 적당한 자극이 0 인 각각의 입력에 부정 회로를 주어야 한다.
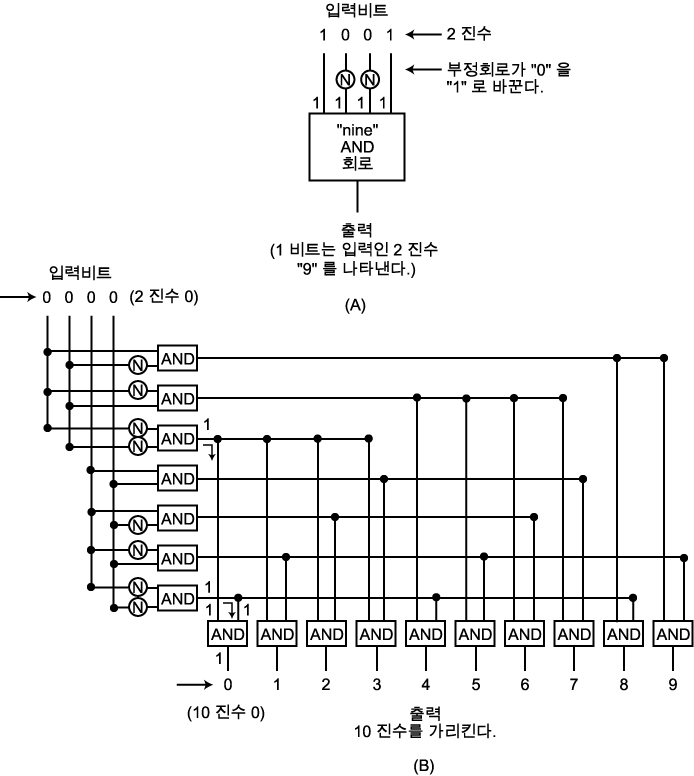
그림 5 부호 해독 회로. (A) 기초적인 "그리고 (and)" 해독 장치. (B) 17 개의 "그리고 (and)" 회로와 8 개의 "not" 회로들을 사용한 특별한 회로. 화살표들은 2 진수 0000 을 10 진수 0 으로 해독하기 위한 길을 보여준다.
예에서처럼 2 진수 1001 을 10 진수 9 로 해독하는 <그림 5-A> 에 대해서 생각해 보자. 가운데 두 개 입력은 0 이다. 이것들은 부정 회로에 의해 1 로 바뀐다. 1001 로 4 개의 입력 전선에 적용될 때 "그리고" 회로는 1111 을 받아들이고 문자 P 가 있다는 것을 나타내는 출력에 1 을 만들어낸다. 2 진수를 10 진수로 해독하는 과정은 <그림 5-B> 에 나타난 회로에 의해 수행이 되는데 그것은 입력 비트를 위한 8 개의 부정 회로에 의해 추가되는 7 개의 "그리고" 회로를 사용하며 10 진수로 출력을 내기 위해 10 개의 "그리고" 회로들을 사용한다. 예를 들면, 이 회로에서 입력 0000 (2 진수 "0") 은 "그리고" 회로의 입력에서 부정 회로에 의해 1111 로 바뀐다. 이들 비트들은 출력 "그리고" 회로에 0 으로 고정된다. 그런데 이것은 10 진수 0 이 있다는 것을 나타내기 위해 그것의 출력에 1 을 나타낸다. "그리고" 회로들을 더 복잡하게 배열함으로써 몇 개의 문자 (a "word") 를 한꺼번에 해독할 수 있다. 이것들은 단어 내에 있는 비트들만큼이나 많은 입력 전선들을 가지고 각 단어에 대해 하나의 출력 전선을 갖는다.
부호화 회로와 부호해독 회로의 조합은 제어장치에 의해 외부로부터의 지시를 인지 (recognition) 하여 다른 장치를 위한 내부 지시를 만들어내는 기본적인 컴퓨터 기능을 수행할 수 있다. 지시에 있어서 첫 번째 단어는 ADD, SUB, 혹은 DIV 와 같은 연산을 위한 영숫자 (mnemonic) 생략형이다. 연속적인 비트들로 기억장치 속에 이미 부호화되어 저장된 지시는 제어장치 내에 있는 레지스터에 옮겨지는데, 그것은 개별적인 교호 접속회로 내에 비트들을 갖는다. 각 교호 접속회로의 조건은 (0 혹은 1) 부호 회로의 입력 전선에 연결된 것에 의해 나타나는데, 그것은 ADD, SUB, MUL 그리고 DIV 를 위한 비트 코드에 반응되도록 고안되었다. 부호 해독기는 이들 각 단어에 하나씩 4 개의 출력 전선들을 갖는다. 따라서 만약 레지스터가 ADD 에 해당하는 비트를 지닌다면, ADD 출력 전선들은 1 을 만든다. 이 비트가 있는 것은 가산 지시를 인지했음을 나타낸다. 다른 세 개의 출력 전선에서 0 들의 존재는 연산이 요구되지 않았음을 나타낸다.
부호 해독기로부터의 출력은 출력 전선에서 다른
컴퓨터 장치에 대한 내부 지시를 나타내는 비트들을 만들어내는 부호화 장치를 통과하게
된다. 이들 출력 전선들은 논리장치 내에서 가산기 회로에 연결된다. 출력 비트들
중의 하나로 축적 레지스터 (accumulator register) 의 기억장치로부터 숫자를 옮기는
작업을 수행한다. 다른 것은 합계 (sum) 와 올림비트 (carry bit) 들을 생기게끔
가산기 회로들을 풀어주며,  은 adder output (sum, 합) 을 축적 레지스터에 연결한다 (게이트를 통해서).
부호화 장치로부터 다른 출력 비트들은 가산연산이 진행되는 동안 컴퓨터의 다른
부분의 활동을 정지시킨다.
다음 지시는 MUL 을 위한 비트들을 포함한다고 가정하자. 그러면 지시를 위한 부호 해독장치는 MUL 출력 전선에 1 이란 비트를 만들며, 이 비트는 그것을 내부 지시의 비트들로 옮길 부호화 장치로 간다. 논리장치 (logic unit) 에 옮겨지는 이들은 곱셈의 과정을 구성하는 연속적인 덧셈-옮김-덧셈-옮김 연산을 취한다 (제 2 장).제어장치는 모든 외부로부터의 표준지시 단어를 인지하는 데 필요한 부호 해독장치의 출력들을 포함한다. 그리고 이들은 다른 장치를 지시하는 비트 신호를 만들며, 내부 지시 부호화 장치 과정은 외부로부터의 지시를 내부 지시로 바꾸는 데 적용될 뿐만 아니라, 내부 지시를 인지하여 다른 장치를 위한 또 다른 내부 지시 (go-ahead 신호처럼) 로 만들기 위해 컴퓨터 장치에 의해 사용된다. 컴퓨터의 도처에 많은 부호화 회로와 부호 해독회로들이 있다. 사실상 전형적인 컴퓨터는 2 극진공관과 트랜지스터의 절반 가량은 인지와 제어에 적용된다. 나머지 반은 레지스터, 논리회로 그리고 주기억 장치에서 읽고 쓰는 데 주요한 일들을 취급한다.
설명된 부호화 회로와 부호 해독회로는 표준을 제외하면 지시 단어와 보통 연산을 위해 컴퓨터에 영구히 연결된다. 또한 내부지시 제어 아래에서 연산하는 게이트에 의한 "and", "or" 그리고 "not" 회로들을 연결함으로써 계산하는 동안 순서를 정하는 부호화나 부호 해독회로를 만들 수 있다.
여기서 우리는 컴퓨터에 관한 가장 중요한 사실 중의 하나를 파악할 수 있다. 기계 비트 코드에서 문제의 형식 (지시) 과 문제의 내용 (데이타) 은 정확히 똑같은 형의 표현을 가진다. 그것들은 둘 다 0 과 1 의 스트링이다. 단어가 나타난 순서, 단어를 표시한 특별 문자 혹은 영숫자와 같은 실마리만 주어진다면 컴퓨터는 지시와 데이터를 구별할 수 있다. 그런 실마리가 없다면 컴퓨터는 차이점을 구별할 수 없으며 사실상 "조금도 상관할 수가 없다."
일을 간편하게 하기 위해 각 컴퓨터의 지시는 표준형식으로 씌여진다. 첫째 부분은 해야 할 연산을 명시하는 영숫자의 생략형이다. 둘째 부분은 연산된 데이터가 발견되었거나 혹은 그것들이 위치하고 있는 기억장치의 주소를 포함한다. 3 장에서 우리는 세 개의 주소를 갖는 지시들을 사용했다. 컴퓨터는 또한 단일 주소 (single address) 지시를 위해 고안되었다. 대표적인 예는 다음과 같다.
|
XMA 100 |
기억장소 (M) 100 에 있는 데이터를 축적 레지스터 (A) 에 옮겨라. |
|
XAM 101 |
축적 레지스터에 있는 데이터를 기억장소 101 에 옮겨라. |
|
SRA |
축적 레지스터 (A) 에 있는 데이터를 오른쪽으로 한자리 옮겨라. |
|
SLA |
축적 레지스터에 있는 데이터를 왼쪽으로 한 자리 옮겨라. |
|
CMP 102 |
축적 속에 있는 데이터와 기억장소 102 에 있는 데이터를 비교하라. |
|
JOP 103 |
앞에서 비교한 결과가 양수이면 데이터를 앞에서의 기억장소에서 기억장소 103 으로 옮겨라 (JOP 는 "Jump on plus" 의 약자). |
|
JOM 104 |
비교의 결과가 음수이면 데이터를 기억장소 104 로 옮겨라 (JOM 은 "Jump on minus" 의 약자). |
|
JOE 105 |
비교의 결과가 같으면 데이터를 기억장소 105 로 옮겨라 (JOE 는 "Jump on equal" 의 약자). |
|
ADD 106 |
축적 레지스터의 내용을 기억장소 106 에 있는 데이터에 더하고, 그리고 축적 레지스터에다가 앞에서의 내용을 제거한 후에 저장해라. |
|
MUL 107 |
피승수 레지스터의 내용에 기억장소 107 에 저장된 수를 곱하여 그 곱을 축적 레지스터의 앞에서의 내용을 없애고, 그 자리에다가 결과를 놓는다. |
|
DIV 108 |
축적 레지스터의 내용을 기억장소 108 에 저장된 수로 나누어라. 몫 레지스터에 몫을 그리고 축적 레지스터에 나머지를 두어라. |
단일주소 지시 (single-address instruction) 에서 연산은 특정한 레지스터들에 관해서 언급한다. 축적 레지스터는 덧셈에 관한 명령이 주어지기 전에 피가산수를 포함해야 한다. 즉 그 합은 똑같은 레지스터에 피가산수가 대치된다. 축적레지스터는 뺄셈 전에 피감수를 포함한다. 즉 차는 이 레지스터에 피감수 대신 들어간다. 이 레지스터 내의 수들은 한 번에 한 자리씩 0 을 받으면서 비어진 자리에 왼쪽이나 오른쪽으로 옮겨진다. 피승수는 곱셈이 주어지기 전에 먼저 피승수 레지스터에 옮겨져야 한다. 즉 그 곱은 똑같은 레지스터에 놓여진다 (그 곱이 피승수 레지스터에 포함되기에 너무 길다면 축적 레지스터는 high-order digit 들을 받아들인다). 축적 레지스터도 나눗셈이 명령되기 전에 피제수를 포함하고 있어야 한다. 몫은 몫 레지스터, 나머지는 축적 레지스터에 놓여진다.
프로그래머와 오퍼레이터들은 이들 레지스터의 기능을 민첩하게 파악한다면 별로 어렵지 않게 데이터의 통과를 추적할 수 있게 된다. 사실상 프로그래머는 조금이라도 진전된 후에는 데이터의 이동에 관해 예민해질 필요는 없다. 또한 정보의 흐름을 보여주는 박스 (box) 와 화살표로 된 그림을 사용하며 컴퓨터가 수를 갖고 무엇을 하는지 보지 않고도 박스나 화살표의 연관성으로 지시를 쓴다. 물론 프로그래머는 컴퓨터가 어떻게 정보를 처리하는지를 알아야 한다. 특히 오류를 찾고 고치는 방법을 알아야 하지만 필요한 경우에만 자세히 언급한다.
이것은 입력 연산의 일반적인 개요이고 어떻게 지시가 인지ㆍ생성되는지, 그리고 프로그램이 단계적으로 원하는 결과가 얻어질 때까지 데이터를 어떻게 검색해서 연관시키고 저장하는지를 충분히 보여주는 것이 바람직하다. 그러면 데이터는 출력장치로 옮겨진다.
출력장치에 의한 제시가 준비된 출력 정보를 나타내는 펄스의 스트링이 부호 해독되고, 부호 해독장치에 의한 출력전선은 오퍼레이터나 혹은 프로그래머의 개발을 위해 대응되는 문자들을 인쇄시키거나 저장과 다른 계산에서 입력으로 나중에 사용할 수 있도록 카드나 테이프에 부과시킨다.
출력은 자동 키보드에 의해 나오는데 그 키보드의 키들은 보호 해독장치 출력 전선에 의해 활성화한다. 따라서 <그림 5-B> 의 부호 해독 장치는 10 진수 각각에 대해서 출력 신호를 제시하고, 이 신호들은 숫자 키가 눌러지게 한다. 다른 부호 해독장치 출력들은 문자와 부호 키들을 발동시킨다.
자동 키보드는 타이피스트가 손으로 키를 조작하는 것보다 더 빨리 할 수 있으나, 문자들은 하나씩 차례로 인쇄되거나 천공되어야 하므로 컴퓨터 기준에 따라서는 매우 느리다. 키보드 출력이 대략 초당 13 개의 문자들로 제한되는 반면, 컴퓨터는 초당 100,000 개의 문자보다도 더 높은 비율로 부호가 해독된 출력을 제시한다. 컴퓨터 시간을 절약하기 위해 (큰 컴퓨터는 1 분에 10 달러 이상으로 임대된다) 한꺼번에 많은 문자들을 인쇄할 수 있는 출력 인쇄기의 고안이 필요하다.
전형적인 고속 인쇄기는 정확히 종이 위에 매초 120 자씩 15 줄의 문자를 인쇄할 수 있다. 고속 인쇄기는 축상에서 회전하는 120 개의 문자 바퀴 (wheel) 를 사용한다 (타이핑하는 줄에서 각각 문자의 위치에 대해 하나의 바퀴가 대응된다). 각 바퀴는 각각 문자의 주위에 두드러진 문자들 (문자, 숫자, 부호) 을 모두 포함한다. 정반대의 각 바퀴는 원하는 문자가 제때 종이 위에 인쇄될 수 있도록 바퀴에 종이와 삽입된 타이프 리본을 눌러 붙이는 해머이다.
문자 바퀴들은 주어진 문자들이 (예를 들어 "E") 동시에 각 바퀴에 의해서 주어지도록 축상에 일렬로 정돈되어 있다. 문자 E 가 적당한 위치에 자리잡으면 해머들은 E 가 인쇄되어야 하는 줄을 친다. 바퀴가 다음 문자로 회전될 때 다른 해머들은 같은 줄 내의 인쇄되어야 하는 그 위치에서 치며, 바퀴들이 한 회전을 끝내고, 한 줄이 인쇄된다. 그러면, 종이는 다음 줄로 옮겨지고, 이 과정은 계속된다.
이와 같이 하는 동안, 타이핑한 줄을 위해서 컴퓨터 출력에 의해 제시된 문자들은 그 줄이 타이프되는 동안 저장되어야 한다 (즉, 문자 바퀴가 1 회 회전하는 동안). 이때 문자처럼 나타나는 신호들은 바퀴의 각 저장소로부터 나타나며, 이들 신호는 해머가 각 줄을 따라 적당한 위치에서 치게끔 한다. 고속 인쇄기에 연관된 회로들은 한 줄을 위해 모든 문자들을 저장해야 하며, 각 줄에서 의도한 곳을 기억해 두었다가 문자들을 연속해서 선택해야 한다. 원하는 기억장소와 논리회로들은 물론, 그 원리에 있어 컴퓨터의 다른 장치에서의 사용과 다를 바가 없다.
컴퓨터 하드웨어를 전기적ㆍ기계적으로 더욱 상세히 추구하려는 독자들은 흥미있는 그러나 복잡한 주제의 다른 책을 읽을 수 있다.
그렇지 않은 사람들은 수만 개의 2 극진공관과 트랜지스터 그리고 수십 만 개의 코어들을 결합하는 컴퓨터를 만들어내기 위해 논리, 저장, 인지 그리고 형을 만드는 것과 같은 제어를 위한 기본적인 회로들을 조립하고, 그것들은 전선, 게이트 (gates), 스위치들을 연결시키며, 그러는 동안 정신을 집중해야 하는 컴퓨터 디자이너의 능력을 전적으로 신뢰하여야 한다. 그러면 이제 독자들은 전산학의 다른 과정, 즉 프로그램을 작성할 수 있는 준비가 된 것이다.