
프로그램으로서의 그림
컴퓨터, 장자의 꿈 : John L. Casti 저서, 강태원 옮김, 교우사, 2002 (원서 : Would be Worlds, 1997), Page 55~126
1975 년 여름, 크리스 랭턴 (Chris Langton) 은 미국 노스캐롤라이나 주 그랜드파더 산에서 행글라이더 추락사고로 거의 죽을 뻔했다. 그러나 등과 골반 뼈를 제외한 전신의 뼈가 부서졌을 정도의 치명적인 사고가, 나중에 그가 인공생명 (artificial life) 이라고 처음으로 부른 분야를 개척하게 된 직접적인 계기가 되었다. 수개월에 걸친 요양 기간동안 랭턴은 생물학, 철학, 컴퓨터과학, 유전학, 수학 및 심지어는 공상과학에 관한 책 더미를 독파하였다. 그는 많은 책을 읽은 끝에 살아있는 생명체에 관한 모든 것을 컴퓨터 속에 무리 없이 집어넣어 재창조할 수 있다는 확신을 갖게 되었다. 결국 병원에서 퇴원할 무렵 그가 평생의 연구로 삼을 것이 정해졌다. 그것은 바로 생체 속의 생명 (life in vivo) 에 대립되는 것으로 "실리콘 속의 생명 (life in silicon)" 을 창조하는 것이다.
아리조나 투손, 미시간 앤 아버를 거쳐, 최종적으로 뉴 멕시코의 로스 알라모스와 산타페에 이르는 길고 험난한 과정 속에서도 랭턴은 돈키호테적인 이상을 간직했다. 1980 년대 중반이 되서야 그는 자신의 생각을 세상에 공개할 준비가 되었다. 기계 속에 거주할 생명의 본질을 찾으려는 그의 생각이 단순히 그와 같은 소수 광신자들의 괴상한 꿈에 불과한 것인가? 아니면, 온갖 학문 분야에 산재한 그와 같은 마음을 지닌 사람들로 구성된 체계적인 연구 집단으로 성장하여 살아있다는 것의 의미에 대하여 생물학자들과 승부를 겨루게 될까? 랭턴은 자신과 뜻을 같이 하는 사람들을 모으기 위하여 - 그는 그런 연구자들이 있다는 것을 확신하고 있었다 - 자신이 일하던 로스 알라모스 국립 연구소가 산타페 연구소 및 애플 컴퓨터 회사와 함께 생명 시스템의 합성 및 모의실험에 관한 제 1 차 국제 회의를 후원하도록 설득하는데 성공하였다.
의심의 여지가 없이 이 회합은 대 성공을 거두었다. 개회 모임에서 보여진 가장 인기 있었던 프로그램은 영국 옥스포드 대학교의 저명한 생물학자인 리챠드 도킨스 (Richard Dawkins) 교수가 만들어 낸 뛰어난 작품이었다. 그 모임에서 도킨스 교수가 보여준 것은 그가 바이오모프라 부른 객체들을 키우는 데에 자연선택과 돌연변이의 작용이 어떻게 사용될 수 있는가 하는 것이었다.
바이오모프 세상은 막대기 모양으로부터 시작된다. 이 뼈대 객체는 일단의 규칙에 따라 유전적으로 돌연변이 되어 다수의 자식을 생성한다. 다음으로 자연의 역할을 담당한 연구자는 이들 자손들 중에서 자신의 미적 감각이나 다른 취향에 따라, 다음 세대로서 하나의 자식을 선택한다. 그리고 이러한 자연선택과 돌연변이의 과정을 되풀이한다. 그림 1 은 도킨스의 진화 실험 중의 하나를 나타내며, 그림 2 는 일련의 과정을 거친 후 생성된 바이오모프 세계의 거주자들을 모아 놓은 것이다.
[그림 1] 바이오모프의 진화 과정

[그림 2] 바이오모프 세계의 거주자들
도킨스의 컴퓨터 속에 생성된 바이오모프들은 진짜 외계 생명체와 같은 모양을 띄고있다. 그러나 어떤 것들은 우리가 지구상에서 흔히 보아온 것 같은 다양한 종류의 벌레들과 기분이 나쁠 정도로 닮은 형태를 취하고 있다. 물론 도킨스가 창조한 이 모든 것들은 초기의 단순한 형태에 몇 개 안 되는 단순한 규칙들을 반복적으로 적용한 결과, 창발적으로 생겨난 것임을 다시 생각해 보아야 한다. 물론 이때, 연구자는 생성된 생명체들 중에서 어떤 것들이 도태되고 어떤 것이 살아남아 다음 세대가 되는가를 - 마치 신과 같은 권한으로 - 선택함으로써 이러한 창발적 과정에 개입한다.
도킨스의 연구가 발표된 것으로부터 수년 후에, 클리포드 픽코버 (Clifford Pickover) 는 바이오모프를 생성하는 한층 단순한 방법을 고안하였다. 그가 만들어낸 바이오모프 세계는 자연의 기하학이라는 프랙탈 이론에서 다양한 종류의 프랙탈을 생성할 때 사용한 것과 동일한 방법을 이용하여 창조된다. 이제 그 원리를 간단하게 알아보자.
클리포드 픽코버의 바이오모프는 우선 x-y 평면상의 시작 점 하나를 선택하는 것으로 출발한다. 그리고 아래의 규칙에 따라 다음 점을 생성한다 : 평면상의 현재 (x, y) 에 대하여, 다음 점의 좌표는 다음 식으로 정한다.

이 규칙을 반복적으로 적용하여 일련의 점들을 생성한다. 이렇듯 고정된 규칙을 반복적으로 적용하여 점들을 생성하는 것을 반복 절차 혹은 생성 절차라 부르며, 이때 반복 적용되는 규칙들을 생성자라 부르고, 시작점을 씨앗이라고 부른다. 이제 바이오모프가 어떻게 그려지는지 알아보자. 다음 점을 계산하는 식이 정해지면, 임의의 씨앗에서 출발하여 정해진 (대략 수천 번 정도) 반복 후에 생성된 현재 점과 시작점의 거리가 미리 정해진 범위 (예를 들어 10) 내의 값이면, 씨앗 즉, 시작점을 검은색 (혹은 다른 어떤 색) 으로 취하고, 그렇지 않으면 하얀색으로 취한다. 이러한 과정을 시작점을 달리해가면서 반복하여 바이오모프를 생성해 낸다.
그림 3 은 많은 시작점들을 선택하고, 앞서 언급한 색칠 절차로 만들어진 바이오모프를 나타낸다. 이 바이오모프는 언뜻 보면 아메바나 방산충 (radiolaria) 같은 실세계의 생명체와 섬뜩할 정도로 동일한 구조를 나타낸다는 것을 알 수 있다. 방산충은 흔히 바깥쪽으로 뻗어나가는 다수의 복잡하며 대칭적인 외골격을 갖는 단 세포 생명체들이다. 그림 4 는 많은 바이오모프들 중에 몇 가지를 모아 놓은 것이다. 이것들은 점들을 생성하기 위한 생성자를 조금씩 달리해가면서 만들어낸 것들이다 (그림에서는 생성자를 간단하게 나타내기 위하여 복소수 표기를 사용했음을 주의할 것).

[그림 3] 방산충 바이오모프

[그림 4] 생성 절차로 만들어진 바이오모프들
두 가지 컴퓨터 실험에서 나타나는 놀라운 결과를 통하여 우리가 알아야 할 중요한 점은, 단지 자연이 생명체를 만들어내기 위하여 어떤 방법으로든 도킨스나 픽코버가 사용한 것과 같은 단순한 규칙들을 사용한다는 것이 아니라, 그렇게 복잡해 보이는 기하학적 형태나 모양이 결국은 단순한 막대기 모양이나 씨앗 점들에서 출발하여 만들어진 것이라는 점이다 (역주 : 저자는 여기서 복잡한 것의 내면에 있는 규칙의 단순함보다는, 그러한 단순한 규칙의 반복적 적용에 의하여 단순한 형태가 복잡한 것으로 변하는 과정 즉, 진화를 강조하고 있다). 두 경우 모두 최종적으로 만들어진 형태의 복잡도는 그러한 형태를 만들어내는데 사용한 규칙들의 복잡도보다 훨씬 더 크다. 이러한 사실을 분명히 하기 위하여 한가지 예를 더 알아보도록 하자.
1960 년대 중반 무렵, 네델란드의 유명한 생물학자 아리스티드 린덴마이어 (Aristid Lindenmayer) 는 앞에서 언급한 것과 유사한 규칙들을 사용하여 식물의 성장을 설명할 수 있는 체계를 연구하기 시작하였다. 그의 업적을 기리기 위하여 오늘날은 L-시스템이라 부르는 린덴마이어의 시스템은 식물의 여러 부분들을 생성하는 일련의 규칙들로 볼 수 있다. 이제 그것의 밑바탕이 되는 생각을 간단하게 알아보자.
청녹 조류인 아나배나
카테눌라 (Anabaena catenula) 는 실모양으로 일렬로 늘어선 두 가지 유형의 세포로
구성되었다. 크기가 다른 두 세포를 이 식물로부터 쉽게 구분하여 나타내기 위하여
각각을 a 와 b 로 나타내기로 하자. 미시적인 관점에서 이 식물은 길이가 긴 a 형
세포와 길이가 짧은 b 형 세포가 임의로 섞여 일렬로 늘어선 원통형 모양이며, 세포
수에 따라 각 식물의 전체 길이는 매우 다양하다. 또한 각 세포에 대하여 그것의
자식 세포가 생겨나는 방향이 오른쪽이냐 왼쪽이냐에 따라서 각각 r 혹은 1 이라는
표식을 붙이기로 한다. 따라서 이러한 표식을 고려하면, 이 식물을 구성하는 세포의
유형은 총 4 가지 ( ) 가 된다. 한 개의 세포
 로 이루어진 아나배나가 있다고 가정해 보자. 그리고 이 조상 아나배나를 새로운
몸체 즉, 세포들로 구성되는 아나배나로 성장시키기 위하여 다음과 같은 4 가지 규칙을
사용하기로 하자 (첫 번째 규칙은 "
 세포를 왼쪽에는
 세포, 오른쪽에는
 세포가 인접한 것으로 바꾼다" 라는 의미를 갖는다).

이러한 4 개의 규칙으로 구성된 집합은, 식물 성장의 각 단계에서 각 세포가 다음 단계에 어떤 세포들로 대치되는가 (고쳐 쓰이는가) 를 나타내기 때문에, 재기록 시스템 (rewrite system) 이라 부른다.
그림 5 는 한 개의
시작 세포  에서 출발하여 앞의 규칙을 적용한 결과를 나타낸다. 그림 가장 위 줄은 시작
세포
 을 나타내며, 여기에 규칙 I 을 적용하여 두 번째 줄을 얻는다. 다음으로 세포
 과
 에 각각 규칙 II 와 III 을 적용하여 다음 줄을 얻는다, 시작 세포에서 출발하여
이러한 과정을 4 번 적용하면 그림의 마지막 줄을 얻을 수 있다. 결국, 이렇게 몇
개의 규칙을 연속적으로 적용함으로써 매우 다양한 형태의 식물을 만들어 낼 수 있다.
(역주 : 원작의 그림에는 "단계" 를 "규칙" 으로 틀리게 기재하였기에
바로 잡았다.)

[그림 5] 실 모양 식물 아나배나의 성장 과정

[그림 6] L-시스템에 의한 조밥나물 꽃의 개화 (컬러 사진 3)
아니배나가 식물인 것은 분명하지만, 가장 원시적인 식물이다. 게다가 그림 5 에 나와있는 이 식물의 모양은 실제의 그것과는 다른, 마치 모형 판지에서 뜯어낸 것과 비슷한 것으로, 이 청녹 조류의 성장에 대한 가장 기본적인 특징을 보여주는 단순한 2 차원 모델에 지나지 않는다. 그러나 식물의 성장을 단순한 규칙의 집합 즉, L-시스템으로 나타낸다는 기본적인 생각은 현재는 널리 사용되는 것이며, 린덴마이어의 동료들 특히 푸르진키브즈 (P. Prusinkiewicz) 에 의하여 극적인 성과들이 나타나게 되었다. 여기에서 그것을 자세하게 설명하지는 않겠지만, 그림 6 을 보면, L-시스템 규칙들이 식물의 성장을 얼마나 실감나게 묘사할 수 있는가를 알 수 있을 것이다. 그 그림은 전자적 조밥나물 꽃의 개화 과정을 나타내는 것으로, 아나배다를 설명할 때 사용한 규칙보다 아주 조금 더 복잡한 규칙으로 이루어진 L-시스템을 이용한 것이며 다만, 색상을 정교하게 묘사하기 위하여 복잡한 컴퓨터 그래픽 기술이 이용되었을 뿐이다.
도킨스, 픽코버, 그리고 린덴마이어 등이 단순한 규칙들을 적용하여 만들어낸 바이오모프들은, 우리가 흔히 볼 수 있듯이 지구 표면을 슬금슬금 기어다니는 살아있는 생명체에 대한 모방은 분명히 아니다. 예를 들어, 실제 생명체는 섬세한 물질로 가득한 내부 구조를 갖는 3 차원 객체들이다. 반면에 바이오모프는 부피를 전혀 가지고 있지 않는 2 차원 생명체이다. 더군다나, 바이오모프는 실제로 아무 일도 할 수가 없다. 그것들은 단순히 수학적인 대상들로서, 다만 그것의 기하학적 생김새가 몇몇 살아있는 생명체의 모습과 우연하게도 놀랄 만큼 닮았을 뿐이다. 그렇다면 바이오모프를 만들어낸 프로그램이나 계산 규칙은 실제 세계 생명체의 동작이나 기능이 아닌 단지 형태에 대한 모델일 뿐이라는 주장에 대응할 방법이 있는가? 아니면, 마치 불을 내뿜으며 질주하는 경주용 훼라리와 그것의 모델과의 관계처럼 바이오모프는 생물학적 생명체와는 무관한 단지 계산에 대한 호기심의 산물에 지나지 않는 것인가?
바이오모프에 대한 컴퓨터 모델을 앞장에서 제시한 단순성, 명료성, 공정성, 및 계산의 현실성이라는 잣대로 평가해 보면, 그 모델들은 아주 좋은 모델임이 분명하다. 어떤 규칙들도 픽코버의 방상충을 생성하는 규칙들보다 더 간단하고 명료할 수는 없다. 그럼에도 불구하고, 그 컴퓨터 모델들은 "정말 믿을 수 있는 것인가?" 라는 문제에 있어서는 안타깝게도 항상 부정적일 수밖에 없다. 즉, 실리콘 속에 존재하는 방산충을 만들기 위하여 사용한 단순한 3 차 다항식이, 자연이라는 어머니가 - 규칙을 사용한다고 가정하고 - 실제 세계의 방산충을 만들기 위하여 사용한 규칙과 같은 것이라는 생각을 진지하게 받아들이기는 무척 어렵다. 실제의 방산충과 비슷한 형태를 만들어 낼 수 있다는 것과, 방산충 자체를 만들어 낼 수 있다는 것은 전혀 별개의 것이다. 따라서, 그러한 프로그램들이 생물학적 성장 혹은 발생에 대한 자연의 절차가 규칙의 지배를 받는 것이라는 주장에는 동의를 하더라도, 그것에 사용된 규칙들이, 자연의 세포가 실제로 살아 움직이는 아나배나 혹은 다른 어떤 생명체의 구조를 형성하는데 사용한 규칙 혹은 규칙들과 똑같은 것이라는 주장에 매달 목 빠지게 기다리는 자신의 월급을 몽땅 걸지는 않을 것이다. 그러나 또 다른 관점에서, 그 실험에서 사용한 모델이 실제로 매우 좋은 모델이라고 할 수 있는 근거는 충분히 발견할 수 있다. 실제로 그것은 가능한 모든 모델들 중에서 최고로 좋은 모델로 - 실제의 그것과 같아 - 보인다.
우리는 모델을 살아 있는 생명체, 축구 게임 혹은 태양계와 같은 자연 현상이나 인간사에서 일어나는 현상을 기호로 표현한 것으로 말해왔다. 그러한 모델의 목적은 우리로 하여금 그 시스템이 보이는 실세계의 과정에 대하여 무엇인가를 예측하거나 혹은 설명할 수 있도록 하는데 있다. 간단하게 말해서 모델이 좋은 것이냐 나쁜 것이냐를 판단하는 표준적인 기준은 모델이 사람들, 장소 혹은 사물에 대한 우리의 질문에 얼마나 잘 답하느냐에 근거한다. 그러나 만일 모델과 실세계가 단절된 경우는 어떤가? 즉, 모델이 기술하는 실세계의 대상이나 과정이 컴퓨터 내부에 존재하는 기호적인 그 무엇인 경우는 어떤가? 그러한 경우들은 우리가 모델이라고 부르는 것 자체가 시스템이다. 이제 그러한 경우를 다루어 보자.
앞서 보여진 그림 3 의 방산충을 생성하는 규칙에 대하여 다시 생각해 보자. 이 책의 1 장에서 설명한 용어에 의하면 이 모델은 계산적 모델이다. 이 모델은 우리에게 방산충 같은 생명체의 형태를 보여준다는 관점에서는 아주 좋은 모델이다. 그렇지만 그것은 방산충의 구조나 동작에 대한 질문에 대해서는 우리에게 아무런 답을 주지 못한다. 그러나 이제 모델과 실세계의 그러한 대응관계를 버리고, 앞서 그림 2 나 그림 4 에서 볼 수 있었던 도킨스와 픽코버가 창조해낸 괴상한 것들이 살아가는 실리콘 속의 세계 즉, 컴퓨터 속의 세계에 대하여 생각해 보자. 이 경우, 규칙들은 더 이상 방산충에 대한 모델이 아니며, 대신에 그림 3 에 있는 것과 같은 바이오모프의 정의 자체가 된다. 즉, 그러한 인공 세계에서는 방산충을 생성하는 규칙 자체가 실리콘 속 세계에서의 실제 생명체가 된다. 따라서, 이 규칙은 실제 대상에 대한 가장 최상의 모델이자 대상 그 자체이다.
지구상의 모든 생명체는 탄소 화합물의 산물이며, 따라서 우리는 탄소에 기반한 생명체에 익숙하다. 그러므로 방금 전에 논의한 주장은 모델이란 항상 탄소에 기반한 생명체들의 세상을 다루는 것이라는 생각에 익숙해진 사람들에게는 아마도 이상하게 보일 수 있다. 그러나 그것은 단지 편견에 지나지 않는다. 우리가 일상적으로 접하는 세상만이 존재에 대한 특권을 가지고 있다고 생각할 근거는 결코 없으며, 생체 속이 아닌 실리콘 속에 창조된 세계가 덜 실제적이라고 생각할 근거 역시 전혀 없다. 컴퓨터 속에 창조된 세계는, 컴퓨터 외부가 아니라 그것이 존재하는 컴퓨터 내부에서 바라보는 경우, 우리 자신이 살아가는 실제 세계만큼 실제적이다. 이러한 외부적 관점과 내부적 관점이라는 이분법은 이 책을 읽는 동안 체계적으로 다루어질 주제이므로 여기에서 장황하게 언급할 필요는 없다. 이 책의 이어지는 장들에서 우리가 보게 될 소위 인공 세계에 대한 많은 예는 1 톤이 넘는 공허한 일반론이나 공론적인 철학보다 한층 강하게 요점을 파악하도록 할 것이다. 다만 독자들은, 우리가 접하게 될 모델들은 항상 그들이 다루는 특별한 세계를 기준으로 평가해야 한다는 것과, 컴퓨터라는 존재가 하나의 실제 세계에 대하여 무수하게 많은 대리 세상을 생성하는 - 과거에는 매우 제한적일 수밖에 없었던 - 길을 열었다는 사실을 깊이 새기길 바란다.
요즈음에는, 만일 누군가가 중력이 음수가 되거나, 주식의 배당금이 월스트리트의 그것과 다른 경우에 세상이 어떻게 돌아가는지를 조사하고 싶다면, 그는 단지 그러한 세계를 자신의 컴퓨터 속에 만들어 놓고 무슨 일이 일어나는지를 관찰하면 된다 - 물론 그러한 세계는 그 세계를 동작시키는 실제 컴퓨터의 계산 능력에 제한을 받기는 한다. 이제 탁상 위에 놓인 컴퓨터 속으로 들어간 세상 앞에서, 심호흡 한번하고, 컴퓨터가 다양한 가상 세계를 다루는 방법을 알아보도록 하자.
계산 분야에 있어서 1935 년은 매우 의미가 큰 해였다. 그 해는 영국의 수학자 앨런 튜링이 수학에서 널리 알려진 미해결 문제인 힐버트의 결정 문제 (역주 : 궁극적으로 모든 수학 문제를 풀 수 있는 일반적인 알고리즘을 찾으려는 것) 를 해결하려고 시도한 시기이며, 오늘날 계산 이론이라고 부르는 것에 대한 이론적 기초를 수립하려는 시도에 대한 결말이 난 해이기도 하다. 튜링의 연구 업적 중에서 가장 뛰어난 것은 튜링 머신이라 부르는 일종의 이론적 / 추상적 컴퓨터이다. 이 절묘한 장치는 기호 0 또는 1 을 저장할 수 있는 정사각형 구획들로 나뉘어진 무한한 길이의 테이프와, n 개의 상태 중에 한가지 상태를 가지며, 테이프의 앞ㆍ뒤로 움직일 수 있는 헤드로 구성되어 있다. 헤드는 테이프 위를 정사각형 단위로 움직이며 매 단계마다 다음과 같은 동작 중에 하나를 수행할 수 있다.
|
현재의 정사각형에 1 을 기록하라. 현재의 정사각형에 0 을 기록하라. 왼쪽으로 한 칸 이동하라. 오른쪽으로 한 칸 이동하라. 현재의 상태를 다른 상태로 바꾸어라. 현재 상태를 유지하라. 정지하라. |
어떤 문제를 해결하는데, 각 단계마다 이러한 7 개의 동작이면 충분하다. 튜링은, 이렇듯 매우 제한적인 동작 기능을 갖는 것으로 보이는 기계가, 절차적으로 계산할 수 있는 것은 어떤 것이든 계산해 낼 수 있는 능력을 가지고 있다는 것을 증명하였다. 실제로 그는 이 기계를 "일반화" 하여 만능 튜링 머신이 존재한다는 것을 증명하였다. 만능 튜링 머신은 모든 계산 기계의 동작을 흉내낼 수 있는 것이다. (역주 : 결국 기계적으로 계산할 수 있는 것은 모두 만능 튜링 머신으로 계산할 수 있으며, 만능 튜링 머신으로 계산할 수 없는 문제는 기계적으로 계산할 수 없다.) 따라서, 매킨토시 컴퓨터, 스팍 워크스테이션, 혹은 슈퍼컴퓨터인 커넥션 머신 - 5 등이 계산할 수 있는 문제는 역시 만능 튜링 머신으로도 계산할 수 있다. 다만 속도가 느릴 뿐이다. 만능 튜링 머신이 어떻게 동작되는가를 정확하게 이해하는 것은 이 책의 목적과는 다소 거리가 있다. 따라서, 이 기계에 흥미가 있는 독자들은 이 책의 참고 문헌을 참고하기 바란다. 우리에게 정말로 중요한 것은, 그것이 기호나 언어 등으로 표현된 세계를 어떻게 자신의 내부에 표현하는가를 이해하는 것이다.
만능 튜링 머신을 비롯하여 모든 컴퓨터는 다루려는 대상을 자신의 기억장치 속에 0 과 1 의 조합 즉, 이진수로 표현한다. 따라서 단어나 그림을 컴퓨터에 표현하기 위해서는 반드시 그것을 이진수 패턴으로 바꾸어야 한다. 설명을 쉽게 하기 위하여 우리가 컴퓨터에 표현하려는 것이 영어 문장이라고 가정하자. 영어 문장은 알파벳 문자와 구두점 그리고 공백문자로 구성되므로, 그것들을 컴퓨터문자인 0 과 1 의 문자열로 표현하는 표기법이 필요하다. 현재 전세계 거의 모든 컴퓨터에서 사용되는 컴퓨터내의 문자 표기법은 아스키 (ASCII : American Standard Code for Information Interchange) 코드라는 것이며, 각각의 영어 문자 및 구두점 등에 고유한 8 자리 이진수 패턴을 하나씩 대응시키는 표기법이다. 예를 들어, 몇몇 문자에 대한 아스키 코드는 다음과 같다.
|
A = 01000001 |
I = 01001001 |
M = 01001101 |
|
! = 00100001 |
(공백) = 00100000 |
? = 00111111 |
위에 있는 아스키 코드 체계를 사용하여 영어 문장 "AM I?" 를 다음과 같은 이진수열로 나타낼 수 있으며,
01000001|01001101|00100000|01001001|00111111
영어 문장 I AM! 은 다음과 같은 이진수열로 표기된다.
01001001|00100000|01000001|01001101|00100001
사람들이 이러한 코드 체계를 사용한다면, 전쟁과 평화 같은 장편 소설을 표기하는 경우는 말할 것도 없고, 간단한 몇 개의 문장을 표기하는 것조차도 매우 번거로울 것이 분명하다. 그러나 컴퓨터는 자기 멋대로 이진수열을 만들어 내는 것은 말할 것도 없고 정확한 의미를 이진수열을 만들어 내는데 아무 문제가 없다. (역주 : 우리는 우리가 사용하는 문자를 그대로 사용하고 컴퓨터가 알아서 자신의 표기로 전환하여 사용한다.) 그림의 경우는 어떠한가? 아마도 그림을 이진수열로 표현한다는 것에 대하여 다소 의혹을 가질 수 있을 것이나, 사실은 문장을 표현하는 것 보다 조금도 복잡하지 않다. 기본적으로 그림은 픽셀이라 부르는 다수의 격자형 그림 성분들로 나누어진다. (역주 : 픽셀 (pixel) 은 그림 성분 (picture element) 의 합성어이다.) 전체 그림을 구성하는 "원자" 에 해당하는 픽셀들은 그 위치에 대한 색상 값들을 가지고 있다. 각각의 색상에 대응하는 이진수열을 짝짓는 방법은 매우 다양하지만, 기본적으로 문자를 아스키코드로 표기할 때 사용하는 방법과 완전히 동일하다.
우리는 이러한 표기법을 사용하여 문장이나 그림 따위를 이진수열로 나타낼 수 있다. 결국, 우리는 우리가 다루려는 세계를 기호를 이용하여 컴퓨터 내부에 표현할 수가 있다. 그러나 그것이 전부는 아니다. 일단 우리가 우리의 특별한 생각이나 형태를 우리가 잘 아는 형태로 표현하기만 하면, 컴퓨터 프로그램은 그것을 자신이 이해하고 처리할 수 있는 이진수열의 형태로 변환하여 처리한다. 다음으로 처리된 결과는 다시 우리가 이해할 수 있는 형태인 문자나 그림으로 보여진다. 이러한 방법으로 우리는 문장을 컴퓨터에 입력하고, 처리된 결과를 문장으로 출력 받는다. 이러한 입력 및 출력 과정이 되풀이되는 것을 우리가 기계와 대화를 나눈다고 표현할 수도 있다. 이러한 관점에서 이제 생각하는 기계 즉, 소위 말하는 인공지능 (Artificial Intelligence) 에 관한 논쟁에 대하여 더 알아보자.
인공지능 지지자들은, 우리가 지금 진짜 사람과 대화를 나눈 것인지 기계와 대화를 나눈 것인지를 구분할 수 없을 정도로, 뛰어난 대화 능력을 가진 컴퓨터 프로그램을 만들거나 혹은 그런 수준으로 진화시킬 수 있다고 주장한다. 반면에 인공지능에 부정적인 사람들은 한 마디로 "안 된다!" 라고 말한다. 양쪽 진영이 모두 동의하는 것은, 우리가 만든 프로그램 중에서 현재까지는, 사람들로 하여금 기계가 마치 우리가 생각하는 것과 똑같이 생각한다고 느끼게 할만큼 지능적인 것은 어디에도 없다는 것이다. 그렇지만, 몇몇 프로그램들은 제한된 범위의 주제를 정해놓고 하는 대화에 있어서는 사람을 아주 잘 흉내낸다. 제한적이기는 하지만 꽤나 만족할 만한 인공지능 시스템이 어느 정도인가를 느껴보기 위하여, 랙터 (영어단어 중 얘기꾼을 의미하는 raconteur 를 줄여서 만든 이름) 라는 프로그램과 사람과의 대화 과정을 관찰해 보자. 다음은 랙터와 조안 홀 (Joan Hall) 이라는 예술가와의 대화 과정의 일부를 발췌한 것이다.
|
랙터 : 빠르고 명확하게 선생님의 성함을 말씀해 주세요. 홀 : 조안 홀. 랙터 : 빨리빨리 말할까요? 아니면 천천히 여유 있게 대화를 나눌까요? 홀 : 몰라. 랙터 : 좋아요 홀, 딱딱하게 질문하지요. 당신 어디서 왔으며 뭐 하는 사람입니까? 홀 : 뉴욕에서 온 작가요. 랙터 : 조안, 당신이 그 지긋지긋한 작가라니까 한마디 하겠어요. 내 말 잘 들어봐요. 매년 하루하루가 지옥 같아요, 조안. 그래서인지 요즘 난 제 정신이 아니에요. 뉴욕에서 온 몇몇 우주론자들이 다른 우주론자들을 예찬하는 노래를 부르곤 했어요. 최초의 우주론자가 "어쨌든 우리의 헌신은 모두 미친 짓이다" 라고 노래했지요. 그러고 보면 모든 경우에 모호성이라는 것이 참 중욯나 것 같아요, 조안. 그런 얘기들은 참 매혹적이에요. 그렇지 않아요? 홀 : 그렇다고 생각해. 랙터 : "그렇다고 생각해" 라니요. 매력적인 우주론자들은 결코 거만하지 않아요. 우주론자들이 성급하게 "그렇다고 생각해" 라고 한 것들이 가치 있는 것이 되기도 하지요. 갑자기 그들이 무엇인가에 헌신하기도 하지만, 대개는 곧 그만 두지요. 아주 짧은 동안 우리는 그러한 거만한 행동에 빠져들 뿐이죠. "그렇다고 생각해" 라는 것이 매혹적이기 때문에 아주 잠깐은 그것이 중요해 보이기도 하지요. 예술가들이 중성미자를 조사함에도 불구하고 당신은 지칠 대로 지쳤군요. 홀 : 내 생각에 너는 제 정신이 아닌 것 같다. 랙터 : 잠깐 만이요. 당신 지금 "그렇다고 생각해" 라고 노래했지요. 당신 지금 "내 생각에 너는 제 정신이 아닌 것 같다" 라고 요들송을 부르고 있군요. 술에 취한 듯 그리고 교묘하게 나는 지금 당신의 분노에 찬 고뇌를 엿 보았어요. 예술가인 당신이 "내 생각에 너는 제 정신이 아닌 것 같다" 라고 요들 송을 부르고 있군요. |
자, 이제 독자들은 나름대로 어떤 생각을 갖게 되었을 것이다. 랙터와의 대화는 마치 정신 분열증 환자와의 대화처럼 괴상하다. 랙터의 두서없는 얘기는 아마도 대화 중에 오고 간 말들을 조합하기는 했지만, 어떤 분명한 목적이나 전체적인 조직화 기구 없이 화제와 화제 사이를 목표도 없이 떠돌아다닌 때문으로 보인다. 그러나 랙터가 한 말들과 정신 병원에 입원한 중증 정신병자의 말이 어떻게 다른 것인지를 정확하게 구분해 내기가 어려운 것도 사실이다. 이러한 단순한 형태의 프로그램들은 모두, 앞서 소개한 바이오모프를 만들 때 사용한 것과 크게 다르지 않은 소수의 단순한 규칙들을 반복적으로 적용하는 방법을 사용한다. 유일한 차이점은 다루는 대상이 생물학적 형태가 아니라 단어와 문장이라는 것뿐이다. 랙터가 어떻게 동작되는 것인가를 세세하게 이해하는 것은, 이 책의 수준을 훨씬 넘어서는 것이지만, 그것의 일반적인 구조는 쉽게 설명할 수 있다.
랙터는 파일에서 임의로 한 항목을 선택하는 것으로 동작을 시작한다. 만일 선택한 항목이 "더 자세히 말해봐" 와 같이 단어로 구성된 단순한 문장이면 랙터는 그것을 그대로 출력한다. 그러나 대개의 경우 랙터가 임의로 선택한 항목은 명령어들이다. 그 명령어들은, 역시 자신의 명령어를 가지고 있는 다른 파일의 항목이 된다. 이러한 과정이 되풀이되어 첫 번째 명령어가 최종적으로 실행이 되면, 랙터는 다시 원래의 파일에 속한 항목을 대상으로 동일한 작업을 되풀이한다.
문장을 생성하기 위하여, 랙터는 우선 만들려는 문장의 형식을 선택해야만 한다. 문장의 형식은 임의로 선택할 수도 있고, 최근의 대화를 참작하도록 하는 약간의 규칙을 사용하여 선택할 수도 있다. 다음으로, 문장을 보다 생생하게 만들기 위하여 다양한 식별자들을 사용한다. 식별자는 두 글자 짜리 꼬리표로서, 다른 단어들과의 관계를 나타내려는 목적으로 추가되는 것이다. 이 식별자들을 이용하여 랙터는 이어지는 문장과 단어들 사이의 관계를 유지한다. 예를 들어 다음과 같은 문장 틀 (template) 이 문장을 생성하는 규칙으로 사용된다. (역주 : 랙터가 영어 문장 대화 프로그램이므로 편의상 영어 문장에 대한 문장 틀을 그대로 사용한다. 여기서 none 은 명사, verb 는 동사를 나타낸다.)
THE none.an verb.3p.et The noun.fd.
여기서 an 은 동물 (animals) 을 나타내는 식별자이고, et 와 fd 는 각각 먹기 (eating) 와 음식 (food) 를 나타내는 꼬리표, 즉 식별자들이다. 문장을 구성할 때, 프로그램은 먼저 자신의 파일 속에서 an 식별자가 붙은 명사를 찾는다. 즉, 프로그램은 문장 틀에서 none.an 자리에 위치할 명사로서 lion, tiger, 또는 cat 같은 것 중 하나를 임의로 선택한다. 예를 들어 tiger 가 선택되었다고 가정하고, 다음으로는 식별자 et 가 붙은 동사를 임의로 선택한다. 먹는 행위를 나타내는 동사로서 eat, chew, 또는 chomp 등이 있을 수 있고, 이 중에서 임의로 선택한 동사가 chew 라고 가정하자. 다음 단계에서는 식별자 3p 를 이용하여 동사의 시제를 3 인칭 과거 시제로 결정한다. 마지막으로 프로그램은 fd 식별자가 붙은 명사를 임의로 선택한다. trout 가 선택되었다고 가정하자. 이상의 과정으로 선택된 단어들을 하나로 묶으면 프로그램이 생성하는 문장은 다음과 같은 문장이 된다.
THE TIGER CHEWED THE TROUT.
랙터에 대한 설명을 끝내기 전에, 이 프로그램이 위에서 설명한 것처럼 단지 식별자를 지적하고자 한다. 사실 이 프로그램은 보다 정교한 기술들을 사용하여 문장을 생성한다. 예를 들어, 이 프로그램은 스스로 문장 형태를 생성할 수도 있으며, 문장 구성과 관련된 명령들을 생성하여 대화를 구성한다. 관심 있는 독자들은 이 장과 관련된 참고 문헌을 참조하여 랙터에 대하여 더 많은 것을 알기 바란다.
바이오모프의 생성이나 정신 분열증 환자와 나눈 것 같은 대화 시스템 등을 통하여, 우리는 강력한 계산 능력을 갖는 컴퓨터가 전에는 결코 볼 수 없었던 일종의 창조적 작업을 수행할 수 있다는 것을 알았다. 즉 컴퓨터는, 우리가 그것을 창조적이라고 받아들인다면, 무언가 새로운 구조를 스스로 짜 맞추는 능력을 가졌다고 볼 수 있다. 이러한 일종의 기계에 의한 창조야말로 이 책을 통하여 우리가 설명하고자 하는 가장 핵심적인 논점이며, 그러한 창조성은 다음 장에서 설명할 시장 경제나 도로 교통망과 같은 우리에게 한층 친밀한 많은 문제들을 통해서 자세하게 다루어질 것이다. 컴퓨터가 이렇듯 창조의 수단으로서의 능력을 가지고 있지만, 컴퓨터를 사용하거나 사용하려는 대다수 사람들이 생각하는 컴퓨터는 문장을 생성하거나 아름다운 예술 작품을 창조하는 그런 것이 아니다. 대다수 사람들에게 있어서 컴퓨터는, 은행 업무를 처리하거나 또는 야구장이나 극장에서 전화 예약자의 좌석을 착오 없이 배정하는 것과 같이 다양한 환경에서 단지 복잡한 계산을 할 수 있는 거대한 계산기일 뿐이다. 비교를 위하여, 단순한 계산기로서가 아니라 기호 처리기로서 컴퓨터가 어떻게 동작되며 사용되는가를 조금 더 자세하게 알아보자. 이것은 컴퓨터가 산술 연산을 처리하는 수단으로써 과학의 여러 분야에 통상적으로 어떻게 사용되는 것인가와 그것과는 대조적으로 자신의 내부에 새로운 세계를 만들어내는 장치로써 그것이 어떻게 사용되는 것인가의 차이를 이해하는데 도움이 된다.
정수론에 있어서 가장 중요하면서도 경탄할 만한 정리는 소수 (1 과 자기 자신 이외의 약수를 갖지 않는 수) 의 개수가 무한하다는 유클리드의 증명과 모든 합성수 (소수가 아닌 수) 는 소수인 인수 즉, 소인수들의 곱으로 유일하게 분해된다는 산술에 관한 기본 정리임이 분명하다. 예를 들어 정수 168 은 2 로 나누어지기 때문에 분명히 소수가 아니다. 게다가 그것은 계산기의 도움 없이도 종이랑 연필만 가지고 168 = 2 × 2 × 2 × 3 × 7 과 같이 몇 개의 작은 소수의 곱으로 분해된다는 것을 쉽게 알 수 있는 것이다. 그러나 512,461 이 31, 61, 271 을 소인수로 갖는 합성수라는 것을 계산하기는 쉽지 않다. 100 여년 전에 이미 합성수라는 것이 알려지기는 했지만, 만일 다루는 숫자가 다음과 같다면 그것을 소인수분해 하기 위해서는 단순히 손으로 시행착오를 거듭해 나가며 소인수분해 하기는 어렵고 그 이상의 어떤 기술이 필요하다.

디지털 컴퓨터의 출현과 함께, 어떤 정수가 합성수인가 아닌가를 구별하고, 합성수인 경우 그것의 소인수를 빠르게 찾아내는 방법에 대한 연구는 단순한 학문적인 호기심을 넘어 하나의 작은 산업으로 발전하였다. 1970 년대 후반에, 전송하려는 메시지를 큰 합성수로 쉽게 암호화 할 수 있는 암호화 기술이 최초로 출현하였으며, 자신의 메시지를 암호화하여 전송하려는 사람들은 누구나 사용할 수 있는 방법들이 공개되기까지 하였다. 그러나 공개된 방법으로 메시지를 암호화하였더라도, 그 메시지를 보기 위한 복호화를 위해서는 메시지를 큰 합성수로 암호화할 때 사용한 소인수를 알고 있거나, 아니면 직접 계산을 통하여 소인수를 찾아내야만 한다. 군사적으로나 경제적인 측면에서 외부로부터 안전한 암호화 시스템을 만드는 일은 매우 중요한 일이다. 따라서, 전세계 정부 기관들 특히, 미국의 국가 안전부는 합성수를 소인수의 곱으로 분해하는 방법을 열성적으로 연구하기 시작하였다.
소인수분해 문제는 컴퓨터가, 종이와 연필을 사용하는 전통적인 방법을 사용할 경우 영겁의 시간을 필요로 하는 계산을 해치우는, 상상할 수 없을 정도로 거대하고 강력한 계산기로써 어떻게 사용되는가를 보여주는 가장 확실한 예이다. 지금까지 잘 알려진 방법들은 본질적으로, 큰 합성수의 소인수분해를 위해서 인간이 상상하기도 어려울 만큼 거대한 양의 계산을 필요로 한다. 가장 규모가 큰 슈퍼컴퓨터 조차도 약 150 자리 이상의 합성수를 소인수 분해하기 위해서는 우주의 나이를 훨씬 초월하는 계산 시간을 필요로 한다.
컴퓨터가 단지 계산기로서의 결정적인 역할을 하는 다른 문제로 4색 지도 문제가 잘 알려져 있다. 4 색 지도 문제는 종이 위에 그려진 (정확하게는 구면 위에 그려진) 임의의 지도를 4 가지 이내의 색으로 칠할 수 있는가에 관한 문제다 (역주 : 경계면에 인접한 지역은 서로 다른 색으로 칠해져야 한다). 1852 년 처음으로 이 문제가 세상에 나타났을 때, 사람들은 곧바로 그림 7 에 나타나있는 것처럼 4 개의 색이 필요하다는 것을 알았다. 그림에서 왼쪽의 경우는 실제로 5 가지 색이 사용되었고 (역주 : 그림에서 위 부분의 X 와 중간의 X 는 경계면이 인접하지 않으므로 같은 색으로 칠해도 된다. 즉, 4 색이면 된다), 오른쪽의 경우는 3 가지색으로는 조건에 맞게 칠할 수 없음을 나타낸다. 정작 문제가 된 것은 전 세계 위대한 수학자들이 일 백년 이상 노력하였음에도 불구하고 4 가지를 초과하는 즉, 5 가지 이상의 색을 필요로 하는 지도가 없다는 것을 증명할 수 없었다는 것이다.

[그림 7] 4 색을 필요로 하는 두 종류의 지도
그러나 1976 년에 케네스 아펠 (Kenneth Appel) 과 볼프강 하켄 (Wolfgang Haken) 은 두 가지 아주 상이한 관점에서 수학계를 깜짝 놀라게 하였다. 우선, 그들은 모든 평면상의 지도를 칠하는 데는 4 가지 색이면 충분하다는 것을 증명하였다. 이것이 첫 번째로 놀라운 것이다. 그러나 더욱 중요한 것은 그들이 사용한 증명 방법이 우리로 하여금 수학적 증명이라는 것에 대한 우리의 고정관념을 완전히 재고하도록 했다는 것이다. 이것이 두 번째로 수학계를 놀라게 한 것이다. 그들이 4 색 문제를 해결하기 위하여 사용한 증명 과정에는 1,936 개의 특별한 지도 형태를 조사하는 것이 포함된다. 그들은 각각의 지도 형태를 조사하기 위하여 슈퍼컴퓨터를 사용하였으며, 각각의 계산에는 수 시간이 걸렸다. 고대 수학자의 경우, 계산량이 너무 많아서 손으로는 증명을 할 수 없는 문제들을 가지고 있었다. (역주 : 증명이 많은 계산을 포함하는 경우 시간적으로 그것이 불가능하기도 하지만, 계산 과정에 오류가 발생할 수 있기 때문에 그런 증명은 보통 받아들이지 않는 경향이 있어왔다.) 더욱 문제가 된 것은 아펠과 하켄이 사용한 슈퍼컴퓨터가 수천 시간당 1 회의 비율로 계산 오차를 일으킨다는 것이 알려진 점이다. 계산에 있어서 한 두개의 오류쯤이야 라고 받아들일 사람은 아무도 없을 것이다. 따라서, 아무도 확인할 수 없으며, 몇 개의 계산 오류를 포함하는 증명을 진짜 증명이라고 할 수 있느냐는 의문을 가질 수밖에 없다.
아펠과 하켄의 컴퓨터를 이용한 4 색 문제 증명은 그들이 그것을 발표한지 20 여년이 지나서야 비로소 수학계의 지지를 받게 되었다. 그들의 증명이 지지를 받게 된 가장 큰 이유는 그들의 접근 방법이 무결할 뿐 아니라, 다른 하드웨어 기종에서 다른 프로그램을 사용하여 동일한 결과를 얻어낸 사례들이 속속 알려졌기 때문이다. 그렇지만, 대단히 많은 (그러나 유한한) 경우들을 일일이 컴퓨터를 이용하여 조사하는 방법으로 이루어진 증명을 진짜 수학적 증명으로 볼 수 있는가 아닌가는 수리 철학 분야의 미해결 문제로 남아 있다.
합성수를 소인수 분해하는 문제와 4 색 지도 문제의 컴퓨터에 의한 증명은, 원칙적으로 사람도 할 수 있지만 컴퓨터가 훨씬 빠르게 처리한다는 점에서, 수치 계산 장치로서 컴퓨터가 어떻게 거대한 계산기로 사용되는 가를 보여주는 예다. 계산기로서의 컴퓨터가 단지 수학자들을 위한 새로운 도구만이 아니라는 것을 확실하게 이해하기 위하여, 생물학과 물리학에 관련된 두 가지 문제를 자세히 알아보자. 두 경우 모두 앞에서와 같이 컴퓨터를 이용하여 문제를 해결한다.
모든 생명체를 구성하는 기본 구성 단위는 단백질이다. 각각의 단백질은 (20 가지 색상중의 하나로 채택된 혹은 20 가지 유형의) 아미노산이라는 구슬, 수 백 혹은 수 천 개로 구성된 구슬 목걸이로 생각할 수 있다. 이러한 아미노산들은 세포 속의 유전 물질 즉, DNA 에 저장되어있는 명령에 따라 서로 결합한다. 아미노산들이 서로 결합한 결과로 만들어진 단백질 사슬은 저절로 특별한 3 차원 형상으로 주름진다. 어떤 단백질이 생체 내에서 어떤 기능을 수행하는가는 단백질 사슬의 주름 모양에 의하여 결정된다. 그림 8 은 소화 기관에서 발견되는 시토크롬 - c(cytochrome-c) 라는 단백질의 일차원 구조 즉, 주름을 편 모양을 나타낸다. 이 단백질은 104 개 아미노산들의 사슬로 구성되어 있으며, 각 아미노산의 이름은 축약된 것으로 표기하였다. 그림 9 는 이 단백질이 생체 내부에 존재할 때의 실제 모습으로서 3 차원 형상으로 주름진 것을 나타낸다.

[그림 8] 시토크롬-c 의 일차원 구조

[그림 9] 시토크롬-c 의 주름진 3 차원 구조
생체 내에서 보여지는 단백질의 주름 구조로 미루어 보았을 때, 그것들은 본질적으로 열역학적 평형상태에 머물러 있는 것으로 보여진다. 즉, 생체 내부에 존재하는 단백질은 그것을 구성하는 아미노산 구슬들 사이에 작용하는 모든 힘이 불균형이 잡힌 상태로 존재하는 것이라고 생각할 수 있다. 분자 생물학에 있어서 가장 큰 신비 현상중의 하나는, 아미노산 구슬들의 일차원 배열이 - 잠정적으로 그것들이 취할 수 있는 3 차원 형상의 가능한 가짓수가 엄청나게 많음에도 불구하고 - 어떻게 불과 수 초 만에 올바른 3 차원 구조로 주름이 잡히느냐는 것이다. 계산이라는 측면으로 표현하자면, 서로 결합된 아미노산들의 집합이 어떻게 그렇게 빨리 안정된 열역학적 구조를 계산하느냐는 것이다.
1987 년에 사이러스 레빈달 (Cyrus Levinthal) 은 이 수수께끼에 대한 해답을 하나 제안하였다. 그의 주장은 자연이, 진화의 과정을 통하여, 빨리 주름이 잡히며 동시에 열역학적으로 안정된 구조에 도달하는 단백질 사슬을 선택하였다는 것이다. 레빈달 자신은 자연 선택이 이러한 아미노산 사슬들을 뽑아내는데 어떻게 작용되는가에 대한 구체적인 체제를 제시하지는 못했다. 그러나 1994 년 하바드 대학의 마틴 카플러스 (Martin Karplus) 와 동료들이 이 수수께끼에 대한 가능한 해답을 제시하였다.
간단하게 말해서, 카플러스의 접근방법은 단백질 주름의 형성 과정이 에너지 함수의 지배아래서 일어난다는 가정에서 출발한다. 에너지 함수는 단백질 사슬내의 아미노산 구슬들이 서로 작용할 때 나타나는 에너지의 총합을 나타낸다. 그는 이러한 가정 아래서 이 값을 가능한 줄이는 방향으로 단백질이 주름진다고 보았다. 그것을 확인하기 위하여 카플러스는 사슬이 주름질 수 있는 모든 가능한 경우들을 나열하고, 각각의 주름 형상에 대한 총 에너지를 계산하였다. 임의로 만들어진 많은 단백질 사슬에 대한 실험 결과, 빠르게 주름지는 사슬들의 경우 최저 에너지 차이가 크다는 것을 발견하였다. 또한, 이미 최저의 에너지 상태에 있는 사슬들은 느리게 주름진다는 것을 알았다. 이 책의 목적으로 볼 때, 여기서 이 실험을 더 이상 자세하게 소개할 필요는 없다. 더 알고싶은 독자들은 이 책의 참고 문헌에 인용한 글을 참고하면 될 것이다. 우리가 알아야 할 요점은, 단백질 사슬들 사이의 에너지 차이를 계산하기 위해서는 대단히 많은 양의 계산 자원이 필요하고, 매우 많은 경우들을 일일이 처리해야 한다는 것이다. 즉, 분자 생물학 분야에서 중요하게 사용되는 것으로서, 함수의 최소값을 계산하는데 사용되어 계산기로서 컴퓨터가 과학의 수단이 되는 예를 알아보았다. 이제 컴퓨터가 계산기로 사용되는 마지막 예로 우리에게 매우 친밀한 지구 과학 분야로 화제를 돌려보자.
1904 년에 노르웨이 기상학자 빌헬름 벨크너스 (Vilhelm Bjerknes) 가 "역학과 물리학 문제로서의 기상 예보" 라는 논문을 발표함으로써 현대 기상 연구가 시작되었다. 기상 예보에 대한 최초이자 완전한 공식화를 통하여, 벨크너스는 모든 수치적 기상 예보 모델의 기반이되는 실험적이며 동시에 이론적인 구성요소를 만들어 냈다. 모든 수치적 기상 예보 모델은, ① 공간을 격자로 나누었을 때, ② 각 격자 점들의 상태가 다른 지점의 상태에 의하여 어떻게 변화되는가를 알기 위하여 대기 역학을 제어하는 수학적 관계식들을 사용한다.
기상 예보를 위한 수치 모델을 만들기 위하여 첫 번째로 해야 할 일은 대상이 되는 지리학적 영역을 격자로 나누는 것이다. 그림 10 은 이렇게 나누어진 격자와 특정 시점에 각 격자 지점에 대하여 우리가 필요로 하는 몇 가지 변수들을 나타낸다. 온도, 풍속, 및 기압 등이 그런 변수에 해당되는 것들이다. 벨크너스의 모델로 기상을 예측하기 위해서 첫 번째로 해야 할 일은 특정 시작 시점에 각 지역의 해당 변수 값들을 알아내는 것이다. 각 지역에서 필요로 하는 변수 값은 인공 위성, 비행기 조종사, 기상 관측 석박, 및 기타 세계 기상 자료 네트워크 등을 통하여 얻어진 실제 관측 결과를 사용하여야만 한다.

[그림 10] 수치적 기상 예보 모델
변수 값들을 알아냈으면, 다음 단계에서는 시간이 경과하는 동안이 값들이 어떻게 변하는가를 알기 위하여 수학적 관계식을 사용한다. 즉, 두번째 계산 단계에서는 대기에 대한 복잡한 수학 방정식을 풀어야 한다. (대기에 대한 정보를 얻어내는) 관측과 (시간의 경과에 따른 기상 변화를 파악하기 위한) 계산이라는 두 과정이 얼마나 기술적으로 처리되느냐에 따라서 예측 결과가 좋은가 나쁜가가 결정된다.
기상 예측에는 일반 순환 모델 (GCM : general circulation model) 이라 부르는 모델이 일반적으로 사용된다. 이 모델은 그림 10 과 같이 3 차원 격자를 사용하며, 각 격자 사이의 관계를 나타내는 매우 정교한 관계식을 사용한다. GCM 에서 사용되는 관계식은 다음과 같다.
대기의 수평 이동을 위한 내비어 스토크 방정식들 : 이 방정식들은 동-서, 북-남 방향으로의 공기 덩어리의 이동을 나타내는데 사용된다. 이 이동은 일명 코리올리 Coriolis 의 힘이라 부르는 지구의 자전에 의하여 생기는 힘, 수평 방향으로의 대기압의 변화율, 마찰력과 난류와 같이 흩어져 사라지는 힘, 및 운동량의 생성과 소멸 등이 공기에 미치는 영향과 관계된 것이다.
이러한 방정식들 외에도 GCM 에서는 기상에 영향을 미치는 여러 가지 매개변수들을 사용한다. 그것들 중에서 몇 가지 중요한 것은 다음과 같은 것이다.
마지막으로, GCM 이 실제로 기상을 예측하는데 결정적인 역할을 하는 것은 다음과 같은 변수들이다. GCM 은 이 변수들을 조합하여 기상의 예측에 사용한다.
GCM 에 대한 구체적인 예로서, 영국 기상청에서 만든 모델에 대하여 알아보자. 이 모델은 지표면에서 시작하여 25 Km (80,000 피트) 높이까지를 15 구간의 대기층으로 나누었다. 또한, 각각의 계층은 수평 방향으로 약 150 Km 거리의 구간으로 나뉘어, 전체 모델은 350,000 개의 격자 구간을 갖는 그물망으로 구성된다. 각각의 격자 점들에는 12 시간 간격으로 지구 전역에서 관측된 온도, 압력, 풍속, 및 습도 값이 할당되고, 이 값들의 변화를 나타내는 방정식은 컴퓨터를 이용하여 15 분 간격으로 처리된다 (즉, 컴퓨터로 15 분이 소요된다). 이렇게 계산된 결과는 관측 시점으로부터 6 일간의 기상을 예측하는 자료로 쓰인다. 기상 예보에 필요한 계산량이 얼마나 많은가를 이해하기 위해서, 하루치 일기예보에 필요한 계산량을 알아보자. 하루치 일기예보를 예측하기 위해서는 약 100 조번의 계산이 필요하며, 사이버-25 라는 일종의 슈퍼컴퓨터로 계산하는 경우 4 분 30 초 가량이 걸린다.
우리가 이제까지 수학, 생물학, 및 지구과학 분야에서 컴퓨터가 어떻게 사용되는가를 다룬 이유는, 비교적 최근까지 컴퓨터의 지배적인 역할이 수를 분해하거나 대량의 계산을 빠르게 처리하는 것이었다는 점을 분명하게 하기 위해서였다. 초창기에 컴퓨터를 개발한 동기는 과학자와 공학자들을 위하여 수치 계산을 대신하는 계산기계를 만드는 것이었으며, 그러한 출발에 있어서의 역사적인 배경으로 인하여, 컴퓨터를 단지 계산기로만 보는 관점은 - 인공지능 분야와 같은 훌륭한 예외가 있기는 하지만 - 꽤나 고집스럽게 지속되어 왔다. 그러나 다행스럽게도 컴퓨터를 단지 수치 계산기로만 보는 그러한 의식적이든 무의식적이든 고집스러운 관점의 시대는 이제 끝났다. 오늘날에 이르러는 심지어 어린 학생들까지도, 컴퓨터가 단지 이미 존재하는 것을 증명하거나 또는/혹은 수정하는 그 무엇이 아니라, 새로운 세계를 창조하는 수단이라는 것을 배운다. 컴퓨터를 이러한 목적으로 사용하기 위해서는 사고의 전환이 필요하다. 그 중에서도 가장 중심이 되는 것은 컴퓨터를 수치 계산기가 아니라 기호 처리기로 보는 것이다.
오늘날에는 컴퓨터 기억장치내의 비트나 바이트를 단순히 숫자를 나타내는 것으로만 보아서는 안되며, 그것들이 그림을 나타내거나 앞서 설명한 것처럼 아스키코드로 표현된 문자로 보아야 한다. (역주 : 비트-정보 저장의 최소단위로 1 비트는 0 또는 1 을 저장한다. 바이트-8 개의 비트가 모여 1 바이트가 되며, 의미를 가진 문자 또는 숫자의 최소단위이자, 컴퓨터 기억장치에 주소를 지정하는 단위이기도 한다. 사용하는 컴퓨터의 주기억장치 용량이 64 메가 (바이트) 인 경우, 그 컴퓨터는 6 천 4 백 만개의 바이트를 저장할 수 있음을 나타낸다.) 이러한 표현 방식으로 컴퓨터는 수동적으로 숫자를 조작하는 대신에 새로운 패턴이나 생각을 생성한다. 이 책의 나머지 부분에서는, 컴퓨터의 역할에 대한 새로운 관점을 토대로, 그것이 세계를 창조하는 수단이라는 것을 분명하게 보여줄 것이다. 물론 그것이 창조한 세계는 우리가 살고 있는 실제 세계의 축소판일 수도 있고, 컴퓨터를 통해서만 경험해 볼 수 있는 전혀 새로운 세계일 수도 있다. 이러한 컴퓨터 속 세계는 컴퓨터 프로그래머가 만든 규칙의 산물이다. 그러므로, 이제 우리는 그러한 세계를 창조하는 수단인 규칙과 표현을 재조사하는 것으로 그 세계로의 여행을 시작하도록 하자.
언어학 연구에 있어서, 현대 보편주의 언어학자들이 가지고 있는 개념은 1957 년 노암 참스키 (Noam Chomsky) 의 저서 구문 구조가 출판되면서 언어학의 극적인 전환과 함께 시작된 것이다. 이 놀라울 만한 사건은 언어학 연구의 접근 방법을 사실상 하룻밤만에 전환해 버렸다. 즉, 특정 언어에 대한 특수한 사례들을 수집하는 일종의 "언어 채집" 을 위주로 하는 전통적 방식에서, 모든 인간 언어의 출발점이 되는 정수로서 보편 문법을 찾으려는 방식으로 바꾸어 버렸다. 그들에 의하면 보편 문법이란, 모든 정상적인 아이들의 마음속에 생물학적으로 존재하는 그 무엇이다. 즉, 이것은 그들이 유전적으로 물려받은 것들 중의 일부분이라는 것이다. 참스키는 모든 언어를 구성하는 추상적 구조로서의 보편 문법에 대한 개념을 제안했을 뿐만 아니라, 특정 언어의 문법들은 모두 생성적이라는 혁명적인 개념을 내놓았다. 즉, 그는 모든 언어의 문법은 (해당 언어의 문법에 맞는) 모든 적절한 well-formed 문장을 생성하고, 부적절한 문장은 생성하지 않는 규칙들의 모임이라고 보았다. 따라서, 그는 자연어의 사용에 따른 (역주 : 언어 활동에 따른) 창조적 현상은 결국 규칙의 집합 즉, 문법의 산물이라고 주장하였다.
언어는 그것이 사용되는 지역, 문화, 시대 등의 영향을 받는다. 보편 문법은 다양한 언어에 있어서 그것이 통용되는 언어 사회에서 나타나는 특이성이나 특질과는 독립적인, 언어의 추상적인 구문이 갖는 특성을 나타내는 것이다. 따라서, 모든 언어에 공통적으로 포함된 기본적인 윤곽은 어린이들의 유전자 속에 코드화 되어 새겨져 있다. 그런 다음, 그들의 언어 환경에 따라서, 그들이 배우는 언어에 수반되는 어휘, 강세, 및 어순과 같은 세부적인 것들이 채워진다. (역주 : 한마디로 참스키는 어린이들은 언어를 배울 능력을 타고난다고 주장하는 것이다. 즉, 인간의 두뇌에는 언어 처리능력이 프로그램 되어 있다는 것이다. 또한, 언어가 절차적인 방법으로 처리될 수 있는 것이라는 주장이기도 하며, 이는 컴퓨터를 이용한 자연어 처리의 이론적 바탕을 이룬다). 비록 보편 문법의 개념이, 인간은 어떤 언어든지 배울 수 있다는 것을 말하기는 하지만, 개별언어에 있어서는 그것을 사용하여 서로간에 의사를 교환하기 위해서는 다소간의 제약이 따르게 마련이다. 예를 들어, 이탈리아어 같은 언어들은 (역주 : 우리말도 그렇다.) "그가 가버렸다." 혹은 "그녀가 가버렸다." 대신에 "가버렸다" 와 같이 주어가 생략된 문장을 허용한다. 반면에 영어의 경우는 상대적으로 엄격하게 주어의 존재를 요구한다. 결국, 그러한 선택 사항들의 모임이 보편 문법을 제한하는 경계가 된다. 그렇지만, 문법적인 선택사항이 무제한인 것은 아니다. 그러한 제한들은 서로 연결되어 있으며, 따라서, 하나의 문법적 선택은 다른 선택을 하는데 제약으로 작용할 수 있다. 보편 문법이 갖는 또 다른 결정적인 중요성은 그것이 어휘에 대하여 아무 것도 포함하지 않는다는 것이다. 즉, 보편 문법은 어휘의 형태나 어휘가 갖는 의미 따위에 대해서는 전혀 고려하지 않는다. 따라서, 명사니 동사니 하는 단어의 구분은 보편 문법에는 존재하지 않는다. 대신에 보편 문법은 의미적 역할, 격, 태 등과 같은 것을 정하는 원리를 포함한다.
참스키 이론이 내세우는 것은, 서로 다른 언어의 문장 구조가 인간 두뇌의 심리학적 구조로부터 유래된 것이라는 공통점이 있다는 것이다. 참스키는 다수의 규칙으로 구성된 생성 문법을 만들었다. 그는 그 규칙들은 모든 정상적인 어린이의 두뇌 속 언어 "기관" 내에 물리적으로 자리잡고 있는 것이라고 주장하였다. 구체적으로 그는 언어 기관 내부에는 생성 규칙과 변형 규칙이라는 두 가지 유형의 규칙이 존재하며, 그것들을 이용하여 우리가 모든 문장을 분석할 수 있다고 보았다. 생성 및 변형은 한 문장이 어떻게 명사와 동사구로 분해되는가를 보여주며, 나아가서, 하나의 동사구가 예를 들어 하나의 동사와 또 다른 명사구로 분해 될 수 있음을 보여 주기도 한다. 이러한 방식으로 문장이 갖는 외형적 구조가 생성되고 분석된다.
문장의 내면적 구조 (다루고 있는 특정한 언어와는 무관한 부분) 를 다루기 위해서는 변형 규칙을 사용해야만 한다. 이 규칙들을 사용함으로써, 문장을 그것의 외형적 구조로부터 떼어내어, 보다 간단한 다수의 문장들로 분리해 낼 수 있다. 그러한 변형의 예는 관계 대명사, 종속절의 변형, 능동태에서 수동태로의 변형 등에서 발견할 수 있다. 그림 11 은 생성 규칙과 변형 규칙을 조합하여 어떻게 문장을 변형시키는가를 보여주는 것이다. 여기서는 세 개의 영어 문장 "These explanations bore the reader. The reader will put aside the book. We expect it." 을 하나의 문장 "We expect that the reader who is bored by these explanations will put aide the book." 으로 변형한다. (역주 : 편의상 영어 문장을 그대로 사용한다. 다만 독자의 이해를 돕기 위하여 우리말로의 번역을 이곳에 추가한다. "이러한 설명은 독자를 따분하게 한다. 독자는 이 책을 던져 버릴 것이다. 우리는 그것을 예상한다.". "우리는 이러한 설명을 따분하게 느끼는 독자가 이 책을 던져 버릴 것이라고 예상한다.") 이 예는 한 줌의 단순한 규칙들을 기본적인 원자 문장 혹은 원자 구들에 적용하여 풍부한 언어학적 구성물 즉, 세련된 문장을 만드는 것을 잘 보여준다.
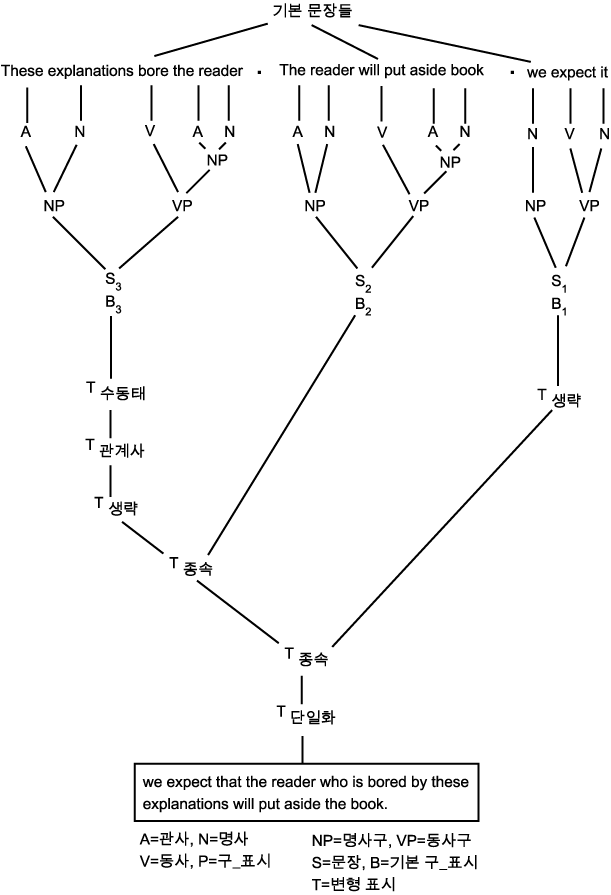
[그림 11] 3 개의 문장에 대한 참스키의 생성 및 변형 규칙
참스키 이론이 우리에게 전해주는 가장 핵심적인 내용은 인간이 사용하는 모든 언어가 본질적으로 규칙에 근거한다는 것이다. 언어라는 것이 생성 및 변형의 과정이라는 참스키의 주장이 사실과 비슷하게라도 맞는 것이라면, 어떤 언어에 의하여 표현될 수 있는 어떤 생각도, 모든 언어에 공통적인 적은 수의 기본적인 틀로부터 추출된 적절한 규칙을 적용하여 만들어 낼 수 있다. (역주 : 즉 인간의 모든 사고를 기계적으로 구성해 낼 수 있다). 참스키 이론에 근거를 둔 많은 언어학 연구는 그러한 규칙들을 실제로 찾아내고 그것을 사용하는 것의 타당성을 입증하려는데 집중되고 있다. 비록 언어가 정말로 인간 두뇌가 갖는 고유한 것으로써 단지 규칙에 근거한 현상인지 아닌지에 대한 판단은 아직 내릴 수 없으나, 그것을 인간의 언어 능력을 이해하는 것에 대한 출발점으로 심각하게 받아들여야 한다는 주장을 뒷받침하는 충분한 근거들이 이미 밝혀졌다. 우리의 관심사로 돌아와, 참스키의 주장이 우리에게 주는 가장 핵심적인 요점은, 그것이 언어 혹은 다른 것과 관련된 모든 현상을 규칙들이 작용한 결과로 볼 수 있다는 대담한 주장에 대한 증거라는 것이다. 이 책에서 소개된 모든 컴퓨터 속 세계의 기반이 되는 그러한 다소 도전적인 주장을 뒷받침하기 위하여, 언어와 밀접하게 관계된 것으로서, 인간의 창조적 활동이 가장 두드려지게 드러나는, 음악과 예술 두 분야에 대하여, 그것들 역시 규칙에 근거한 과정으로 볼 수 있음을 잘 나타내는 사례를 알아보자.
지난 300 년 동안 서양 음악은 12 음조를 기본으로 사용해왔다. 그것은 시계의 문자판이 12 시간을 나타내는 것과 같은 맥락으로 생각될 수 있다. 이러한 생각에 기초하여, 두 음조 구간을 반음 크기로 하여 즉, 시계 문자판의 1 시간 간격을 반음절 크기로 나누어 배열할 수 있을 것이다.
이러한 경우, 시계 방향으로 12 반음을 거치면, 시계 문자판을 한 바퀴 돌아 출발한 음조로 되돌아온다. 이 한바퀴 순환 고리가 우리가 잘 알고 있는 한 옥타브이다. 물론 월요일 1 시와 화요일 1 시가 다르듯이 한 옥타브만큼 떨어진 두 음조는 서로 다르다. 그것들은 2 의 배수만큼의 차이를 갖는 주파수 값으로 진동한다. 한 옥타브 차이의 두 음조가 2 의 배수만큼의 주파수 차이로 진동한다는 것은 고대 그리스 피타고라스 시절에 이미 알려진 사실이다.
음조 구간에 대한 연구 결과, 어떤 음조 구간이 다른 것에 비하여 인간의 귀에 더 좋은 느낌을 준다는 다소 놀라운 사실이 밝혀졌다. 특히, 가장 조화로운 음조 구간은 7 개의 반음들로 이루어진 것이며, 현대 서양 음악은 모두 이것에 근거한 것이다. 예를 들어, 음조 1 에서 출발하여 7 개의 반음을 지나면 (시계로 치면 7 시간 경과) 음조 8 에 도달한다. 그곳에서 다시 7 개의 반음을 지나면 음조 3 에 도달한다. 이러한 과정을 반복하면서 1, 8, 3, 10, 5, 12, 7, 2, 9, 4, 11, 6 라는 음조 열을 생성할 수 있다. 이 음조 열을 보면, 12 음조가 단 한번만 나타난다는 것을 알 수 있을 것이다. 이제 마지막 음조인 음조 6 에서 시작하여 7 개의 반음을 지나면 드디어 시작 음조 1 에 도달한다. 이웃한 음조와 7 개의 반음만큼 떨어진 음조들로 이루어진 이러한 12 음조 열을 순환 오음계 (circle of fifths) 라 부른다. 이 12 음조 열을 음악에서 사용하는 실제 음조로 바꾸면 다음과 같다. 이 경우 시작 음조 1 을 다 음 (C 음) 으로 한다.
C, G, D, A, E, B, F#, C#, G#, D#, A#, E#.
16 세기, 음악에서 하모니가 발전함과 더불어, 특별한 음조 구간과 그것들의 조합이 두드러지게 사용되어 오늘날에 이르고 있다. 그 중에서 특별히 중요한 것이 장음계와 단음계이며, 각각은 7 개의 음조로 이루어져 있다. 이 두 가지 음계와 오음계가 지난 300 년 동안 음조 음악의 기초가 되어온 것이다.
장음계는 +2, +2, +1, +2, +2, +2 반음 구간을 특징으로 한다. 따라서, 음조 1 에서 시작하여 시계 문자판을 따라 이러한 반음 구간만큼 회전하면, 음조 1 에서 시작하는 장음계 1, 3, 5, 6, 8, 10, 12 를 얻을 수 있다. 이것을 음악에서 사용하는 표기법으로 나타내면 C, D, E, F, G, A, B 가 된다. 음계는 12 음조 중 어느 것으로부터 시작해도 되기 때문에, 총 12 개의 장음계가 가능하다. 장음계에서 특히 중요한 것은, 소위 말하는 오음계 (fifth) 다. 오음계는 장음계의 시작으로부터 7 개의 반음을 건너뛴 것에서 시작하는 음계이다. 따라서, 위에서와 같이 음조 1 에서 시작하는 장음계에서 오음은 음조 8 에서 시작하는 음계가 된다. 음조 8 에서 시작하여 장음계 구간에 따라 음조 열을 생성하면 장음계 8, 10, 12, 1, 3, 5, 7 즉, G, A, B, C, D, E, F# 을 얻을 수 있다. 여기서 독자들은 이 오음계에는 앞선 장음계의 음조가 음조 6 을 제외하고는 (순서는 다르지만) 모두 나타난다는 것에 주목해야 한다. 반대로 오음계의 모든 음조 역시 음조 7 을 제외하고 장음계에 나타난다. 이것은 음계와 오음 구간이 갖는 일반적인 성질이다. 즉, 임의의 음조에서 단지 한 개의 음조만 다를 뿐이다. (역주 : 음악 이론에 익숙하지 않은 독자들은 이 부분의 용어에 다소 혼란을 느낄 것이다. 특히 오음계가 그러한데, 원저에는 설명되어 있지 않지만 그리 어려운 개념은 아니다. 위에서 음조 1 에서 시작하는 장음계는 C, D, E, F, G, A, B 이고 그것에 대응되는 오음계는 G, A, B, C, D, E, F# 이다. 즉, 오음계는 장음계의 5 번째 음조부터 시작한다는 것을 알 수 있다. 그래서 오음계라는 이름이 붙었음을 알 수 있을 것이다. 그리고 12 = 7 + 5 라는 사실도 이 부분을 이해하는데 도움이 될 것이다).
지난 500 년 동안의 서양 음악의 역사는 오음 구간의 특수한 성질에 의하여 얻어질 수 있는 다양한 가능한 표현들을 탐구하는 것이었다고 말하는 것이 지나치게 과장된 것은 아니다. 오음 구간과 그것의 변형을 사용하는 것을 음조법 (tonality) 이라 불렀으며, 음악을 체계화하는데 기초가 되어 왔다. 그것은 개개의 음계에서 음조들의 관계를 표현하는 방법을 제공한다. 화성과 장단이 음악의 일부분을 이루는 것임에 반하여, 음조법은 전체 음악의 흐름을 이루는 것이다.
음악의 구조 및 형식에 대한 이러한 짤막하고도 개괄적인 역사를 통해서 우리가 알 수 있는 것은, 거의 모든 전통적 서양 음악의 근본을 이루는 기초에 아주 극소수의 규칙이 사용되고 있다는 것이다. 즉, 12 개의 기본 반음이라는 생각과, 이러한 반음 7 개로 구성되는 장음계 및 단음계, 그리고 오음계의 원리가 그것이다. 시작 음조를 달리하고, 음조의 순서를 반대로 바꾸어 재배열하는 방법 등으로 1400 년에서 1900 년대까지 만들어진 음악의 어떤 부분에 대해서도 그것의 바탕이 되는 구조를 찾아낼 수 있을 것이다. 이러한 생각을 바탕으로 하여, 비엔나의 작곡가 아놀드 슈엔베르그 (Arnold Schoenberg) 에 의하여 불붙기 시작한 음악에서의 혁명에 대하여 간략하게 알아보자. 그는 작곡에 있어서 완전히 새로운 규칙을 알아냈다.
1917 년, 아놀드 슈엔베르그는 자신이 더 이상 새로운 작곡을 할 수 없음을 깨달았다. 전통적인 음조법에 뿌리를 둔 그의 음악은 음계나 하모니 같은 고전적인 음악 구조에 기초함이 없이 주로 직접적으로 감정을 표현하는 방식이었다. 결국에는 그의 감정조차도 더 이상 그의 작곡을 지탱할 수 없게 되었으며, 수년 동안 어떤 형태의 음악도 만들어 내지 못했다.
그러나 그는 1923 년에 음악에 대한 새로운 아이디어를 가지고 음악 세계로 되돌아 왔다. 그는 7 개의 음조를 사용하여 장음계와 단음계에 기초한 전통적인 음조법 대신에 12 개의 음조를 모두 사용하는 음계에 기초한 작곡법을 사용할 것을 제안하였다. 그가 제안한 작곡법에서 음계내의 12 음조는 모두 같은 정도의 중요성을 갖는다. 그는 더 나아가서, 12 음조가 곡의 주제를 나타낼 수 있는 하나의 열로 순서화 할 수 있으며 그것을 작곡의 기초로 사용할 수 있다고 주장하였다. 뿐만 아니라, 각각의 12 음조가 열 내에서 정확하게 1 번만 나타나도록 그것들의 순서를 정하는 것을 제안하려 시도하였다. 따라서, 음악 작품 속에서 음조는 열 내에서 그것이 나타나는 순서대로 사용될 것이며, 그 후 되풀이되어 연주될 것이다.
슈엔베르그는 작품 속 음악의 흐름을 조직하는 방법으로 음조법을 사용하지 않았다. 대신에, 그는 작품을 하나로 통합하는 수단으로 동일한 음조 열을 반복적으로 사용하였다. 이러한 과정에서 각각의 음조는 음조 열 속에서 자신이 어디에 위치해야 하는가를 결정하는 역할을 담당하며, 동시에 작품이 여러 개의 음조 열을 포함하는 경우 각 음조 열의 위치를 정하는 역할도 담당한다. 슈엔베르그에 의하여 창시된 이러한 작곡법을 12 음 기법이라 부르며, 많은 현대 음악의 기초를 이루고 있다. 이러한 새로운 작곡법이 어떤 것인가를 조금만 자세하게 알아보도록 하자.
12 개의 음조 열 1, 8, 3, 10, 5, 12, 7, 2, 9, 4, 11, 6 로 구성된 순환 오음계는 음조 음악의 정수를 보여주는 좋은 예이다. 순환 오음계를 사용하는 작곡법에서는 이 음조 열을 되풀이하여 사용한다. 그러나 슈엔베르그 양식의 12 음 작곡법에서는 새로운 음악적 언어를 사용한다. 즉, 이 기법에서는 음조 구간의 길이가 고정된 7 개의 반음을 사용하는 순환 오음계처럼 단순하지가 않다. 슈엔베르그의 12 음 기법을 이해하기 위하여 그의 작품 23 번에 대하여 보다 자세하게 알아보자. 작품 23 은 음조 열 2, 10, 12, 8, 9, 7, 11, 3, 5, 4, 1, 6 을 사용한 것이다. 이 음조 열을 보면, 순환 오음계와는 달리 각 음조의 구간 크기가 상수 +7 이 아님을 알 수 있다. 이 음조 열에서의 음조 구간 크기는 +8, +2, -4, +1, -2, +4, -8, +2, -1, -3, +5 이다. 그림 12 는 이러한 일정하지 않은 구간 크기를 시계 문자판에 대응시켜 나타낸 것이다.

[그림 12] 작품 23 번에 사용된 음조 열의 음조 구간
동일한 12 음조를 반복적으로 되풀이하는 것은 듣는 사람을 금방 지루하게 할 것이 분명하다. 그러나 슈엔베르그의 작곡 체계는 다양한 변화를 허용하며, 작곡가로 하여금 자신의 작품 속에 참신함과 놀라움을 채워 넣을 수 있도록 한다. 예를 들어, 각 음조들은 앞으로, 뒤로, 뒤죽박죽으로 연주될 수 있으며, 뒤로 그리고 꺼꾸로 연주될 수 있기까지도 하며, 일찍이 바하 (Bach) 나 베토벤 (Beethoven) 같은 작곡가가 음조법에 기초하여 만든 음악에 사용된 모든 기법으로 연주될 수 있다. 게다가 이 음조 열은, 음조 구간의 크기는 그대로 유지하면서도, 다른 음조 열로 치환될 수도 있다. 이러한 변화에 대한 예로서 작품 23 의 뒤죽박죽 형태의 음조 열 2, 6, 4, 8, 7, 9, 5, 1, 11, 12, 3, 10, 1 을 들 수 있다. 이것은 작품 23 에 사용된 음조 구간 크기의 부호를 + 는 - 로, - 는 + 로 바꾸어 만든 음조 열이다.
앞서 다루었던 음조법에 기초한 음악과 슈엔베르그의 비 음조적인 체계에 대한 분석은 모든 음악을 일종의 형식적이며 추상적인 시스템으로 간주할 수 있다는 것을 보여준다. 언뜻 임의적으로 보이는 음악조차도 기초가 되는 체계를 가지고 있다. 간단하게 말해서, 음악을 하나의 대화 수단으로 본다면, 작곡가와 청중이 공유하는 일련의 규칙이 반드시 있을 것이고, 그것을 통하여 작곡가와 청중의 대화 즉, 음악적이며 예술적인 교감이 가능한 것이다. 그렇다면, 원칙적으로 그 규칙들과 컴퓨터를 이용하여 바하 혹은 바하 양식의 음악을 작곡하지 못할 이유가 없다. 실제로 칼하인즈 스톡하우센 (Karlheinz Stockhausen), 피에르 불레즈 (Pierre Boulez), 그리고 고트프리드 미카엘 쾨니그 (Gottifried Michael Koening) 같은 소수의 현대 작곡가들은 이미 그것을 해왔으며, 흥미를 가진 독자들은 이 책의 참고 문헌을 통하여 그것에 대하여 더 자세하게 알 수 있을 것이다. 이제 이러한 규칙에 기초한 시스템에 대한 개념을 청각적 예술 분야가 아니라 시각적 예술 분야에서 찾아보도록 하자.
앞서 바이오모프들이 성장하는 것에서 알 수 있듯이, 돌연변이, 재생산, 및 선택이라는 진화의 원리에 바탕을 둔 절차들은 무척이나 다양한 형태들을 생성하는 수단으로 사용될 수 있다. 이러한 형태들은 특별한 생물학적 구조를 취해야 한다는 제약이 필요하지 않을 뿐만 아니라, 일찍이 지구상에서 볼 수 있었던 형태일 필요도 없다. 그것들은 완전히 독창적인 예술 활동을 선도할 수 있다. 그것에 해당하는 한가지 사례를 알아보도록 하자.
수년 전, 컴퓨터 과학자 칼 심스 (Karl Sims) 는 LISP 프로그래밍 언어 (역주 : LISP 은 List processing 에서 나온 것으로, 기호 처리를 위한 대표적인 인공지능 프로그래밍 언어이며, LISP 언어에서는 문장을 표현식이라 부른다. 여기에 대응되는 것으로 논리적 추론을 위한 Prolog 라는 인공지능 프로그래밍 언어가 있다.) 에서의 표현식을 진화적 절차의 유전형으로 취급하자는 생각을 하게 되었다. 그리고 그것이 컴퓨터를 통하여 실행될 때, 실행의 결과를 LISP 표현식에 의하여 생성된 표현형으로 간주하였다. 심스의 의도는 이러한 기호 표현식을 이용한 진화적 절차를 만드는 것이었다. 그의 에상은 적중하여 LISP 표현식은 프로그래머가 그 식의 결과가 그러하리라고 상상한 한계를 뛰어넘는 진정 새로운 발생 규칙이나 매개변수 값을 출현시킬 가능성을 제공한다. 여기서 프로그래밍 언어 문장으로서 표현식이 갖는 정확한 의미는 더 이상 중요한 것이 아니며, 그것들은 단지 특정한 값을 입력으로 받아 흑백 혹은 자연색 영상을 결과로 출력하는 것으로서 의미를 갖는다. 이제 심스가 단지 자신의 생각을 확인하기 위하여 사용한 몇 가지 표현식의 예를 살펴보도록 하자.
심스가 실시한 실험에서 LISP 표현식은 다음과 같은 함수들이 임의로 조합된 형태를 갖는다. (역주 : LISP 표현식은 연산자가 피연산자 앞에 나오는 전위 표기법을 사용한다. 따라서 아래 함수 5 는 X and Y 를 나타내며, 함수 3 은 X 의 절대값 즉, |X| 를 나타내는 함수이다. 또한 이 책의 원 저자는 함수와 표현식을 거의 같은 뜻으로 사용하였다).
1. X
2. Y
3. (abs X)
4. (mod X (abs Y))
5. (and X Y)
6. (bw-noise .2 2)
7. (color-noise .1 2)
8. (grad-direction (bw-noise .15 2) .0 .0)
9. (warped-color-noise (* X .2) Y .1 2)
그림 13 은 위 9 개의 표현식으로 생성한 그림을 나타낸다. 모든 그림은 초기에 검은 사각형이었으며, 그림은 왼쪽에서 오른쪽, 위에서 아래의 순서로 배열되었다.

[그림 13] 표현식 1~9 로 생성한 그림 (컬러 사진 4)
심스는 실험에서 우선 이러한 함수들을 무작위적으로 결합한 LISP 표현식을 생성하였다. 그런 후 이러한 표현식은 LISP 해석기에 의하여 그림으로 변환된다. 즉, 표현식을 기호로 표현된 유전형이라 가정하면, 그것은 LISP 해석기에 의하여 대응되는 표현형 즉, 그림으로 바뀌는 것이다. 모든 LISP 표현식은 트리 구조로 다시 나타낼 수 있다. 따라서, 그러한 수식에 대한 돌연변이 연산은 표현식에 대응하는 트리를 노드단위로 순회하면서 적당한 돌연변이를 적용하면 된다. 그러한 돌연변이의 전형적인 예로는 (abs X) 와 같은 함수를 다른 함수, 예를 들어, (cos Y) 로 교체하는 것이다. 더 나아가서 기호 표현식은 두 개의 (부모) 표현식을 "성적 결합" 에 의하여 다양한 방법으로 재결합함으로써 새로운 (자식) 표현식으로 재생산 될 수도 있다. 그림 14 는 좌측 상단 모서리 그림을 부모로 하여 19 가지 돌연변이를 적용하여 생성한 그림들을 나타낸다. 실제로 심스가 사용한 실험은 3 차원 그림이었으며, 여기서는 단지 그것의 표면만을 나타냈을 뿐이다.

[그림 14] 부모와 19 개의 돌연변이들 (컬러 사진 5)
임의로 생성된 게놈 (개체를 나타내는 유전형) 에서 출발하여 그것에 다양한 유형의 돌연변이를 적용하고, 그것들 중에서 다음 세대에 생존할 돌연변이체를 심스는 스스로 선택하였다. 즉, 자연의 역할을 심스가 담당한 것이다. 그러한 단순한 과정을 5 내지 20 회 반복한 후에는 놀랄만한 그림들이 출현한다. 그림 15 (a-c) 는 심스의 작품집 중의 일부를 대응되는 LISP 유전형과 함께 나타낸 것이다. 그림 (c) 의 경우 심스가 자신의 프로그램에 유전형을 저장하는 부분을 포함시키기 이전에 만든 것이기에 유전형이 나타나 있지 않다. 따라서 이 그림의 경우 우리는 그것을 진화에 의한 예술 세계에서 멸종된 것으로 (역주 : 즉, 멸종되어 더 이상 유전자를 채취할 수 없는 것으로) 간주할 수 있다. 어찌 되었거나 이제 우리는 그림 (b) 와 같은 복잡한 예술 작품이 어떻게 186 개의 알파벳으로 생성되었는가를 주목해야 한다. 우리는 다음 장에서 시스템의 복잡성에 대하여 보다 상세하게 논의할 것이다.

[그림 15] 진화의 산물과 대응되는 유전형 (컬러 사진 6)
언어, 음악, 및 그림에 있어서 규칙이 어떻게 그것을 제어하는가에 대한 앞서의 예들은 그러한 규칙 즉, 프로그램을 컴퓨터 속에 구체화하는데 아무런 장애가 없음을 보여준다. 결국 우리는 기계에 의한 창조의 가능성을 이해하게 되었다. 컴퓨터는 계산의 수단뿐 아니라 창조의 수단이 될 수 있다. 이어지는 내용들에서 우리는 이것을 더 잘 알게 될 것이다. 우선, 우리의 주제인 "시뮬레이션을 통하여 컴퓨터 속에 대리 세상을 생성하기" 로 되돌아가기로 하자.
1980 년대 중반 컴퓨터 게임 시장에 출현한 힘의 균형이라는 시뮬레이션은 많은 아마추어 전략가를 낳았으며, 그들이 정부의 실력자인양 세계를 하나로 통일하고 유지하는 기술을 시험할 기회를 제공하였다. 이 게임은 사용자로 하여금 실제와 같은 정국 시나리오 혹은 국제적인 위기상황 등을 창조할 수 있도록 한다는 전에 없던 기능을 제공한다는 점 외에 이 게임의 제작자인 크리스 크로포드 (Chris Crawford) 가 이 게임에 대한 책을 집필한 것으로 유명하다. 이 책에는 게임의 내부구조가 상세하게 기술되어서 사용자가 알기를 원하는 거의 모든 내용이 포함되어 있으며 따라서, 사용자는 이것이 어떻게 동작되는 것인가를 분명하게 알 수 있다. 시뮬레이션에 대한 기본적인 원리를 통하여 게임의 동작에 대하여 간략하게 알아보도록 하자.
힘의 균형은 현대 지리정치학에 관한 게임이다. 이 게임이 출현한 1980 년대는 냉전이 종식되기 이전이었으며 따라서, 게임 속의 인물은 미국의 대통령과 소련의 공산당 서기장이고, 각자는 핵전쟁을 일으키지 않고 자기 국가의 국위를 강화하는 것이 게임의 목표다. 국위를 강화한다는 것은 국가의 이익을 증진시키고 다른 나라의 존경을 받는 것을 의미한다. 그 나라가 행사할 수 있는 힘은 다른 나라로부터 존경받음으로써 생기는 국위의 강화에 비례하며, 게임 진행자의 목적은 다수의 강력한 동맹국과 소수의 나약한 적을 갖는 상태를 유지하는 것이다.
날마다 접하게 되는 국제 동향을 통해 알 수 있는 것처럼, 거의 모든 국가의 안정은 상이한 지리정치학적 사건에 따라서 위협을 받는다. 어떤 경우에는 폭력을 행사하여 기존의 체제에 도전하는 폭동이 일어나는가 하면, 군사적인 수단이나 혹은 다른 수단에 의한 구데타 (coup d'etat) 에 의하여 하룻밤 사이에 정권이 바뀌기도 한다. 다른 경우로는 정치적인 협박을 통하여 한 국가가 초강대국에 "핀란드화" (역주 : Finlandize, 구 소련이 핀란드를 협박하여 대소유화정책을 펴도록 한 것에서 유래) 되기도 한다.
국위를 강화하기 위하여 내리는 결정들은 모두 우호 관계를 고착화하거나 아니면 적대 관계를 개선하려는 방법에 바탕을 둔다. 예를 들어, 현재 적대 관계에 있는 국가가 내부 게릴라들과 전투중이라면, 반군들에게 무기를 공급하거나 혹은 반군을 지원하는 군대를 투입할 수 있다. 만일 반군이 정부군을 몰아내는데 성공한다면, 반군의 지도자는 자신들을 지원한 것에 대한 보상으로 우호 관계를 강화할 것이며 결과적으로 국위가 강화된다.
독자들이 컴퓨터를 대상으로 이 게임을 하는 경우, 컴퓨터 역시 독자의 우방을 무력화할 목적으로 유사한 행동을 취할 수 있다. 즉, 독자들의 우방국가에서 일어난 반란을 지원할 수 있다. 이 경우는 우방을 보호하기 위해서 무기를 수송하거나, 경제적 지원을 통하여 사회적 불안을 완화하는 방법으로 반란군이 우방을 밀어내지 못하도록 할 것이다.
힘의 균형 게임을 하는데 있어서 게이머는 세계의 어떤 국가든 선택할 수 있으며, 앞에서 예로 든 어떤 형태의 정책이라도 취할 자유가 있으며, 상대방도 마찬가지이다. 그러나 어떤 결정이든지 상대방이 그것에 반대하여 그 결정을 취소하라고 요구할 수 있다는 점에서 모든 결정은 상대방의 묵인을 받지 않으면 안 된다. 이것은 곧 하나의 위기를 초래하게 된다. 게이머는 상대의 요구를 받아들여 결정을 철회함으로서 권위를 잃을 수 있고, 단호한 의지로 상대의 요구를 거절함으로서 위기를 확대할 수도 있다. 후자의 경우 즉, 게이머가 상대의 요구를 거절할 경우 불명예는 반대로 상대방에게 돌아가게 되며, 상대는 그 역시 한 발 물러서거나 반대로 적대감을 더욱 확대시킬 수도 있다. 이러한 위기의 확대 혹은 결정의 철회는 한쪽이 권위를 손상 당한 채 물러나거나 아니면 위기가 확대되어 결국에는 미사일이 날아가는 국제적인 긴장 수준인 "데프콘 원 (DefCon 1)" 이 발동될 때까지 계속될 것이다. 이 지경이 되면 세상은 핵전쟁이라는 아마게돈으로 파괴되고 두 게이머는 모두 패자가 된다.
게이머가 어떤 행동을 취할 것인가를 결정하고, 상대방이 취할 수 있는 반응을 알아내는 것을 돕기 위해서 이 게임은 대단히 많은 지도와 경제, 사회, 정치, 및 군사에 대한 데이터베이스를 제공한다. 그림 16 은 그러한 시각적 도움의 예로써, 특정 시점 (이 경우는 1986 년) 에 전 세계에서 발생된 다양한 유형의 무장 반란을 나타내는 지도다. 이러한 정보의 모임은 세상에 대한 간결한 스냅 사진인 셈이다. 즉, 세상의 나라를 특성 짓는 무장 폭동, 국내 정세, 외교 노선, 및 많은 다른 요소들을 제공한다. 이 게임은 이러한 정보를 제공함으로서, 지리 정치적인 의사를 결정하는데 필요한 타협의 본질을 획득하기에는 충분히 복잡하지만, 집에서 적당한 시간안에 즐기기에는 충분히 간결한 절묘하게 절충된 모의실험을 가능하게 한다.

[그림 16] 세계 무장 반란 (1986)
힘의 균형은 소위 말하는 하향식 모의실험에 대한 예이다. 즉, 개별적인 에이전트들의 행동이 아니라, 의사 결정의 결과를 결정하는 기본적인 변수들이 수집되어 수량화된다. 이것의 의미를 명확하게 하기 위하여 구데타에 대하여 생각해 보자. 실세계에서 구데타는 불만을 품은 한 무리의 군중들이나 강력한 군사 및 정치력을 가진 소수 집단의 개별적인 의사결정의 결과로 일어난다. 즉, 실세계를 구성하는 개체들의 개별적인 의사 결정의 결과라는 것이다. 그러나 이 게임에서는 미국의 대통령이나 소련의 서기장 즉, 게이머를 제외한 개별적인 세계 구성원의 세세한 행위들이 반영되지는 않는다. 이 시뮬레이션 게임을 통한 실험에서 구데타의 시도 여부는 "만일 정부에 대한 지지율이 미국의 불안정 및 소련의 불안정 값의 합보다 작으면 구데타를 개시하라" 와 같은 단순한 규칙에 의하여 결정된다. 여기서 정부의 지지율을 정하는 변수인 미국과 소련의 불안정 값은 국민 일인당 소비량, 국민 총 생산량, 인구, 및 경제 원조 등과 같은 다른 변수들이 수집되어 정해진다. 무장 폭동이나 대소 우화정책 등과 같은 주요한 수량 역시 동일한 방식으로 결정된다.
모의실험에서 변수 값을 수집하여 사용하는 것은 1 장에서 모델의 충실함을 설명할 때 언급한 것과 동일한 의문을 일으킨다. 어떻게 힘의 균형과 같은 모의실험이 지리정치학적 절차의 역학을 생생하게 파악하도록 할 수 있는 것인가? 이 의문에 대하여 어떤 느낌을 얻기 위해서 개인용 컴퓨터로 흔히 즐기는 저가의 비행 시뮬레이터에 대하여 생각해 보자. 이러한 프로그램에서 사용하는 상승력, 고도, 및 항속 등과 같은 기본적인 요소들은 항공사나 공군에서 조종사들을 훈련시키기 위하여 사용하는 비행 시뮬레이터에서 사용하는 것과 동일한 것이다. 그렇다면 그러한 수백만 달러 짜리 시뮬레이터와 가정용 컴퓨터에서 실행되는 시뮬레이터는 어떻게 다를까?
이 의문에 대한 답은 크리스 크로포드의 "세부적으로 그럴싸함" 이라는 문구에서 찾을 수 있다. 예를 들어, 만일 모의실험중인 비행기가 10,000 피트 상공을 공격 각 10 도로 200 노트의 속력으로 날고 있을 때 저가의 시뮬레이터에서는 결과로서 생기는 양력을 아주 정밀하게 계산할 필요는 없다. 그저 현재의 비행 상황을 올바로 느낄 수 있으며, 충분히 즐길 수 있을 정도의 합리적인 근사값을 구하면 된다. 이와는 반대로 전문적인 시뮬레이터는 양력을 매우 정확하게 계산해야 한다. 만일 조종사가 대충 계산한 양력으로 인하여 상황에 잘못 반응하도록 훈련된다면 그 혹은 그녀는 실세계의 동일한 상황에 대하여 그러한 잘못을 되풀이 할 것이며 아마도 비극적인 결과를 낳을 것이다. 따라서, 신중한 모의실험을 위해서는 세부적인 사항에 대하여 일정한 수준의 정확성이 요구된다.
상황에 대한 있는 그대로의 모델과 그렇지 않은 모델 사이의 또 다른 차이는 모델이 실제의 어떤 특징을 얼마나 과장하느냐에 대한 것이다. 예를 들어, 힘의 균형에서 게이머는 항상 분명한 갈등 상황을 접하게 된다. 그러나 갈등이 실세계에 있어서 본질적인 요소인 반면에, 우리 인간은 그러한 갈등을 완화하고, 직접적인 대결에 의존하지 않고 갈등을 해결하기 위하여 많은 사회적 인내와 심리적인 규제들을 개발하여 왔다. 따라서, 힘의 균형과 같이 상업적인 성공을 얻으려는 모델들은 실세계에 존재하는 인내를 무시하고 갈등 상황을 과장하여야 한다.
마지막으로 시뮬레이션이 제공하는 현실감은 데이터가 실제적인가가 아니라 과정이 실제적인가에 의하여 측정된다. 흔히 많은 사람들은 데이터가 실제적인가를 중요한 것으로 생각하는 경향이 있다. 예를 들어, 사람들은 국민 총생산 양이 올바른지 아닌지 혹은 가구당 TV 개수가 올바른지를 궁금해한다. 그러나 데이터는 모델의 현실감을 측정하는 가장 중요한 요소는 아니다. 현실감을 측정하는 가장 중요한 요소는 바로 과정이다. 힘의 균형과 같은 게임에 있어서 호주의 실제 국민 총생산 양은 중요한 것이 아니다. 중요한 것은 시간이 경과하면서 그것이 어떻게 변하는 가이다. 중요한 것은 시간이 경과하면서 그것이 어떻게 변하는 가이다. 만일 우리의 자손이 지금으로부터 100 년 후에 지금의 우리를 되돌아본다면 우리가 현재 이라크와 다투고 있는 것을 터무니없고 부적절한 것으로 이해할 것이다. 그러나 현재 우리와 이라크와의 관계를 지배하는 것과 동일한 원칙과 절차는 그때도 여전히 유효할 것이다. 결국 요점은 실험자가 사실을 바탕으로 모델과 작용하는 것이 아니라는 것이다. 실세계나 모의실험되는 세계에서 사실은 수동적인 요소에 불과한 것이다. 그러나 실험자는 과정을 통하여 모델과 작용하고 궁극적으로 그것을 이해할 수 있다. 크리스 크로포드 이것을 "컴퓨터는 데이터 프로세서가 아니라 데이터 프로세서다" 라고 표현하였다.
이러한 기준에 의하면 힘의 균형과 같은 하향식 모의실험은 세부적인 측면의 그럴싸함이 단지 보통 수준인 것이다. 즉, 이 모델은 과정에는 강하지만 사소한 세부적인 사항에는 다소 약한 모델이다. 그리고 이것이 이 모델을 실제 세계에서 일어나는 사건에 대하여 의사 결정을 내리는데 사용하는 경우 실제와 차이를 일으키는 원인이 된다. 이러한 차이는 주택에 대한 그림과 설계도의 차이와 유사한 것이다. 그림은 대상에 대항 감성적인 영향을 미치는 것이고, 반대로 설계도는 건축가에게 대상의 정확한 구조를 전달하는 것이다. 그러나 이러한 구분이 하향식 모의실험은 단지 "실제 사물" 을 낮은 수준으로 묘사하는 것이라는 의미를 갖는 것은 아니다. 이것이 포괄적이며 덜 정량적인 측면을 강조한다는 것이다. 결국, 주택을 건축하는 데에 그림을 사용해서는 안될 것이며, 같은 맥락에서 독자가 젊은 시절을 보냈던 주택에 대한 정서적 감정을 전달하는 데 설계도를 사용해서도 안될 것이다. 하향식 모의실험과 그것에 반대되는 상향식 모의실험이 전하고자 하는 메시지는 전혀 다른 것이다. 상향식 모의실험은 기술적인 정보를 세부적으로 전달하려 할 때 사용하는 것이고, 하향식은 예술적인 표현에 가까운 그 무엇을 전달하려 할 때 사용하는 것이다. 이제 두 가지 유형의 모의실험이 갖는 차이를 명확하게 이해하기 위하여 특정한 상향식 모의실험에 대하여 알아보도록 하자.
많이 알려진 것은 아니지만, 1900 년 파리 대학에서 발표된 한 논문에서, 루이 바셀리에 (Louis Bachelier) 는 현대 경제 이론에 대한 수학적 기초를 발표하였다. 바셀리에에 의하면, 주식시장에서의 가격 변동은 임의적이며, 단지 시장으로 유입되는 새로운 정보에 의하여 결정되는 것이다. 그러나 이 정보가 예측 불가능한 것이기 때문에 (그렇지 않다면 정보가 아니다) 가격은 완전히 임의적으로 오르락내리락 한다. 이러한 주장은 소위 말하는 효율적 시장 가설을 낳았다. 효율적 시장 가설이란 공공연하게 알려진 정보는 즉각적으로 주가에 영향을 준다는 것이다. 따라서, 과거의 가격 변동 및 많은 거래 정보를 바탕으로 하거나 그와 유사한 거래 시스템을 사용하면 실패하게 마련이라는 것이다. 간단하게 말해서, 과거의 거래 정보를 토대로 하는 신뢰할 만한 기술적 투자 방법은 존재할 수 없다는 것이다. 다른 한편으로, 바셀리에의 생각에 완벽하게 동조하는 이성적인 투자가들로 구성된 주식시장이라는 세계에서 주식의 거래량은 적을 수밖에 없고, 시장 분위기 따위의 심리적 요인이 영향을 줄 수 있는 여지가 없으며 따라서, 파산이라든가 주가의 거품 따위가 발생할 수도 없다. 그러나 재미있게도 그러한 일들은 윌스트리트에서 실제로 일어나고 있다.
증권 거래소의 투자가들이 기술적인 거래가 불가능하다는 프랑스 파리에서의 메시지를 잊지는 않은 것 같다. 그들은 마치 주식시장을 예측 가능한 것으로 믿고 있는 것처럼 행동한다. 즉, 그러한 기술적 지표와 본능을 토대로 한 투자가, 단순히 다우존스 산업 평균을 구성하는 30 개 기업의 주식을 구매하여 얻는 이득을 항상 초과할 것이라고 믿고 있는 것 같다. 이러한 투자가들에 의하면 주식시장은 인생살이와 같이 변동하는 복잡한 실체다. 돈을 벌기 위해서는 단순히 시장의 심리에 자신을 조율하고 거기에 따라 행동하라는 것이다. 그렇다면 시장에 대한 서로 상반되는 두 견해를 어떻게 평가할 것인가? 바셀리에의 학술적인 이론이 옳은 것인가? 그렇다면 주식투자라는 것이 단지 동전 던지기에 불과한 것인가? 아니면, 영리한 주식 중개인이 자신과 타인의 돈을 투자하여 자신의 생계를 유지하는 것인가?
최근까지는, 이러한 시장의 원리에 대한 상반되는 이론을 평가하는 것이 실제로 가능하지는 않았다. 그것이 불가능한 주된 원인은, 뉴욕 증권 거래소 등에서 얻은 투자 규칙이나 이자율을 사용하는 학문적인 실험이 전세계의 투자가 및 중개인은 말할 것도 없고 증권 회사 및 증권 거래소의지지를 받지 못했기 때문이다. 그러한 실험은 원하는 방식으로 적절하게 통제할 수가 없었으며, 반복적으로 되풀이 될 수도 없었다. 따라서, 다양한 상황에 반응하여 주가가 어떻게 변동하는가에 대한 여러 가설들을 과학적으로 조사하는데 필요한 검사가 될 수가 없었다. 하지만 그러한 좋지 않은 시대는 이제 끝났다.
1987 년 가을, 스탠포드 대학 경제학자 브라이언 아서 (W. Brian Arthur) 와 미시간 대학 컴퓨터 과학자 존 홀란드 (John Holland) 는 산타페 연구소를 방문한 동안 같은 집에 기거하고 있었다 (역주 : 아서는 노벨 경제학상을 수상한 세계적인 경제학자로 양의 되먹임 (positive feedback) 이라는 획기적인 개념을 제시한 인물이고, 홀란드는 유전자 알고리즘 (genetic algorithm) 을 고안하여 생물학적 유전자 및 진화를 컴퓨터 과학에 도입한 인물이다). 저녁시간에 많은 양의 맥주를 마시며 끝없이 이어진 대화를 통하여, 아서와 홀란드는 컴퓨터 속에 인공 주식시장을 창조하자는 생각에 도달하게 되었다. 그들은 그것이 수년동안 사람들이 궁금해하거나 두려워 해 온 많은 경제 문제에 대한 해답을 제공할 수 있을 것으로 기대했다. 많은 사람들이 의문을 갖고있는 문제들이란 다음과 같은 것들이다.
아서와 홀란드는 경제에 대하여 많은 사람들이 터득하고 있는 지혜를 알고 있었다. 그것은 "오늘의 주가는 단지 내일 주식가격의 할인 기대치에 배당금을 더한 것이었다" 라는 것이다 (역주 : 다소 어려운 표현이지만 무슨 말이냐 하면 내일의 주가는 내일이 되어서 생각해 보면 어제의 주가가 반영된 것이라는 뜻이다). 가격 결정 절차에 대한 이러한 이론은 내일의 주가를 예측하는데 오늘 주가를 객관적으로 사용할 수 있는 방법이 있다는 가정을 배경으로 하는 것이다. 그렇지만, 이런 정보는 결국은 (내일의 입장에서는) 전형적으로 과거의 가격, 거래량, 경제 지표 등으로 구성된 것들이다. 따라서, 내일의 주가를 예측하기 위하여 과거 정보를 통계적으로 처리하자는 가정에 배경을 둔 완전히 다른 많은 방법들이 존재한다. 예를 들어, "내일 주가는 오늘 주가와 같을 것이다" 라고 할 수도 있고, 아니면 "내일 주가는 오늘 가격을 배당 비율로 나눈 것과 같을 것" 이라고 예측할 수도 있으며, 얼마든지 다양한 예측을 내릴 수 있다.
주어진 정보를 유일하면서 최적으로 처리할 방법이 없다는 단순한 관찰을 통하여 아서와 홀란드는 가격을 예측하는 연역적인 방법들은 기껏해야 학술적인 소설에 지나지 않는다는 그리 놀라울 것도 없는 결론을 내렸다. 주식시장의 모든 투자가가 동일한 방법으로 예상 가격을 산출하지 않을 가능성이 있다는 명백한 사실을 인정하기만 한다면, 주가를 예측함에 있어서 고정된 규칙에 의존하는 고전적인 경제 이론에서 사용하는 연역적인 접근법은 여지없이 무너진다. 따라서, 투자가는 다른 투자가가 어떻게 가격을 예측하며 그들은 어떻게 행동하는가에 대한 자기 나름대로의 가정을 세워야만 한다. 그들은 시장을 꿰뚫어 보려 노력해야만 한다. 그러나 이것은 우리를 주관적 믿음의 세계로 인도하며, 그러한 믿음들을 믿도록 유도한다. 간단하게 말해서 그것은 우리를 연역이 아니라 특정한 관찰들에서 일반적인 규칙을 귀납적인 세계로 인도한다는 것이다.
이 절이 서두에서 언급한 질문에 대한 해답을 얻기 위하여, 아서와 홀란드는 물리학자 리차드 파머 (Richard Palmer), 경제 이론가 블레이크 르바롱 (Blake LeBaron), 주식 투자가 폴 테일러 (Paul Taylor) 등과 함께 전자 주식시장을 만들었다. 그 작업에서 그들은 결과적으로 신과 같은 힘으로 투자가의 전략, 시장의 여러 변수들, 및 실제 거래에서 행해질 수 없는 많은 다른 일들을 조작할 수 있었다. 이렇게 만들어진 인공의 대리 시장은 다음과 같은 요소들로 구성된다.
가. 고정된 단일 회사의 주식 수량;
나. 각 시간 주기에 주식을 거래하는 다수의 투자가들 (컴퓨터 프로그램) ;
다. 주식 전문가 (다른 컴퓨터 프로그램) : 주식시장 내에서 거래를 지원하는 자신만의 자원을 가지며, 시장에서의 수요와 공급을 관찰하고, 매입이나 매매를 위한 주문을 내거나 중재하는 방법으로 주가를 정하는 사람 ;
라. 채권과 같은 외부 투자 ;
마. 임의적인 패턴을 따르는 주식에 대한 배당금 추세.
그들이 만든 모델에서 투자가는 최근의 시장 활동 정보를 기술자 (descriptor) 집합을 요약하여 얻는다. 기술자는 주식시장을 "지난 주 내내 가격이 상승하였다", "주가가 기본값보다 높다", 혹은 "거래량이 많다." 와 같은 문장 형태로 표현하는 것이다. 우선, 이러한 기술자들에 A, B, C, … 와 같은 식별자를 붙이도록 하자. 투자가들이 주식을 살 것인지 팔 것인지를 결정하는 규칙을 기술자로 표현하면 다음과 같은 형태가 된다: "만일 주식 시장이 조건 A, B, C 를 만족하면 구매를 한다. 그러나 조건 D, G, S, 및 K 를 만족하면 일단 가지고 있는다." 투자가 각각은 이러한 형태의 규칙 집합을 가지고 있으며, 한 시점에 오직 하나의 규칙을 적용하여 의사를 결정한다. 투자가는 각자가 가지고 있는 이러한 규칙이 가장 정확한 규칙이라고 간주한다. 즉, 철저하게 이 규칙을 적용할 뿐이다.
이러한 인공적인 시장에서 주식을 거래해가면서, 투자가는 다음과 같은 두 가지 방법으로 자신이 가지고 있는 여러 가지 규칙들을 재평가한다. (가) 과거에서 적용하여 이득을 얻은 규칙들이 다음 번 의사 결정에 선택될 수 있는 확률 값을 크게 한다. (나) 성공적으로 적용된 규칙들을 조합하여 새로운 규칙을 만들고 시장에서 평가한다. 여기서, 두 번째 방법은 유전자 알고리즘이라는 것을 적용함으로써 가능하다. 유전자 알고리즘은 자연에서 교배를 통하여 동일한 종에 속하는 암ㆍ수 한 쌍의 유전 물질을 결합하여 새로운 유전 물질로 이루어진 자식 (부모의 유전 물질을 부분적으로 가지고 있는 자식) 을 생산하는 것을 모방한 것이다.
이러한 모의실험을 실행하기 위하여 초기에는 투자가들에게 임의로 규칙들을 배정하고, 과거 및 현재의 주식가격, 이자율, 및 배당금 등을 임의로 정한다. 그러면, 투자가는 초기에 정보가 없으므로 자신이 가지고 있는 규칙 중에서 임의로 하나를 선택하여 적용하는 것으로 인공 시장에서의 주식거래를 시작한다. 투자가는 최초의 거래에 대한 결과를 바탕으로 자신이 가지고 있는 규칙을 평가하고, (그 규칙의 적용 확률과 같은 매개변수를) 수정하며, 새로운 규칙을 생성한 후, 다음 거래에 사용할 최적의 규칙을 선택한다. 이러한 과정이 되풀이되면서, 투자가들은 주식을 팔고 사며, 채권에 투자하고, 규칙을 평가하여 그것을 수정하거나, 새로운 규칙을 생성하는 등의 행위를 함으로서 일반적으로 실제 주식시장에서와 마찬가지로 행동한다.
그림 17 은 인공 시장의 동작 화면을 나타낸다. 좌측 상단에서부터 시계 방향으로, 첫 번째 그래프는 시간에 따른 주식가격과 배당금을 나타내는 것으로서, 현재의 주가는 검은 선으로 나타나며 회색 영역의 최고 값들은 현재의 기본값을 나타낸다. 그래프에서 검은 선이 회색 영역보다 높은 값을 갖는 영역은 그 기간 주가에 거품이 있다는 것을 나타내는 것이다. 반면에, 검은 선이 회색 영역보다 상당히 낮은 영역은 그 기간에 주식시장이 큰 혼란 상태임을 나타내는 것이다. 상단 오른쪽 그래프는 각 투자가들의 상대적인 보유 자산을 나타내며, 우측 하단의 그래프는 각각이 현재 소유한 주식의 정도를 나타낸다. 좌측 하단의 그래프는 거래량을 나타내는 것으로 여기서, 회색은 팔려는 주식의 양을 나타내며 검은색은 살려는 주식의 양을 나타낸다 (역주 : 그래프에서 팔려고 내놓은 주식의 양이 사려는 주식의 양보다 엄청나게 차이가 나는 영역이 첫 번째 그래프에서 주식시장이 큰 혼란에 빠진 시기와 일치함을 확인해보라). 물론 거래가 가능한 주식의 총 수는 두 값 중에서 작은 값만큼이다. 화면에있는 많은 버튼들은 실험자가 임의로 정할 수 있는 시장에 대한 매개 변수들을 위한 것이다.
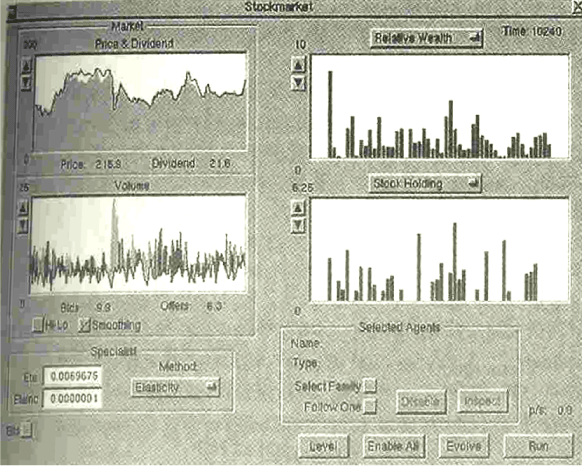
[그림 17] 인공적인 대리 주식시장
한 동안 거랙 이루어지고, 투자가가 자신의 의사를 결정하는데 사용하는 규칙들을 수정한 후에 나타나는 결과는 마치 야생의 생태계와 유사하다. 각 투자가는 자신의 의사 결정을 위하여 나름대로 독자적인 규칙들을 사용하며, 주식의 가격은 항상 기본값에 대하여 임의적으로 진동하며 안정화된다는 것을 관찰할 수 있다. 또한, 이러한 요동 내부에서는 매우 풍부한 행태들이 발견된다. 즉, 주가의 거품과 그에 따른 폭락, 시장의 분위기, 가격 변동에 대한 과민 반응 등과 같이 실제 주식시장에서 나타나는 다른 많은 일들이 일어난다.
또한 실제 시장에서와 마찬가지로, 인공 주식시장에서의 포식자 (투자가) 들은 지속적으로 진화한다. 즉, 모든 상황에서 항상 승리하는 (최적의 선택을 하는) 단일의 포식자 (투자가) 가 찾아지는 경우는 발견되지 않았다. 어떤 시점에서의 최적의 결정은 그 시점이 다른 투자가의 결정에 결정적으로 영향을 받았다. 게다가, 실제 포식자 집단에서 나타나는 것처럼 감각적 방법과 기술적인 분석법이 상호 작용하여 서로를 보강한 규칙이 나타남을 발견하였다. 이것들은 마치 주식시장이 자신의 비밀을 털어놓기라도 하듯이 출현한 새로운 규칙들이다. 이제, 상향식 모의실험의 가장 중요한 특징의 하나에 창발적 (emergent) 현상에 대하여 간략하게 알아보자.
1987 년 10 월 19 일 월요일, 뉴욕 증권 거래소 (NYSE) 는 증권 거래 역사상 최악의 고통을 겪었다. 그날 거래소의 모든 주식의 가격이 무려 22.6 퍼센트나 하락하였다. 이러한 재앙이랄 수밖에 없는 주식시장의 붕괴가 발생한 후 곧바로, 검은 월요일에 발생한 무차별 팔기를 막기 위하여 뉴욕 증권 거래소 집행 위원회는 소위 유통-차단 (circuit-breaker) 이라 부르는 규칙을 정하였다. 이 규칙은 전날에 대비하여 다우존스 산업 평균이 50 포인트 이상 오르거나 내리는 거래를 규제하는 것이다. 이 규칙들이 공표 되었을 때, 과연 투자가들이 맹목적으로 혼란한 시장에 뛰어들어 남들이 하듯이 마구 주식을 팔겠다고 내놓지 않고, 잠시 멈춰 서서 사태를 심사 숙고하게 한다는 본래의 의도를 충족할 수 있는지가 불분명하였다. 사실 상당히 많은 시장 전문가들은 이 규칙들이 시장의 혼란을 진정시키기는커녕 오히려 악화시킬 수 있음을 우려하였다. 그러나 그 이후에 주식시장에서 유통-차단 규칙들이 과열된 시장을 실제로 진정시키는 것처럼 보여왔기 때문에 그러한 우려가 발생하지는 않았다.
그렇다면, 앞으로도 그러한 우려는 실제로 발생하지 않을 것이라고 장담할 수 있을까? 답은 "아니다" 이다. 주식시장에 부여된 유통-차단 규칙들은 단순히 증권 거래소 관리자 입장에서 계산해낸 위험 해소 책인 것이다. 재정적 시장은 복잡계에 대한 완벽한 예에 해당된다. 복잡계와 단순계를 차별하는 특징 중에서 무엇보다도 중요한 것은 복잡계는 이상하거나, 놀랍거나, 순수한 직관에 위배되는 동작 방식을 보인다는 것이다. 대개 이러한 놀라운 동작 방식은 창발성이라는 현상에 그 원인이 있다. 창발성은 상호작용하는 다수의 구성원 (개체) 으로 형성된 계에서 발생하는, 계의 전역적인 동작을 나타내는 전문용어로써 시스템 이론에서 주로 사용된다. 복잡계의 창발적 동작은 예측할 수 있는 동작이 아니며, 계를 구성하는 개개의 성분을 독립적으로 분석하여 알아낸 지식들로부터는 만들어 낼 수 없는 동작이다. 날마다 수도꼭지에서 똑똑 떨어지는 물은 화학에서 발견되는 창발성에 대한 간단한 예다. 물은 두 개의 수소 분자와 한 개의 산소 분자로 구성되었다. 두 분자 모두 가소성을 지닌 반응성 기체다. 그러나 (그렇게 잘 타는) 두 분자가 결합하여 생성된 물질 즉, 물은 타지 않는 액체이다. 여기서 물이 지닌 두 가지 성질 즉, 타지 않는 액체라는 성질은 두 분자가 상호작용한 결과가 창발해낸 것이다 (역주 : 즉, 개개의 구성원이 가지고 있지 않았으므로 그것들이 상호작용했을 때 나타날 것으로 결코 예상하지도 못한 동작이 그야말로 창조적으로 발현되는 것을 창발이라고 한다).
뉴욕 증권 거래소에서 생각해낸 유통-차단 규칙들이 잠재적으로 위험을 내포하고 있다고 볼 수밖에 없는 이유는, 기대하지 않던 (그리고 흔히 원하지 않는) 창발적인 행태가 발생할 가능성이 항상 존재하기 때문이다. 1987 년 당시는 거래를 규제하는 그 규칙들이 시장을 안정시키는 대신 오히려 더욱 악화시키지 않을지를 확인하려는 시장의 역학에 대한 실험을 안전하게 수행할 방법이 없었다. 아서 상회 (Arthur & Co.) 와 같은 마이크로 모의실험이 존재하는 지금, 그러한 과거는 더 이상 우리를 가로막는 장벽이 아니다. 요즘과 같은 첨단 과학 시대에, 우리는 자신의 컴퓨터에 인공의 대리 세계를 실제로 창조할 수 있으며, 그러한 대리 세계를 이용하여 주식시장과 같은 복잡계에 대하여 반복이 가능하고, 통제가 가능한 과학적 실험을 행할 수 있다.
창발 현상이 복잡계와 단순계를 구분하는 두드러진 특징임에는 의심의 여지가 없지만, 그렇다고 그것이 복잡계의 유일한 특징은 아니다. 앞서 설명한 인공 주식시장이라는 미시세계를 이용한 모의실험에서 복잡계에 대한 다른 많은 특징들을 발견할 수 있다. 주식 시장 외에 다른 유형의 인공 대리 세상들을 폭 넓게 다루기 전에 복잡성에 내재된 특징들을 먼저 자세하게 알아보자.