 aistudy 메인
ID3 : 이재규 외 : ID3 는 Ross Quinlan 이 개발한 학습방법으로서 어떤 개념에 관한 예와 반례로써 훈련집합 (Training Set) 이 주어졌을 때 이로부터 개념을 구별할 수 있는 의사결정 트리 (Decision Tree) 형태의 분류규칙을 생성시킨다. 여기서 분류하고자 하는 개념들을 클래스 (Class) 라 하고, 이 클래스에 관한 예는 해당 클래스를 한정된 수의 특성 (Property, Attribute) 으로써 묘사된다 .....
ID3 approach : Yoh-Han Pao : 패턴인식과 분류에 대한 ID3 접근은 비수치 속성이나 변수값 (nonnumeric attributes or feature values) 을 가지는 패턴들을 분류하기 위한 효율적인 식별 트리 (discrimination tree) 를 생성하기 위한 과정이다. 식별 트리는 규칙들을 모아놓은 (a body of rules) 형태로서 표현될 수 있기 때문에, ID3 는 기계학습이나 규칙획득을 위한 귀납추론으로 생각되기도 한다 ....
일반적인 경우,  (N) 개의 문자로 표현된 패턴들이 클래스
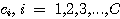 (c_i, i = 1, 2, 3, ..., C) 에 속하는 패턴 집합으로 분할됩니다. 클래스
 (c_i) 에서의 모집단은
 (N_i) 입니다. 각 패턴은
 (K) 개의 변수를 가지며, 각 변수는
 (J_k) 개의 값들을 가집니다. (여기서는 단순화시켜서, 모든 변수들이
 (J) 개의 값들을 가지는 것으로 합니다). 효율적인 decision tree 를 생성하기 위한 ID3 방법은 다음과 같은 단계를 거칩니다.
📋 ID3 알고리즘의 4대 고전 실행 절차 (Yoh-Han Pao 요약) :
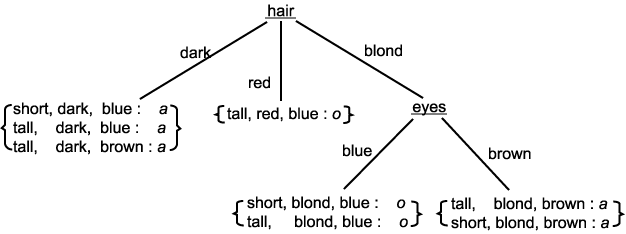
1986년 로스 퀸란(J. Ross Quinlan) 교수가 제안한 ID3(Iterative Dichotomiser 3)는 '반복적 이분기'라는 이름 그대로, 복잡한 데이터 집합을 엔트로피(Entropy) 기준에 따라 반복적으로 쪼개어 가장 순수한(Pure) 하위 노드들로 분할해 나가는 하향식(Top-Down) 탐욕적(Greedy) 알고리즘입니다.
엔트로피(Entropy)는 물리학의 열역학 개념을 클로드 섀넌(Claude Shannon)이 정보이론으로 가져온 것으로, 데이터 집합 내에 존재하는 불확실성(Uncertainty) 또는 무질서도(Impurity)의 크기를 수치화합니다.
모든 데이터가 단 하나의 클래스(예: 전부 Yes이거나 전부 No)에만 속해 있어 불확실성이 전혀 없는 가장 이상적인 상태입니다. 트리의 잎 노드(Leaf Node)가 됩니다.
이진 분류에서 Yes와 No의 비율이 정확히 50:50인 상태입니다. 동전을 던지는 것과 같아 어떤 예측도 할 수 없는 최대 불확실성 상태입니다.
어떤 속성(Attribute, A)으로 데이터를 분할했을 때, 분할 전의 엔트로피에서 분할 후 하위 부분집합들의 가중 평균 엔트로피를 뺀 값을 정보 이득(Information Gain)이라고 합니다. 즉, "이 질문을 던짐으로써 불확실성이 얼마나 감소했는가?"를 뜻합니다.
기계학습 교과서(Tom Mitchell의 Machine Learning 등)에서 가장 널리 인용되는 로스 퀸란의 전설적인 '테니스 플레이(Play Tennis)' 데이터셋을 통해 ID3의 작동 절차를 분해해 봅니다.
14일의 날씨 데이터 중 테니스를 친 날(Yes: 9일), 안 친 날(No: 5일)의 초기 불확실성을 계산합니다 :
H(S) = - (9/14) log_2(9/14) - (5/14) log_2(5/14) = 0.940
날씨 속성들(날씨전망: Outlook, 온도: Temperature, 습도: Humidity, 바람: Wind)로 데이터를 쪼갰을 때의 정보 이득을 각각 계산합니다 :
• IG(S, Outlook) = 0.246 | • IG(S, Humidity) = 0.151 | • IG(S, Wind) = 0.048 | • IG(S, Temperature) = 0.029
정보 이득이 0.246으로 가장 높은 'Outlook(날씨전망)'을 최상위 루트 노드로 결정하고, 그 하위 값들인 [맑음(Sunny), 흐림(Overcast), 비(Rain)]의 3갈래 가지를 생성합니다. 'Overcast'인 날은 모두 Yes(4개)이므로 즉시 순수 잎 노드가 됩니다.
'Sunny' 가지 아래에서는 남은 속성 중 'Humidity'가, 'Rain' 가지 아래에서는 'Wind'가 최고 정보 이득을 보여 차례로 분기되며 완벽한 의사결정 트리가 완성됩니다.
ID3는 인공지능 역사에 큰 획을 그었지만, 현실 세계의 복잡한 데이터셋에 적용하기에는 몇 가지 치명적인 태생적 한계를 안고 있었습니다. 이를 보완하며 현대 머신러닝의 표준 트리들이 탄생했습니다.
'주민등록번호', '고객ID', '날짜'처럼 고유한 값이 매우 많은 속성은 각 값마다 데이터가 1개씩만 배정되어 엔트로피가 0이 되므로, 무조건 최상위 분기 노드로 잘못 선택되는 치명적 편향이 있었습니다.
나이(23.5세), 소득(5,400만원) 같은 연속형 실수를 직접 분할하지 못하고, 오직 범주형(이산형) 기호 속성만 다룰 수 있었습니다.
훈련 데이터에 특정 속성 값이 비어 있으면 엔트로피 계산이 중단되어 학습을 진행할 수 없었습니다.
훈련 데이터의 모든 노이즈와 특이점까지 100% 외워버려 트리가 비정상적으로 거대해지고, 새로운 테스트 데이터에 대한 일반화 성능이 급격히 떨어졌습니다.
| 알고리즘 | 개발자 및 연도 | 분기 기준 (Split Criterion) | 주요 혁신 및 특징 |
|---|---|---|---|
| ID3 | Ross Quinlan (1986년) |
정보 이득 (Information Gain) 엔트로피 기반 |
최초의 체계적 기호 트리 알고리즘, 이산형 속성 전용, 가지치기 없음 |
| C4.5 | Ross Quinlan (1993년) |
정보 이득비 (Gain Ratio) 분할 정보(Split Info)로 정규화 |
다치 속성 편향 해결, 연속형 수치 분할, 결측치 자동 처리, 사후 가지치기(Pessimistic Pruning) 도입 |
| CART | Breiman et al. (1984년) |
지니 불순도 (Gini Impurity) 또는 분산 감소량 |
언제나 이진 트리(Binary Tree)로만 분할, 분류(Classification)와 회귀(Regression)를 모두 지원 |
ID3는 단순한 통계적 분류기를 넘어, 인공지능이 "인간이 손수 코딩한 지식 주입"에서 벗어나 "데이터로부터 스스로 지식 규칙을 캐내는 데이터 주도형 머신러닝"으로 대전환을 이루게 한 기념비적 전환점이었습니다.
1980년대 기호주의 전문가 시스템(Expert Systems)의 최대 약점은 인간 도메인 전문가를 일일이 인터뷰하여 수만 개의 If-Then 규칙을 사람이 손으로 작성해야 한다는 점이었습니다. ID3는 방대한 사례 데이터만 밀어 넣으면 컴퓨터가 스스로 최적의 규칙(Rule Base)을 자동으로 귀납 추출(Rule Induction)할 수 있음을 완벽하게 증명했습니다.
신경망(Neural Network)이나 딥러닝과 달리, ID3가 도출한 의사결정 트리는 루트에서 잎 노드까지의 모든 경로가 "IF 나이 > 30 AND 소득 > 5000 THEN 대출 승인"과 같은 명확한 논리 기호로 1:1 변환됩니다. 이는 의료 진단, 금융 심사, 법률 판결 등 투명성과 감사 가능성(Auditability)이 절대적인 고위험 의사결정 산업의 표준이 되었습니다.
ID3를 출발점으로 진화한 단일 결정 트리들은 오늘날 수백 개의 트리를 결합하는 랜덤 포레스트(Random Forest)와 잔차를 점진적으로 줄여나가는 그래디언트 부스팅(GBDT : XGBoost, LightGBM, CatBoost)으로 만개했습니다. 이들은 현재도 정형 테이블 데이터(Tabular Data) 분야에서 딥러닝을 압도하는 세계 최강의 머신러닝 알고리즘으로 군림하고 있습니다.
기업의 CRM 데이터, 신용카드 부정 사용 탐지, 고객 이탈 예측 등 대규모 상업 데이터베이스에서 숨겨진 고객 패턴을 발굴해내는 데이터 마이닝 산업의 폭발적 성장을 견인한 엔진이 바로 ID3 트리 기반 분류 기술이었습니다.
Josh Starmer 박사의 StatQuest 명강의 — 엔트로피(Entropy)와 정보 이득(Information Gain)을 이용해 결정 트리를 밑바닥부터 구축하는 원리
ID3 알고리즘과 유기적으로 연결되는 aistudy 핵심 지식 문서들을 탐색할 수 있습니다.