Digital Processing of Speech Signals
(음성신호의 디지탈 처리)
음성언어의 이해 : Peter Denes. Elliot Pinson 저서, 고도흥.구희산.김기호.양병곤 공역, 한신문화사, 1995 (원서 : The Speech Chain : W. H. Freeman and Company, 1993)
언어조직에서 기술되었던 언어의 조직과 같은 주제의 어떤 면들은 상징적인 것으로 여길 수 있다. 이러한 면들을 이해하기 위해서는 그 처리 과정이 어떻게 일어나는 지를 기술하는 개념적인 모델을 설정할 필요가 있다. 예를 들면, 영어의 음소같은 소수의 요소들이 언어 안에서 나타나는 모든 소리를 부호화한다고 가정할 수 있다. 더 나아가서 이 가정은 이러한 요소들이 다양하게 결합되어 나타나며 구어 소통에서 쓰이는 단어와 구, 그리고 문장을 이룬다는 것을 예측하게 된다.
우리가 다루는 주제의 다른 측면, 즉 소리의 물리학에서 기술된 바 있는 공기중의 압력 변화 같은 것은 본질적으로 순수하게 물리적인 것이다. 그것들은, 예를 들면 음파를 그에 해당하는 전기적 부호로 바꾸는 마이크나 궁극적으로 음향적 압력 변화를 바꾸어 소리를 인지하게 되는 청각 장치 등 감지 장치를 통해 감지할 수 있는 물리적인 세계에 실제로 존재하는 것이다.
음성 연쇄의 갖가지 연계성을 연구하기 위해서는 많은 특별한 기구들이 필요하다. 그것들은 언어학과 음향학, 발성, 청취, 신경체제와 뇌의 양상들을 관찰하고 수량화시키는 수단을 제공한다. 궁극적으로는 관찰한 내용을 가설화한 모형에 의해 예측된 기능과 비교할 수 있다. 이러한 요소들은 ━ 즉, 가설, 관찰, 비교 ━ 과학적 방법의 핵심이며, 물리적 세계를 이해하는데 잘 알려진 가장 강력한 접근방법이다.
이러한 상징적이며 물리적 구조를 모두 1950 년대에 처음 대두한 기술, 즉 전자 디지탈 컴퓨터를 이용하여 가장 효과적으로 연구할 수 있다는 점은 현대 과학의 흥미롭고 중요한 양상이다. 복잡한 사상을 단 몇마디 말로 요약하는 것을 좋아하는 시대에서는 20 세기 중반과 현재 사이의 시기를 "핵의 시대", "정보 시대", 또는 "전자공학의 시대" 등 갖가지로 부른다. 이 모든 용어들이 어느 정도 진실성을 지니고 있긴 하겠지만 음성과 음향학의 관점에서 본 가장 적절한 표제는 "디지탈의 시대" 이다.
1960 년대 이후의 컴퓨터와 마이크로 전자공학에서 이루어진 주목할 만한 발전은 음성부호와 그것들이 나타내는 상징들을 저장, 처리, 검토하는 방식을 변형시켜 왔고 실용적인 의미에서 우리가 실제로 할 수 있는 일을 변혁시켜 왔다. 30 년전만 해도 물리적으로 불가능했거나 혹은 너무 비용이 너무 많이 들어 성취할 수 없었던 장치들이 지금은 일상적인 것으로 여겨지거나 종종 비싸지 않은 소비재 전자 제품으로 이용되고 있다. 이러한 많은 업적들은 디지탈 전자공학이 널리 보급되었고 그 비용도 적게 드는 유용성 때문이다.
이 장에서는 몇가지 디지탈 신호 처리과정의 몇 가지 기본적인 개념, 특히 음성파형의 예에서 알 수 있듯이 디지탈 컴퓨터가 음향신호들을 어떻게 나타내고 처리하여 왔는가를 설명할 것이다. 또한 디지탈 전자공학이 우리의 주제에 있어 중요한, 보다 향상된 전자공학적 장비를 만드는 방법뿐만 아니라 우리의 음성과 청취를 연구하는 방법에도 미쳤던 크나큰 영향에 대해 논의하기로 한다. 기호의 처리에 관한 주제나 신경망, 인공지능 등과 같은 디지탈 공학의 또 다른 분야에 대해서는 이 장에서는 토의하지 않기로 한다. 왜냐하면, 그것들은 우리의 주제와 관련이 있기는 하지만, 이 책의 범위를 벗어나 있기 때문이다.
오늘날 디지탈 컴퓨터, 디지탈 컴팩트 디스크와 그리고 디지탈 오디오 테이프 등이 있다. 장거리 전화 회로는 목소리와 데이터 신호의 전환과 전송에서 이미 거의 완전하게 디지탈화되었고 지역내 전화 회로도 머지 않아 그렇게 될 것이다. 디지탈 전화는 상업적으로 이미 이용되고 있다. 미국 전화 체제를 위한 ISDN (통합 서비스 디지탈 망) 계획은 2000 년대까지는 거의 완전하게 디지탈화될 것으로 예상하고 있다. 왜 "디지탈" 이라는 용어가 도처에서 발견되며 왜 그렇게도 널리 적용될 정도로 유용한가? 이 장의 나머지 부분에서는 말소리와 오디오 신호라는 맥락에서 디지탈이 무엇을 의미하는지를 설명할 것이다. 그러면 왜 디지탈 공학이 거의 모든 말소리의 전송과 처리에 최상의 기술인가는 자명해질 것이다.
디지탈이 무엇인지 기술하는 것은 어렵지 않다. 디지탈이란 단순하게는 사물을 수로써 나타내는 것을 의미한다. "사물" 이란 공기를 통해 전송된 소리의 압력 신호, 이 문장에서의 글자 또는 텔레비젼 스크린이나 사진에서 볼 수 있는 화상, 혹은 국제전화 통화를 전기적 신호 등 모든 것이 될 수 있다. 디지탈식 표현의 중요성은 디지탈식 조작이 수행할 수 있는 정확도, 신빙성, 속도, 저렴한 비용과 소규모의 전기 체계에 있다. 계속적으로 변화하는 소리의 부호를 디지탈 형식으로 변환하는 것과 디지탈 영역에서 우리가 바라는 처리 과정을 행하는 데는 지난 30 년간 컴퓨터 공학에서 이루어진 모든 발전을 이용할 수 있게 한다. 음성 장치에 필요한 모든 부호조작이 전자 회로보다는 디지탈로 처리되도록 하는 수학적 방법이 개발되고 있다. 여기에는 증폭, 여과, 스펙트럼 분석, 합성음의 생성과 자동 음성인식 등이 포함된다.
디지탈 과정에서 발전은 최근 10 여년간 아주 주목할만 하였다. 1960 년대에 구입할 수 있었던 가장 강력한 과학적 컴퓨터는 IBM-704 였다. 그것은 처리 기능을 위해 진공관을 사용했으며 주 기억을 위해 간단한 자성체 ━ 그 당시 컴퓨터 메모리의 발달된 형태였다 ━ 를 사용하였는데 그것은 131,000 자를 저장할 수 있었다. 그 컴퓨터는 1 초에 약 42,000 개의 간단한 산술기능 (즉, 가 산) 을 수행할 수 있었다. 완전한 컴퓨터 하나에 2 백만 달러 (1990 년대 달러로 870 만 달러) 이상의 비용이 들었으며 거대하고 완전하게 냉방장치가 갖추어진 방을 차지했다.
1990 년대의 고도의 성능 (그러나 저렴한 비용으로) 을 갖춘 데스크 탑 워크스테이션은 4,000 에서 5,000 달러의 비용이 들며, 초당 4 천만개의 연산을 하는 고속의 실리콘으로 된 VLSI (최대 규모 집적회로) 의 1 천 6 백만 자를 포함하고 있다. 이러한 수치의 직접적인 비교는 속도에 있어서의 1,000 배의 증가를 보여주며 같은 가치의 달러 비용에 있어서는 2,000 배의 감소를 보여준다. 단일 처리 기능의 비용 면에 있어서는 2 백만 배나 감소한 것이다.
그러나, 어떤 장치에 있어서 계산 속도와 기억용량은 컴퓨터 문제 해결의 더 나은 기준이 된다. 위의 수치의 비교는 이미 언급한 가격에 대한 메모리 용량에 있어서의 125 배의 증가를 보여준다. 속도 대 기억산출량에 의하면 단위 비용당 성능은 2 억 5 천만 배나 향상된 것이었다. 더 놀라운 것은 속도의 향상 (격년마다 3 과 4 사이의 배수로) 은 오늘날도 계속되고 있고 적어도 앞으로 10 년간, 아니 어쩌면 영원히 계속될 것으로 예상된다. 만약 집이나 자동차 값이 이와 비슷한 방식으로 하락했다면 아주 편안한 집은 오늘날 500 달러의 비용만 들 것이며, 캐딜락도 80 달러만 더 있으면 차고에 넣을 수 있을 것이다. (그것은 갤런당 7,500 마일을 달리며 한 시간당 60,000 마일을 달릴 수 있다.)
아마도 음성과 오디오 신호처리에서 더 중요한 것은 특별한 목적의 VLSI 장치는 위에서 기술한 일반 목적의 컴퓨터보다 더 낮은 비용이면서도 더 고도의 성능을 갖추고 있는 것을 구할 수 있다는 사실이다. DSP (디지탈 신호처리) 라 불리는데, 이는 각기 일초에 천만 가지 연산을 할 수 있다. 소위 "병렬구조" 라 불리는 방식으로 수백 수천개의 이러한 장치들을 함께 사용하여 훨씬 더 고속의 처리 속도가 가능할 수도 있다. 이런 식으로, 일초에 수십억개의 연산기능을 수행할 수 있는 시스템을 만들 수 있다. 더 복잡한 음성 관련 작업 ━ 예를 들면 자동 음성인식이나 언어통역 ━ 을 성취하기 위한 수학적 기술은 거대한 양의 수학적 계산이 필요하다. 최신의 하드웨어의 생산으로 이러한 작업 (적어도 제한된 경우지만) 은 실시간에 (다시 말하면 음성이 발화되는 속도와 같은 속도) 실질적인 비용으로도 성취가능한 것이다.
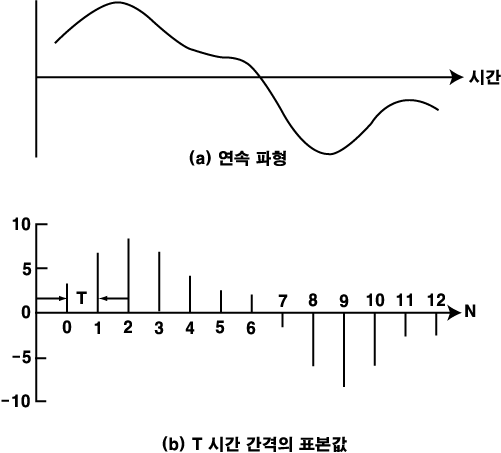
소리의 물리학에서 이미 보았듯이, 음압의 파형은 연속적으로 변하는 신호이며 보통 아날로그 신호라 부른다. 그것은 매 순간 변하며, 그림 1(a) 의 그림에서 보이듯이 이 신호가 두 개의 값 사이에서 변할 때는 그 사이의 모든 값을 다 거치게 된다. 그런 부호는 ADC (Analog to Digital Converter) 즉, 아날로그 - 디지탈 변환기에 의해 디지탈의 형태로 변환하게 된다. 이 신호는 일련의 같은 시간 간격으로 표본추출된다. 표본값은 표본추출 순간의 신호의 진폭에 상응하는 수치이다. 표본 과정은 그림 1(b) 에서 보여지며, 표본값은 그림 1(c) 에 나타나 있다.
그림 1(c) 에서 보이는 값들은 일반적인 10 진수로 제시되었는데, 숫자상의 각기 10 진수의 위치는 0 에서 9 까지의 열 개의 십진수 중의 하나가 될 수 있다. 실질적으로, 디지탈 컴퓨터는 내적으로는 2 진수 체계로 숫자를 나타내며, 각기 2 진수의 위치는 2 개의 2 진수, 0 또는 1 중의 하나가 될 수 있다. 수학의 세부사항은 여기에선 관심 밖이지만, 몇 가지 공통된 용어는 이해할 필요가 있다. 각각의 2 진수는 비트라고 불리며, 여덟개의 비트의 집합은 바이트라 불린다. 바이트는 컴퓨터 내부에서 숫자와 알파벳 기호를 나타내기 위해 종종 사용되므로 독자적 이름을 가질 만하다. 8 비트는 28 = 256 개의 다른 기호를 나타낼 수 있으므로, 바이트는 모든 가능한 숫자와 대, 소문자, 특수 문자의 집합 등을 나타내는데 편리한 크기이다.
|
NO |
진 폭 |
NO |
진 폭 |
|
0 |
3.38 |
7 |
-1.32 |
(c) 소숫점 이하 두자리까지 표기한 N 번째 표본의 진폭
그림 1 한 연속파형의 균일한 표본추출
ADC 처리에서의 놀라운 사실은 그것이 만약 적절히 처리되기만 한다면 (다음 절에서 기술하듯이), 원 신호의 모든 세부 사항이 포착될 수도 있다. 원래의 연속 파형은 정확하게 재구성될 수 있고, 보다 더 중요하게는 강력한 디지탈 신호처리가 그 신호의 디지탈 표시에 적용될 수 있다. 예를 들면, 신호를 두배로 증폭하는 일은 단지 각각의 표본값을 2 배로 곱하기만 하면 된다. 신호의 저주파 성분을 강조 (오디오 용어로 베이스 강조라 한다) 하거나 하는 등의 더 복잡한 변형은 "디지탈 여과기" 라 부르는 수학적 변형에 의해 얻어질 수 있다. 증폭이나 여과같은 처리가 끝난 후의 연속 신호는 어떤 손상도 없이 재구성될 수 있다. 디지탈 형태로부터 다시 연속신호로 환원하는 처리는 DAC, 즉 디지탈 - 아날로그 변환이라 불린다.
이제 우리는 정확한 신호전송에 매우 중요한 디지탈 표시의 한가지 측면을 이해하려는 자리에 있다. 어떤 신호가 통신 매체를 통해 전송이 될 때에 어느 정도는 불가피하게 변형될 수밖에 없다. 그러므로 수신된 신호는 어느 정도는 원래 전송된 신호와는 다르다. 아날로그 신호에서는 심지어는 아주 작은 양의 변형일지라도 제거할 수 없는 소음을 낳게 된다. 흔한 예로는 레코드판으로부터 거꾸로 재생시킨 소리에서 들리는 쉬-익 하는 소리와 뇌우가 근처를 지날 때에 일어나는 라디오의 공전현상, 그리고 낡은 아날로그식 장거리전화회로에서 종종 경험하는 낮은 음질 등이 이에 포함된다.
디지탈 신호에 있어서도 똑같은 신호의 변형 요인이 존재한다. 그러나 어느 순간의 신호라도 아날로그 신호단계가 아닌 숫자로 표시되기 때문에 전송된 숫자를 명확하게 아날로그 신호단계가 아닌 숫자로 표시되기 때문에 전송된 숫자를 명확하게 인식하기만 하면 되는 것이다. 이러한 작업은 디지탈 신호가 이원적이라는 것 즉, 매순간 가능한 두 가지 값, 예를 들면, 0 이나 1 중 한가지를 표시한다는 점 때문에 실질적으로 간편해진다. 소음이 너무 작아 이 두 가지 값들 사이의 선택이 혼동되지만 않는다면 수신된 신호는 전송된 신호와 똑같은 수치를 나타낼 것이다. 사실, 부가적인 부호화기술이 만약 다른 방법으로 했더라면 발행했을 오류를 탐지하고 수정하는 데 사용된다. 그것들은 컴팩트 오디오 디스크나 현대적 디지탈식 장거리 전화로부터의 소리일지라도 디지탈 방식으로 전송된 신호는 비할 데 없을 정도의 음질과 변형되지 않는 신호를 보여준다.
디지탈 세계에서는 완전한 연속 신호를 등간격의 시간을 두고 추출한 제한된 수의 표본에 의해 재구성하는 것이기 때문에 아날로그 신호의 정확한 재구성이 명백하게 가능한 것은 아니다. 어떻게 하면 표본추출 시간 사이에 있는 신호에 대해 완전한 정보를 실제로 얻을 수 있을까? 그 해답은 표본추출의 정리라는 놀라운 수학적 결과에 있으며 그 내용은 다음과 같다 : 제한된 주파수대의 신호를 그 신호에서 가장 높은 주파수의 적어도 2 배의 높이의 비율로 추출한다면, 어떤 정보도 소실되지 않으며, 원래 신호도 표본으로부터 정확하게 재구성될 수 있다.
마지막 문장의 "제한된 주파수대" 란 용어는 중요하다. 이미 소리의 물리학에서 어떠한 신호도 사인곡선의 성분음의 총계로써 나타낼 수 있다는 푸리에의 결과에 대해 배웠다. 일반적으로 그것은 작업을 매우 정확하게 이루기 위해 많은 성분음들을 취하며, 그 성분음들은 그 신호의 주파수대역폭 (bandwidth) 이라 불리우는 넓은 주파수대에 걸쳐 있다. 청각에서 보았듯이 인간이 들을 수 있는 음향신호의 주파수는 약 20 에서 20,000 Hz (20 킬로헤르쯔를 약자로 보통 20 kHz 라 한다) 에 놓여 있다. 이 범위 밖의 주파수를 포함하고 있는 신호는 여과되어 이 가청 즉, 가청대역 (audio-band) 밖의 구성소는 제거된다. 단지 들을 수 없는 구성소만이 제거되었기 때문에 두가지 신호는 똑같은 소리로 인식된다. 그러나 여과된 신호는 제한된 주파수대이다. - 즉, 이는 특정 주파수대역폭의 주파수만을, 이 경우에는 가청대역을 포함하게 된다. 신호에 포함된 최대의 주파수는 나이퀴스트주파수라 불린다. 표본 추출정리에 대해 직관적으로 설명하면, 고주파 구성소를 제거하므로써 그 신호가 매우 빨리 변환하는 정도를 제한한다는 것이다. 나이퀴스트 주파수대로 혹은 그 두 배 이상으로 표본추출을 하면 표본들이 충분히 밀집해 있어 신호에 대한 모든 정보를, 심지어는 표본 사이의 정확한 형태까지 확실하게 포착할 수 있게 된다.
아날로그와 디지탈 형태 사이의 완전한 변환이 가능한 이유는 제한 주파수대 아날로그 신호의 스펙트럼과 그것에서 표본추출하여 얻어진 디지탈 신호의 스펙트럼을 비교하면 가장 쉽게 이해할 수 있다. 그림 2(a) 의 그림은 주파수 Fn 으로 주파수가 제한된 아날로그 신호의 스펙트럼을 보여주고 있다. 예측하듯이 스펙트럼은 한 범위의 주파수를 포함하고 있지만, 모두 Fn 보다 아래에 있다. 그림 2(b) 는 Fn 보다 두 배 이상 높은 Fs 에서 원래 신호를 표본 추출함으로써 얻어진 디지탈 신호의 스펙트럼을 보여준다. 우리는 표본추출이 Fs 의 가능한 모든 정배수 (즉, Fs, 2Fs, 3Fs, 등) 에 의해 대치된 주파수 0 점축과 함께 아날로그 신호 스펙트럼의 정확한 복제인 부가적 주파수 구성소를 도입한다는 점을 알게 되었다. 그림 2(a), 2(b) 를 비교해보면, Fs/2 이하의 스펙트럼은 변하지 않았지만, 표본추출과정은 Fs/2 이상의 주파수에서 부가적 성분임을 도입했다는 것을 알 수 있다.
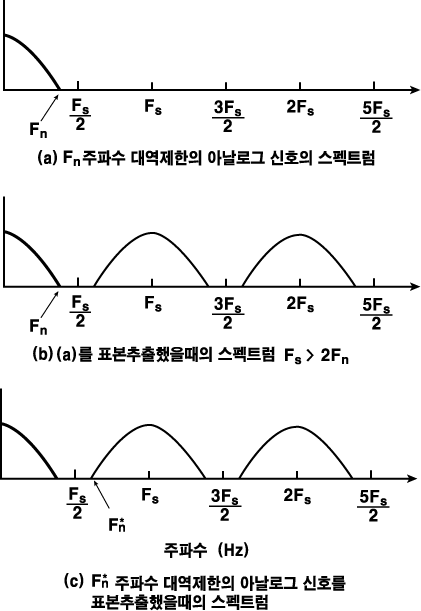
그림 2 대역이 제한된 연속 신호음
; (a) 의 스펙트럼과 이를
(b), (c) 와 같이 표본추출했을 때 나타나는 스펙트럼의
관계
이 표본추출된 신호가 나타내는 소리를 듣기 위해서 이것은 DAC 과정에 의해 다시 아날로그 신호로 변환되어야 한다. 주파수 영역에서, 완전한 DAC 는 저주파여과라 불리우는 과정에 의해 Fs/2 이상의 모든 주파수를 제거하기만 하면 된다. 남은 것은 바로 원래의 스펙트럼, 즉, 원래의 아날로그 신호이다. 이런 식으로 주파수 영역에서 관찰하면, '표본추출 정리' 의 제약사항이 명확히 드러난다. 표본추출 과정에서 발생한 어떤 주파수의 성분음도 제한 주파수대 신호의 원래 스펙트럼에 확실히 미달하지 않도록 주파수를 표본추출하려면 적어도 나이퀴스트 주파수의 두 배가 되어야 한다. 그림 2(c) 는 나이퀴스트 주파수가 ━ 이 경우 Fn* ━ Fs/2 보다 높을 경우, 어떤 일이 발생하는지를 보여 주고 있다. 표본추출시 발생한 구성소가 Fn* 이하의 아날로그 신호주파수 범위로 확대되는 점, 변명으로 불리는 효과를 주목하라. 도출 신호가 아날로그 형태로 전환될 때, 이러한 변명된 성분음에 의해 심각하게 변형될 수도 있다.
디지탈 고성능 오디오 전자제품은 인간의 가청 최고 주파수의 2 배인 40 kHz 보다 더 큰 비율로 표본 추출됨으로써 전형적으로 변명의 문제를 피하고자 했다. 가령, 디지탈 컴팩트 디스크는 44.1 kHz 의 표본추출 비율을 사용하며 디지탈 오디오 테이프 녹음기는 보통 48 kHz 의 비율로 표본추출한다. 이런 주파수는 20 kHz 이하의 가청 주파수 범위에 한정된 신호의 완전한 재생성을 할 수 있도록 선택된다.
한편, 인간의 음성은 약 7 kHz 이상의 주파수 구성소는 거의 갖고 있지 않다. 그러므로 고품질의 음성을 위한 디지탈 체계는 보통 16 kHz 표본추출을 이용한다. 전화회로는 겨우 3.2 kHz 의 주파수대역폭을 사용하므로 전화 통화는 그 성능이 꽤 낮을 수 밖에 없음을 설명해 준다. 전화체계에서의 그 주파수대역폭을 뒷받침하기 위해 디지탈 공학이 이용된 후에, 약 8 kHz 표본추출비율이 사용되고 있다. 양자의 경우에서, 표본추출비율은 관련된 음성신호에서 최고 주파수의 두 배보다 약간 높게 선택되었음을 알 수 있다.
표본추출 정리가 정확하게 적용되기 위해서는, 각각 표본으로 추출된 진폭 값이 추출되는 순간의 원래 신호의 진폭값과 정확히 같아야 한다. 원래 ADC 는 이런 경지의 완벽은 기하지 않는다. 보통, 고정된 수의 비트 (2 진수) 가 표본값을 나타내기 위해 사용된다. 그러므로, 아날로그에서 있을 수 있는 무한한 값은 표본에 이용되지 않는다. 사실상, 각각의 표본에 R 개의 비트가 있다면 정확히 2R 의 표본값이 가능하다. 실제로는 전화와 같은 좁은 대역을 이용하는 기구에 있어서는 표본당 8 개의 비트 (256 levels) 가 적절하다. 컴팩트 디스크나 디지탈 오디오 테이프 같은 고성능 기구에는 표본당 16 개의 비트 (65,536 값) 가 사용된다. 음성 부호화와 음성 압축분야는 낮은 표본 추출율과 표본당 더 적은 비트를 가지고도 고품질의 음과 음악을 이루는 세련된 전산 기술을 개발하고 있다. 이러한 분야에서의 성공에 대한 보상으로는 높은 품질의 음과 음악을 보통 전화선으로도 전송할 수 있는 능력, 현재 가능한 약 75 분 대신에 CD 에 고성능 스테레오 음악을 몇시간이고 수록할 수 있는 능력 등을 들 수 있다.
그림 3(a) 는 점선으로 된 아날로그 신호가 어떻게 표본추출된 순간의 8 개의 허용가능한 디지탈 표시 단계 중의 한가지로 변환되는가를 보여준다. 그 예는 균일한 간격으로 나눈 표본 체계를 규정하기 위해 세 개의 비트를 사용하고 있는 하나의 체계와 일치한다. 표본값은 각 추출 시간마다 있는 수직의 짙은 선에 의해 보여지고 있다. 그 양자화는 추출순간의 표본에 가장 근사한 표시 단계를 이용한다. 분명히, 표본값을 나타내기 위해 이용할 수 있는 단계가 많을수록, 아날로그 신호에의 근사값은 더욱 더 정확해질 것이다.
아날로그 신호와 표본값 사이의 차이는 양자화 오차라고 알려져 있다. 이것은 달리 했더라면 완벽했을 표본값에 덧붙여진 소음으로 간주되기 때문에, 양자소음이라고 종종 불리며 그림 3(b) 에 보여지고 있다. 실제 표본 추출된 신호가 원래의 아날로그 신호를 나타낼 수 있는 정확도를 양자소음이 제한하는 효과를 지닌다. 이런 ADC 과정의 고유한 한계는 종종 신호가 소음으로 바뀌는 비율 (SNR) 로 표현된다. (SNR 이란 양자소음의 평균압력에 대한 아날로그 신호의 평균압력 비율) 소리의 물리학에서 dB 척도의 견지에서 보면, 균일하게 간격이 나뉜 표본단계에서의 양자 SNR 은 표본에 사용된 각 비트에 대해 6 dB 정도 증가한다. 표본당 R 비트를 사용하는 ADC 와 균등간격의 양자화 단계에서는 대략 SNR = 6R - 5 이다. 그러므로 8 비트 표본에 대해서는 SNR 이 약 43 dB 가량 얻어질 수 있는 반면, CD 나 디지탈 오디오 테이프 재생기에 사용된 16 비트 부호화는 약 91 dB 이 가능하다. 후자의 경우에 있어서는 특별한 소음 제거기술을 사용하여 아날로그 오디오 카세트 재생기에서 얻어질 수 있는 60~70 dB 보다 20~30 dB 가량 더 나은 것이다.
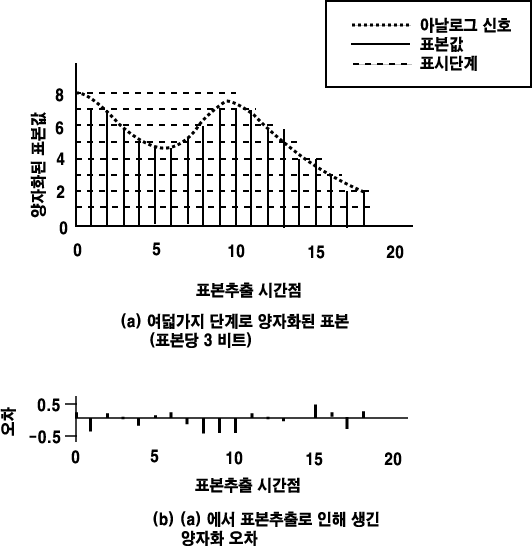
그림 3 제한된 단계로 표본추출할 때 생기는 양자화 오차
일단 신호가 디지탈 형태로 되면, 강력한 디지탈 신호 처리기술을 수치로 된 표본값에 적용하여 신호를 수정하거나, 여러가지 형태의 유용한 정보를 추출해 낼 수 있다. 음성과 다른 오디오 신호에 자주 적용이 되는 두 가지 기술, 디지탈 여과기와 디지탈 스펙트럼 분석만을 토의하고자 한다.
소리의 물리학에서 보았듯이, 모든 신호는 적절한 일련의 사인곡선의 성분음이 합해져 있다. 신호의 스펙트럼은 신호에 포함이 된 유일한 사인곡선과의 집합이다. 신호 파형을 정확히 복제하기 위해 사인곡선으로 된 성분음의 진폭 (강도) 와 위상 (상대적 시작시간) 양자가 정확하게 선택되어야 한다. 다행히도 음성과 대개의 음향과정에 대해서는 음향적 신호가 소리로서 인식되는 방법에는 위상은 보통 거의 중요하지 않다. 그러므로 우리가 스펙트럼에 대해 말할 때에는 단지 진폭 스페트럼을 의미하며 위상은 완전히 무시할 것이다.
여과기는 신호의 주파수 성분음의 상대적인 압력을 변화시키기 위해 사용된다. 우리에게 잘 알려진 하나의 단순한 기구로는 라디오와 레코드 플레이어의 고음부 (treble) 와 저음부 (bass) 조정을 들 수 있다. 고음부 조정은 고주파 성분음의 압력을 증가시키거나 약화시키는 데에 반해, 저음부 조정은 저주파에 대해 마찬가지로 하는 것이다. 좀 더 값비싼 시스템은 12 개의 주파수대를 독립적으로 조정할 수 있는 도표식 평형장치 (graphic equalizer) 를 갖추기도 한다. 전자 음성 합성은 말소리를 흉내내기 위해 특정 주파수대의 주파수를 강조하고 조정할 수 있는 여과기를 사용한다. 이 모든 일과 수많은 다른 여과 작업이 디지탈의 영역에서 행해질 수 있다.
그림 4(a) 는 몇 개의 주파수 성분음을 갖는 신호의 스펙트럼을 보여주고 있다. 간편하게 하기 위해 모든 성분음들이 똑같은 진폭을 갖는 것으로 나타나 있다. 그림 4(b) 는 저주파여과기의 특성을 보여준다. 그림 4(a) 의 신호가 이 여과기의 입력으로 사용된다면 여과기 산출 신호는 여전히 입력주파수대에서의 성분음을 갖게 될 것이다. 그림 4(c) 에 나타난 산출 스펙트럼 진폭값은 상응하는 주파수에서의 여과값에 각각의 입력 성분음 진폭을 곱함으로써 얻어진다.
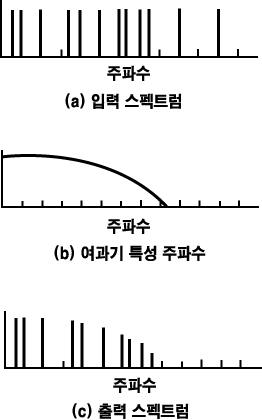
그림 4 여과기가 신호의 스펙트럼에 미치는 영향
디지탈 시대 이전에는 여과기는 저항기, 축전기, 유도회로, 증폭기로 구성이 된 전기회로였다. 전기 여과기 고안이라는 분야는 고도로 발달된 수리 과학이다. 지난 25 년 이상, 디지탈 여과기 고안도 마찬가지로 정교한 과학이었다. 이전에 전기적 부품으로 만들었던 모든 여과기들은 단순히 디지탈 필터를 이용한 수적인 계산에 의해 구현할 수도 있다. 더 중요한 것은, 수로 나타내는 이러한 여과기는 아날로그식 보다는 더 정확하고, 소음을 덜 일으키며, 종종 훨씬 더 저렴하다는 점이다. 최근에야 비로소 저렴한 VLSI 구성소가 CD 플레이어 (compact disk player) 나 전치 증폭기 같은 비싸지 않은 소비재에 대해서도 디지탈 여과기가 최상의 방법이 되는 실행단계에 이르게 되었다.
비교적 간단한 기구와 관련이 있는 계산의 양에 대한 예로서, 디지탈 변수 이퀄라이저 (오디오장비에서 음조 조정에 사용되는 디지탈 여과기 유형에 대한 가상 용어) 의 필요성을 생각해 보자. 이퀄라이저는 스테레오 CD 로부터 읽어 들인 두가지 오디오 채널을 동시에 처리해야만 한다. 이것은 1 초당 88,200(2*44,100) 산출표번의 계산을 요구한다. 각각의 산출 표본값을 계산하는 데에는 50 가지 산술적 연산 (곱셈이나 덧셈) 즉, 초당 약 4 천 4 백만 가지의 연산을 할 수도 있다. 현대의 반도체장치는 매우 빠른 속도로 그리고 매우 낮은 비용으로 산술을 수행할 수 있다.
스펙트럼 분석은 소리 파형의 물리적 특질을 조사하고 그것들이 청자에게 인식된 특질과는 어떻게 관련을 맺고 있는지를 이해하기 위하여 음향학 연구가에 의해 사용된 주된 방법이었다. 1930 년대 이후로 음성 연구가들은 스펙트럼 분석에 상당히 많이 의존했다. 최초의 음성 스펙트로그래프는 - - 소리의 물리학과 음성의 음향적 특징에서 이미 언급했던 - - 말소리의 스펙트럼을 분석하고 나온 정보의 결과를 유용한 방법으로 제시하기 위한 초기의 도구였다. 이것은 갖가지 더욱 현대적 형태로 여전히 오늘날까지도 음성분석을 위한 주요한 도구로 남아있다.
최초의 장치에서는 약 2 초 길이의 짧은 소리가 대역여과기 안으로 반복해서 재생되었다. 여과기의 중심 주파수는 매 반복시마다 조금씩 증가한다. 매 반복시 (약 15 msec 의) 짧은 시간을 두고 평균을 낸 여과기의 산출값은 그 시점의 여과기의 중심 주파수 가까이의 입력 신호의 에너지의 값이다. 이 평균 산출값은 감열지를 통과하는 전류를 조절하기 위해 사용된다. 전류가 셀수록, 종이의 검은 부분이 더 진하게 된다. 20 에서 7,000 Hz 사이에서 분석할 가청 주파수대를 가로지르기 위해서는 약 500 회 정도의 반복이 필요하다. 이 과정의 속도를 높이기 위해서는 미리 녹음이 된 입력 음성이 정상보다 4 배 정도 빨리 재생이 되었다. 하나의 완전한 스펙트로그램을 만들기 위해서는 약 5 분이 걸렸다.
그림 5 에서 보이듯이 소리가 지속되는 동안의 다양한 주파수대에서의 에너지의 확실한 상을 만들어 내기 위해 창의적인 전기 - 기계학적 방법이 사용되기도 했다. 그림 5(a) 는 원래의 음성 파형을 보여주는 반면, 그림 5(b) 는 상응하는 음성 스펙트로그램 (이하에서 기술되듯이, 현대적 디지탈 스팩트로그래프에 의해 생성된) 을 보여 주고 있다. 시간은 수평축으로 진행한다. 수직의 축은 (그림 5(a)) 에서는 음성신호의 압력변화의 진폭을, (그림 5(b)) 에서는 음성신호의 주파수 내용을 보여준다. 그림 5(b) 의 모든 지점의 상의 검은 부분은 당시의 신호에 있어서의 에너지와 주파수를 나타낸다. (상이 검을수록 에너지가 더 크다)
이 최초의 아날로그 장치는 수십년 간 그다지 변화하지는 않았다. 한층 향상된 버전은 단 하나의 미끄러져 가는 주파수 필터가 아니라 여러 개의 고정된 주파수 필터를 이용하여 TV 와 같은 화면 위에 실제 속도로 음의 스펙트로그램을 보여 줄 수 있게 되었다. "가시언어 (Visible speech)" 라 불리는 이것은 청각장애자로 하여금 말할 수 있도록 가르치는 데 보조도구로써 수년간 사용되어 왔다. 청각장애자는 그들과 교사들이 만들어내는 소리를 들을 수 없기 때문에 "가시언어" 앞에서 입술과 혀와 입모양을, 그리고 교사가 보이는 연관된 조음 동작들을 모방할 수 있었다. 소리의 실제 특질에 대해 즉각적인 피드백 (feedback) 을 제공하고, 청각장애자 화자로 하여금 소리의 음향적 특질을 즉시 모방하도록 시도하게 했다.
디지탈 과정은 이전에 가능했던 것보다 정확도와 속도, 융통성이 훨씬 더 나아진 매우 향상된 음성 스펙트로그래프를 낳게 하였다. 단기적인 진폭신호의 분절들의 스펙트럼을 얻는데 단기 푸리에 변환 (Short Term Fourier Transform) 이라는 수학적 기술이 이용된다. 이것이야말로 음성 스펙트로그래프가 그 아날로그 버전에서 하는 일이다. 단기 푸리에 변형을 산정하기 위해서 다른 모든 것들은 제거하고, 관심이 있는 시간 사이의 표본들을 보존시키는 "윈도우 (창)" 를 신호에 설치한다. 이렇게 하여 남은 표본에 푸리에 변환을 하면, 우리가 원하는 바로 그 정보를 얻을 수 있다. 예를 들면, 만약 10 msec 간격의 창을 초당 10,000 회 표본추출된 신호의 표본에 적용한다면, 우리는 정확히 100 개의 표본을 추출하는 셈이다. 신호 위를 따라 창을 미끄러지듯 통과하게 하고 매 단계마다 5 msec 로 대치하고 단기 푸리에 스펙트럼을 각 단계마다 취함으로써 선택된 단기 기간 동안 스펙트럼 특성을 나타내 주는 일련의 스펙트럼을 얻을 수 있게 된다. 이러한 스펙트럼 정보는 그림 5(b) 에 보이듯이 음성 스펙트럼으로 나타날 수 있다.
디지탈식으로 생성된 스펙트로그램은 원래의 음성 스펙트로그램보다 수많은 이점이 있다. 먼저, 출력표시장치는 보통 TV 나 음극선관이다. 이러한 것들은 거의 최초의 음성 스펙트로그래프의 감열지보다 훨씬 더 뛰어난 감지도를 갖게 되며 스펙느럼의 세부사항을 더 많이 볼 수 있다. 컬러 표시장치는 융통성을 향상시키기 위해 가령, 스펙트로그램의 특정 측면을 강조한다든지 하기 위해 사용된다. 예를 들면 오래된 기술로는 분간할 수 없었을지도 모르는 특정 측면을 강조하기 위해 디지탈 스펙트로그래프는 신호를 선여과할 수 있게 해주는 특별한 융통성을 갖기도 한다. 표시장치에는 각기 다른 음형이 선택될 수도 있다. 고속 디지탈 체제로 음성이 말해지는 동안 지체없이 실시간 스펙트로그램을 획득할 수 있도록 해준다. 디지탈 전자공학의 한결 향상된 고도의 신뢰도와 저렴한 비용은 머지않아 최상의 방법이 될 수 있게 한다.
결론적으로 중요한 점은 디지탈 공학이 새로운 연구기회를 열었고, 인간의 삶에 상당히 영향을 미치고 삶을 향상시키는 상품의 값이 합리적으로 책정이 될 수 있도록 했다는 점을 깨닫는 것이다. 몇몇 구어 소통과 관련이 있는 유망한 기구, 즉 자동 음성합성과 음성인식 등은 음성합성에서 토의될 것이다.