
단순회귀분석
이야기로 배우는 통계학 : 이해용. 이필용 공저, 자유아카데미, 2003, page 425~482
이번 장에서는 자료 분석기법 중에서 가장 많이 쓰이는 회귀분석을 살펴보자.
에스키모 속담에 "펭긴 아버지, 연어 어머니" 라는 말이 있다. 남을 위해서 희생하는 경우를 가리키는 말이다. 엄마 펭긴은 알을 낳고는 먹이를 찾아 먼 여행을 떠난다. 알을 품고 부화시키고 새끼를 돌보는 일은 아빠 펭긴 몫이다. 꼼작도 하지 않고 굶주린 채로, 며칠 후 엄마 펭긴은 먹이를 가득 담고 돌아온다. 그리고는 뱃속에 담아온 먹이를 새끼에게만 먹인다. 기진맥진한 아빠 펭긴은 그 옆에서 굶어죽는다.
엄마 연어 또한 강을 따라 내려가 바다에서 살다가 알을 낳을 때가 되면 고향인 강가로 돌아온다. 하루에 14 km 정도 급류를 타고 필사적으로 헤엄친다. 연어가 고향에 다다르고는 곧 알을 낳는다. 그리고는 기진맥진한 상태로 서서히 죽어간다. 자기가 낳은 알을 흐믓하게 바라보며 죽는다. 위대한 희생이요 자연의 섭리다.
이러한 현상이 '회귀' 다. 회귀란 무엇인가? 한마디로 '다시 본디 상태로 되돌아 온다' 는 뜻이다. 즉, 본디 모습으로 되돌아가려는 성향을 말한다. 중국 송나라 때 시인 도연명 (365 ~ 427) 은 관직을 버리고 고향 땅으로 되돌아가는 심경을 <귀거래사> 에 담았다. 그 귀거래사의 주제가 바로 회귀이다. 우리 나라에서도 매년 설날과 추석이 되면 고향으로 발걸음을 향하는 귀성 행렬이 끝없이 이어지는데, 고향 땅에 안기고 싶은 심경이 바로 회귀인 것이다.
서양에서는 영국의 유명한 유전학자 갈톤 (F. Galton, 1822 ~ 1891) 에 의해서 회귀라는 용어가 등장하였다. 그는 유전에 관한 논문 「Family Likeness in Stature (1886)」에서 처음 회귀에 대하여 정의하였다.
일반적으로 키가 큰 부모에게서 키 큰 자녀가, 키가 작은 부모에게서 키 작은 자녀가 태어난다. 그렇지만 자녀들의 평균 키는 전체 인구의 평균 키로 회귀하는 경향이 있다. 다시 설명하면 키가 큰 부모이든 작은 부모이든 그들에게서 태어난 자녀들의 평균 키는 전체 평균 키 수준에 접근하는 현상으로 나타난다는 것이다. 이러한 현상을 '보편적 회귀법칙 (law of universal regression)' 이라 한다.
보편적 회귀법칙은 피어슨 (K. Pearson, 1857 ~ 1936) 에 의해서 체계적인 회귀분석 이론으로 정립되었다. 피어슨은, 1,078 개 가족 구성원 자료를 수집하여 아버지 키와 아들 키 사이에 존재하는 회귀법칙을 규명하였다. 피어슨의 회귀법칙 결론은 다음과 같다.
아버지 키가 비교적 큰 집단에서 태어난 아들들의 평균 키는 그 아버지 평균 키보다는 작고, 아버지 키가 비교적 작은 집단에서 태어난 아들들의 평균 키는 그 아버지 평균 키보다 크다는 결론이다.
따라서 아들의 키는 전체 평균 키 수준을 향하여 회귀하는 현상을 나타난다는 것이다. 그런데 회귀분석에서 분명하게 구분할 것이 있다. 아버지 키가 아들 키에 영향을 주는 것이지, 아들 키가 아버지 키에 영향을 주는 것이 아니다. 또한 아들 키는 아버지뿐만 아니라 어머니의 키, 성장 과정에서 환경 및 인종에 따라 영향을 받는다. 그러므로 회귀분석에서는 변수를 반드시 영향을 주는 변수와 영향을 받는 변수로 구분한다.
영향을 주는 변수를 독립변수 (independent variable) 라하고 영문자 X 로 표기한다. 그리고 영향을 받는 변수를 종속변수 (dependent variable) 라 하고 영문자 Y 로 표기한다. 한편 자녀의 키를 예측하기 위하여 부모의 키가 설명변수로 이용될 수 있다. 그러므로 독립변수를 설명변수 (explanatory variable) 라 부르기도 하고, 종속변수를 설명된 변수로 부르기도 한다.
▶ 회귀분석
회귀분석은 본래 유전학적인 연구로부터 출발하였으나 그 적용분야는 광범위하다. 한 종속변수가 하나 이상의 독립변수에 의해 어떠한 영향을 받고 또한 어떠한 관계로 나타나는지 분석하는 기법이 회귀분석이다. 다시 설명하면 종속변수가 독립변수에 의해 어떠한 통계적 관계식으로 나타나는지를 밝히는 것이 회귀분석의 주요 목적이다.
회귀분석에서 밝히고자 하는 통계적 관계식은 바로 계량모형을 의미하는데 수학적 관계식과는 매우 다르다. 변수 사이에 존재하는 관계는 크게 두 종류로 구분할 수 있다. 하나는 확정적 관계이고 다른 하나는 통계적 관계이다. 어떠한 오차도 허용되지 않는 변수 사이에 관련성이 존재할 때 확정적 관계라 한다. 다시 설명하면 변수 사이에 관련성이 수학적 함수관계로 표현되면 확정적 관계이다.
예를 들어 원의 반지름을 r 이라 하고 원의 면적을 S 라 하자. 그러면 원의 면적과 반지름 사이에는 S = πr2 이라는 수학적 함수관계로 나타난다. 이러한 수학적 관계식은 오차의 개념이 없기 때문에 확정적 관계이다. 그런데 사회과학 현상이나 자연과학 현상에서 나타나는 변수들은 대부분 확정적 관계로 표현될 수 있는 경우는 거의 없다.
소득수준이 같은 근로자 가구라도 소비지출액은 각각 다르게 나타난다. 또한 동일한 등고선에 위치한 두 지역의 기온은 같은 온도로 나타나지 않는다. 뿐만 아니라 동일한 IQ 를 지닌 학생들이라 해서 성적이 같게 나타나지 않는다. 이와 같이 사회과학 현상이나 자연과학 현상은 변수 사이에 존재하는 관련성에 오차가 있어 대부분 통계적 관계로 나타난다. 그러므로 변수 사이에 존재하는 관계식을 밝힐 때에는 통계적 분석이 이루어져야 한다.
만약 두 변수 X, Y 사이에 통계적 관계가 존재한다면, 두 변수는 확률적으로 관련성이 있다는 뜻이다. 독립변수 X 값을 알면 종속변수 Y 값을 정확하게 알 수 있다는 뜻이 아니다.
예를 들어 근로자 가구 소득을 독립변수 X 로, 소비지출액을 종속 변수 Y 라 하자. 일반적으로 X 가 증가하면 Y 도 증가하고, X 가 감소하면 Y 도 감소한다. 그러나 소득수준 X 를 알고 있다고 해서 예측할 수는 있다. 여하튼 가계의 소득수준은 소비지출에 영향을 미칠 것이다.
그렇다면 소득수준이 한 단위 변할 때 소비지출은 어느 정도 변할 것인가? 즉, 한계소비성향은 얼마일까? 전체 가구를 모두 조사하여 한계소비성향을 산출할 수는 없다. 모집단을 구성하는 가구수가 매우 많기 때문이다. 그래서 모집단으로부터 표본을 추출하여 표본 자료에 나타난 통계량을 바탕으로 전체가구의 한계소비성향을 추정할 수밖에 없다.
▶ 산포도
종속변수와 독립변수가 어떠한 관계로 나타나는지 관련성 정도와 영향을 미치는 크기에 대하여 추정하고 가설검정하는 내용을 다루는 것이 회귀분석이다.
그런데 변수 사이에 존재하는 관련성 정도와 영향력 크기를 추정하기 위해서는 우선 변수 사이에 존재하는 관계식을 적절한 함수 형태로 도출해야 한다. 그러나 변수 사이에 확률적으로 존재하는 관계식을 함수 형태로 나타내는 것은 그리 쉬운 일이 아니다. 아이스크림 판매량에 대한 예를 살펴보자.
|
날씨가 더우면 아이스크림 판매량은 당연히 증가한다. 그런데 기온이 섭씨 1 도 올라감에 따라 아이스크림 판매량에 미치는 영향은 얼마나 될까? 이러한 물음에 올바른 해답을 간단히 구하기 어렵다. 온도라는 변수뿐만 아니라 다른 변수에 의해서 아이스크림 판매량은 영향을 받기 때문이다. |
이제 온도를 독립변수 X 로, 아이스크림 판매량을 종속변수 Y 로 표기하자. 그러면 종속변수 Y 는 독립변수인 X 뿐만 아니라 유동인구, 습도, 요일 등 여러 변수에 의하여 영향을 받는다. 그러나 회귀분석 개념을 설명하고자 두 변수 X, Y 만 존재하는 회귀분석으로 단순화하자. 그렇다면 기온과 아이스크림 판매량 사이에는 어떠한 관계식이 성립할 수 있을까? 즉 독립변수 X 와 종속변수 Y 사이에 존재하는 가장 적합한 함수식은 무엇일까? 두 변수 X 와 Y 에 대하여 조사한 결과 <표 1> 과 같은 자료를 수집했다고 하자.
<표 1> 기온과 아이스크림 판매량
|
|
|
|
|
|
|
|
(단위 : 도, 십만 개) |
||
|
온 도 (X) |
23 |
25 |
26 |
27 |
28 |
29 |
30 |
31 |
33 |
|
판매량 (Y) |
29 |
23 |
25 |
28 |
33 |
35 |
36 |
32 |
29 |
<표 1> 자료로부터 두 변수 X, Y 사이에 존재하는 관계를 적합한 함수식으로 도출하는 것은 쉬운 일은 아니다. 그러므로 우선 두 변수 X 와 Y 의 관계를 개괄적으로 파악할 필요가 있다. 그러기 위해서는 두 변수 X 와 Y 의 자료 값으로부터 평면좌표 상에 점을 찍어 그려볼 수 있다. 두 변수 X, Y 의 값에 대응하는 점을 평면좌표 상에 표현한 것이 그림 1 이다. 수집한 자료 값을 평면좌표 상에 점을 찍어 그림 1 과 같이 표현한 그림을 산포도 (scatter plot) 또는 산점도라고 한다.
그림 1 산포도
수집한 자료로부터 산포도를 그려보면 두 변수 X, Y 사이에 존재하는 관련성 정도와 방향을 눈짐작으로도 알 수 있다. 왜냐하면 산포도는 독립변수와 종속변수 사이에 존재하는 관계를 시각적으로 표시하고 있기 때문이다. 이러한 산포도를 자세히 살피며 두 변수 사이에 존재하는 중요한 3 가지 정보를 알 수 있다.
첫째, 두 변수 사이에는 정 (positive) 의 관계 또는 역 (negative) 의 관계로 나타나는지 알 수 있다.
X 가 증가할 때 Y 도 증가하면 정의 관계가 존재하는 것이고, 반대로 X 가 증가할 때 Y 는 감소하면 역의 관계가 존재하는 것이다. 그러므로 그림 1 에서 두 변수 X, Y 는 정의 관계가 존재함을 알 수 있다.
둘째, 두 변수 사이에 관계가 선형 (linear) 인가 또는 비선형 (nonlinear) 인가를 알 수 있다.
산포도에서 흩어진 점들이 직선에 가까운 형태로 나타나면 두 변수는 선형 관계가 있다고 표현한다. 한편 산포도에서 흩어진 점들이 직선 모양이 아닌 곡선 모양으로 나타난다면 두 변수는 비선형 관계에 있다고 표현한다. 그림 1 에서 두 변수 X, Y 는 직선에 가까운 모양으로 흩어져 있으므로 선형 관계가 있다고 할 수 있다.
셋째, 두 변수 사이에 존재하는 관련성 정도를 알 수 있다.
산포도에서 점들이 선형 모양을 따라 오밀조밀 뭉쳐 있으면 두 변수는 서로 관련성 정도가 높다고 한다. 그러나 산포도에서 나타난 점들이 넓고 어지럽게 흩어져 있으면 관련성 정도가 낮은 것이다. 이렇게 두 변수 사이에 관련성 정도가 낮게 나타나면 두 변수 사이에는 회귀분석을 적용할 수 없다. 산포도에서는 두 변수 사이에 존재하는 관계를 시각적으로 보여주고 있으나 두 변수 사이에 함수관계는 알 수 없다.
▶ 상관과 회귀
어떤 변수는 특정한 변수와 보다 긴밀한 관련성이 있는 경우가 있다. 예를 들면 사람의 발 크기는 손 크기와 깊은 관련성이 있다. 일반적으로 발이 큰 사람은 손도 크고, 손이 작은 사람은 발도 작다. 그러나 사람의 발 크기는 머리카락 개수와는 관련성이 거의 없다. 한편 어떤 기업의 광고비와 매출액 사이에는 깊은 관련성이 있으나 광고비와 신기술 개발과도 관련성이 깊다고 이야기 할 수 없다.
이렇게 두 변수 사이에 또는 여러 변수끼리 존재하는 관련성 정도를 나타내는 단위가 상관계수 (correlation coefficient) 이다. 두 변수 사이에 정의 상관관계가 존재하면 상관계수는 양 (+) 의 값으로 나타나고, 역의 상관관계가 존재하면 상관계수는 음 (-) 의 값을 갖는다. 그리고 상관계수 값이 ±1 에 접근하면 접근할수록 매우 밀접한 관련성이 있다는 의미이다. 한편 상관계수가 0 에 접근하면 두 변수 사이에는 관련성이 거의 없다는 것을 의미한다.
상관계수는 회귀분석에서 매우 중요한 통계량이다. 왜냐하면 상관계수 값에 의하여 적합한 회귀함수가 도출되기 때문이다. 회귀분석에서 독립변수가 한 단위 변화함에 따라 종속변수에 미치는 영향력 크기를 회귀계수 (regression coefficient) 라 한다. 일반적으로 두 변수 사이에 상관관계가 거의 없을 때 회귀계수는 의미가 없게 된다.
상관계수는 변수 사이에 존재하는 관련성 정도를 나타내는 단위이므로, 회귀계수와 매우 밀접한 관계를 맺고 있다. 회귀분석에서 중요하게 다루는 4 가지 중요한 내용은 다음과 같다.
첫째, 회귀분석에서는 독립변수가 종속변수에 미치는 평균적인 영향력 크기를 추정할 수 있다.
독립변수가 한 단위 변화함에 따라 종속변수가 미치는 영향력 크기가 회귀계수이다. 회귀계수는 또한 회귀선의 기울기를 의미한다. 따라서 회귀분석에서는 모집단이 갖는 모회귀선에 대하여 표본 자료를 바탕으로 추정하고 검정할 수 있다.
둘째, 회귀분석에서는 두 변수 또는 여러 변수 사이에 존재하는 관련성 정도를 나타내는 상관계수를 산출한다.
독립변수와 종속변수 사이에 관련성이 존재해야 회귀분석이 적용될 수 있다. 만약 두 변수 사이에 관련성이 거의 없는데 회귀분석을 적용하여 구한 회귀계수 추정치는 의미가 없게 된다. 그리고 표본회귀선의 적합성을 결정하는 결정계수 (determination coefficient) 는 상관계수로부터 구할 수 있다.
셋째, 회귀분석에서는 독립변수 값이 주어지면 그에 대응되는 종속 변수 값의 추정치를 구할 수 있다.
수집한 표본 자료 <표 1> 로부터 회귀분석을 완료했다면 기온이 27.8 도일 때 아이스크림 판매량을 추정할 수 있다. 이때 종속 변수 추정치는 평균값을 의미한다.
넷째, 회귀분석에서는 회귀계수 추정치를 구할 때 발생되는 오차 정도를 알 수 있다.
온도에 대응되는 아이스크림 판매량을 추정하는 데에는 오차가 발생될 수 있다. 이러한 오차의 정도를 알 수 있다.
모형 (model) 이란 '실제 상황에 대한 이상적 표현' 이다. 사회현상이나 자연현상이 실제 상황은 매우 복잡하고 여러 변수들이 복합적으로 작용하여 엉키어 있다. 따라서 실제 상황을 객관적ㆍ합리적으로 분석하기란 매우 어렵다. 그러므로 실제와 비슷한 모형을 설정하고 분석하여 실제 상황을 추정하고 검정한다.
모형의 종류에는 여러 가지로 구분할 수 있으나 회귀분석에서 다루는 모형은 수리적 모형 (mathematical model) 이다. 따라서 회귀분석에서 다루고 있는 수리적 모형을 단순하게 회귀모형 (regression model) 이라 한다.
▶ 모집단 회귀모형
회귀분석 대상이 되는 전체 집단에서 종속변수와 독립변수 사이에 존재하는 수리적 모형이 모집단 회귀모형이고, 간단하게 모회귀 모형 (population regression model) 이라 부르고 PRM 으로 표기한다. 앞에서 예를 들어 설명한 기온과 아이스크림 판매량에 대한 모회귀모형은 모집단을 이루는 전체 자료가 분석 대상이 된다.
<표 1> 의 표본 자료에서 기온이 섭씨 27 도일 때 아이스크림 판매량은 280 만 개이다. 그러나 모집단에서는 동일한 기온 27 도일지라도 아이스크림 판매량은 여러 가지 값으로 나타날 것이다. 즉 모집단에서는 독립변수 X 가 27 인 값으로 주어졌을지라도 종속변수 Y 는 무수히 많은 값을 갖는다. 그러므로 모집단에서 종속변수 Y 는 확률변수이다. 그러면 모집단에서 종속변수 Y 의 확률분포는 어떠한 모습으로 나타날까?
이제 기온이 각각 27 도와 30 도인 경우를 살펴보자. 그러면 모집단에서 독립변수 X 에 대응되는 종속변수 Y 의 확률분포는 당연히 그림 2 와 같은 모습으로 나타날 것이다. 모집단에서 독립변수 X 가 주어졌을 때 종속변수 Y 의 조건부 확률분포는 그림 2 에서 나타난 바와 같이 정규분포한다.
이제 Y 의 조건부 확률분포에서 평균을 μ 로 분산을 σ2 으로 표기하자. 그러면 모회귀모형은 독립변수 X 에 대응하는 종속변수의 평균을 연결한 선이다. 그리고 Y 의 확률분포는 다음 세 가지 조건을 만족시킨다고 가정한다.

그림 2 모집단에서 Y 의 확률분포
첫째, 종속변수 Y 의 평균치는 독립변수 X 에 관하여 선형함수이다.
종속변수의 평균치가 독립변수에 관하여 직선 형태인 선형관계로 나타난다. 즉, 여러 독립변수 X 값이 주어졌을 때 대응되는 종속변수 Y 의 기대치를 연결하면 직선 형태로 나타나게 된다. 이러한 직선 형태의 선을 모회귀선 (population regeression line) 이라하고 식 1 로 표기한다.
|
모회귀선
: |
식 1 |
모회귀선은 직선 형태로 존재하지 않을 수도 있지만 회귀분석 이론을 전개하기 위해서 모회귀선은 직선 모양의 선형함수라 가정한다. 식 1 은 모집단이 갖는 회귀모형이므로 참회귀선 (true regression line) 이라고 한다.
둘째, 독립변수 X 가 특정한 다른 값으로 주어진다 하더라도 대응하는 종속변수 Y 의 분산은 일정하다.
독립변수가 어떠한 값이라 할지라도 Y 의 확률분포 모양은 동일하다고 가정한다. 다시 설명하면 기온이 27 도일 경우나 30 도일 경우나 아이스크림 판매량의 확률분포는 분산이 동일하게 나타난다.
셋째, 종속변수 Y 는 확률변수로 정규분포한다.
회귀분석에서 독립변수는 주어진 값으로, 종속변수는 확률변수로 간주한다. 그러므로 종속변수는 모회귀선으로부터 오차가 존재할 수 있다.
이제 모집단에서 i
번째에 해당하는 독립변수 종속변수 오차항을 각각  로 표기하자. 그리고 오차항
 는 평균이 0 이고 분산이
 인 정규분포한다고 가정한다. 그러면 모집단에서 i 번째 종속변수
 를 모회귀선으로 표현하면 식 2 와 같다.
|
모집단에서
i 번째 종속변수 : |
식 2 |
식 2 에서 오차항  는 모집단의 회귀선 주변에서 교란시키며 나타나기 때문에 교란항 (disturbance
terms) 이라 부른다. 회귀분석에서 가장 주된 목적은 식 1 의 모회귀선에서
 를 밝히는 것이다.
그러나 모집단 크기는
매우 커서 모집단 전체를 조사하여 모수  과
 값을 구하는 것은 불가능하다. 그러므로 모집단으로부터 표본을 추출하여 표본의
회귀모형으로부터 모수
 과
 를 추정할 수밖에 없다.
▶ 표본회귀모형
모회귀모형 식 1 에서
종속변수 Y 는 독립변수 X 의 선형함수이다. 그리고 모수  과
 에 대해서도 선형관계임을 알 수 있다. 모회귀선에서
 은 회귀계수이고
 는 상수 (constant) 이다. 그러므로 모회귀선에서
 은 기울기이고
 는 절편을 의미한다. 회귀분석에서 상수
 는 중요한 의미를 지니고 있지 않다. 그러나 회귀계수
 은 매우 중요한 의미를 갖는다. 모회귀선이 선형일 경우
 은 기울기를 의미하므로 독립변수가 한 단위 변함에 따라 종속변수에 미치는
영향력 크기가
 이다.
그런데 회귀계수  과 상수
 는 알려져 있지 않은 모회귀선에서 모수이다. 그러므로 모집단으로부터 표본을
추출하여 표본 자료를 기초로
 과
 를 추정하는 것이 회귀분석의 주된 목적이다. 다시 설명하면 모집단의 회귀선을
추정하고자 표본회귀모형으로부터
 과
 에 대한 추정량을 구해야 한다.
표본 자료에서 표현할 수 있는 회귀모형을 표본회귀선 (sample regression line) 이라 한다. 여기서 모회귀선과 표본회귀선은 명확하게 구분되어야 한다.
왜냐하면 모회귀선은 모집단이 갖는 유일한 회귀모형으로 존재하지만, 표본회귀선은 표본 자료에 따라 여러 가지로 나타날 수 있기 때문이다. 표본에서 독립변수를 X 로 종속변수를 Y 로 표기할 때, 표본회귀선은 식 3 으로 표현한다.
|
표본회귀선
: |
식 3 |
식 3 은 표본 자료를
가장 잘 표현할 수 있는 표본회귀선을 의미하며  는 표본회귀선 상에 있는 추정된 종속변수 값을 나타낸다. 그리고
 은 표본회귀계수로서 모회귀계수
 에 대한 추정량이고, 표본회귀선에서
 는 상수로서 모회귀선의 상수
 에 대한 추정량이다. 따라서 표본회귀선에서 X 가 0 일 때
 는
 이다. 그러므로 상수
 는 표본회귀선이 Y 축을 통과하는 절편이다. 한편 표본 회귀계수
 은 표본회귀선의 기울기로서 독립변수 X 가 한 단위 변함에 따라 종속변수 Y
에 미치는 영향력 크기이다.
<표 1> 로 나타난
표본 자료를 가장 합리적으로 표현할 수 있는 표본회귀선을 구하면 표본회귀계수
( ) 는 0.718 이고, 상수 (
 ) 는 9.896 이다. 즉 표본 자료를 대표할 수 있는 표본회귀선은
 이다.
여기서 표본회귀선
 에 대하여 자세하게 살펴보자. 표본 자료에서
 는 i 번째 종속변수의 자료 값이고,
 는 표본회귀선 상에 위치한 종속변수 값이다. 즉,
 는 실제 값이고
 는 추정된 표본회귀선 상에 위치하는 값이다. 그러므로
 와
 는 차이가 있게 마련이다.
그러면 표본 자료를 가장 적합하게 대표할 수 있는 표본회귀선은 어떻게 구할 수 있을까? 즉, 식 3 의 표본회귀선에서 회귀계수 b 와 상수 a 는 어떻게 구할 수 있을까? 그리고 표본회귀계수 b 값은 정확성이 있는가? 또한 표본자료를 회귀모형에 적용시키는 것은 적합한 것인가? 뿐만 아니라 표본회귀계수는 과연 의미가 있는 것인가?
경제현상을 이루고 있는 변수들은 대부분 두 개 이상의 여러 변수가 복합적으로 관련성을 맺고 있다. 이러한 변수들의 관련성 성격과 크기를 밝히는 것이 회귀분석이다. 이번 장에서는 종속변수에 영향을 미치는 독립변수가 오직 하나만 존재하는 경우를 설명한다. 독립변수가 오직 하나만 포함하는 회귀를 단순회귀 (simple regression) 라 한다.
분석 대상이 되는 전체 집단에서 종속변수 (Y) 와 독립변수 (X) 는 어떠한 형태로 관계를 맺고 있을까? 즉 모집단에서 두 변수 X, Y 는 어떠한 회귀모형을 나타내는가. 가상적인 모집단 예를 살펴보자.
어린이가 좋아하는 바나나는 원래 인도 북부와 중국 남부 사이에서 자생하던 식물이었는데, 약 5 천년 전 동ㆍ서양으로 전파되었다고 한다. 바나나는 섭씨 10 도 이상인 아열대 지역에서 주로 재배되고 비타민 C 와 단백질이 풍부하다. 그런데 우리 나라에서 판매되고 있는 바나나는 대부분 수입된 것으로 유통기간이 너무 길어 영양가가 많이 파괴된 상태이다. 바나나를 동남아 나라에서 들여올 때는 15 일 정도, 중남미로부터 들여올 때는 35 일 정도 걸린다. 그러면 유통기간에 따라 비타민 C 파괴량은 어떠한 관계로 나타날까?
▶ 모집단 단순회귀모형
<표 2> 는 유통기간에 따라 바나나 한 개 (170 g) 에 비타민 C 파괴량에 대한 가상적인 전체 자료이다.
<표 2> 유통기간과 비타민 C 파괴량
|
유통기간 (일) : X |
15 |
20 |
25 |
30 |
35 |
|
비타민 C 파괴량 (mg) |
0 5 10 15 20 |
15 20 25 30 35 |
30 35 40 45 50 |
50 55 60 65 70 |
55 60 65 70 75 |
<표 2> 의 가상적 모집단으로부터 유통기간이 같을 지라도 비타민 C 파괴량이 변한다는 것을 알 수 있다. 유통기간이 20 일 지났을 경우 비타민 C 파괴량은 15 mg 에서 35 mg 사이에 여러 값으로 변하면서 나타난다. 즉 독립변수가 일정한 값으로 주어진 경우에도 종속변수는 여러 값을 갖는 확률변수이다. <표 2> 로 나타난 가상적인 모집단 자료를 시각적으로 평면좌표 상에 표현한 것이 그림 3 이다.

그림 3 모집단에서 회귀모형
그림 3 에서 모회귀모형은 독립변수 X 가 주어졌을 때 종속변수 Y 의 기대값을 연결한 선이다. 그러므로 모회귀모형을 모회귀선 (population regression line) 이라고 부른다. 단순회귀 모형에서 모회귀선은 직선 모양을 갖는다고 가정한다.
|
모회귀선
: |
식 4 |
식 4 모집단 회귀선에서
 은 기울기이며 모회귀계수 (population regression coefficient) 라 부르고,
 는 절편으로 모회귀상수 (population regression constant) 라 부른다. 단순회귀분석에서
모회귀선은 다음과 같은 특성을 갖는다.
첫째, 모회귀선은 종속변수의 기대치를 연결한 선이다.
둘째, 모회귀선은 직선 모양으로 나타나는데, 직선 모양을 선형 (linear) 이라 한다. 그러므로 모회귀선을 선형회귀모형이라 부른다.
셋째, 모회귀선을 중심으로 위ㆍ아래로 여러 종속변수 값이 흩어져 있다. 이것은 종속변수가 모회귀선을 중심으로 교란시키며 존재한다는 뜻으로 교란항 (disturbance terms) 이라 부른다.
식 4 로 나타난 직선
형태의 모회귀선에서 모수  과
 는 알려져 있지 않다. 그러므로 회귀분석에서 먼저 수행할 과제는
 과
 를 추정하는 것이다. 그런데 모집단 크기는 매우 커서 전체를 모두 조사하여
모수
 과
 를 구할 수 없다. 그러므로 모집단으로부터 표본을 추출하여 표본 자료를 바탕으로
표본회귀선을 구하여 모회귀선을 추정한다.
▶ 표본 단순회귀모형
가상적 모집단인 <표 2> 로부터 표본을 추출하여 <표 3> 과 같은 자료를 얻었다고 하자.
<표 3> 유통기간과 비타민 C 파괴량의 표본자료
|
유통기간 (일) : X |
15 |
20 |
25 |
30 |
35 |
|
비타민 C 파괴량 (mg) :Y |
20 |
25 |
40 |
50 |
65 |
표본으로부터 얻은 독립변수 (X) 와 종속변수 (Y) 값에 대응하는 점을 직교평면 상에 산포도로 나타낸 것이 그림 4 이다. 그림 4 에서 표본회귀모형은 산포도로 흩어진 점들을 대표하는 이상적인 선을 의미한다. 그러므로 표본회귀모형을 표본회귀선 (sample regression line) 이라 한다. 즉, 표본 자료를 가장 잘 대표할 수 있는 선이 표본회귀선이다.
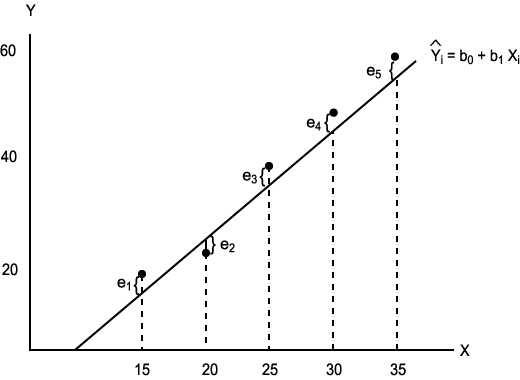
그림 4 표본회귀모형과 산포도
|
표본회귀선
: |
식 5 |
표본회귀선 식 5 에서
 은 기울기이며 표본회귀계수 (sample regression coefficient) 로써 모회귀계수
 의 추정치이다. 그리고 표본회귀선에서
 는 절편이며 표본회귀상수라 부르고, 모회귀상수
 의 추정치로 사용된다. 실제 표본에서 종속 변수 값
 와 표본회귀선 상에 있는 종속변수 값
 의 차이 (
 ) 를 잔차 (residual) 라 한다. 그러므로 표본에서 실제 종속 변수
 는 식 6 으로 나타난다.
|
표본회귀모형에서
종속변수 : |
식 6 |
단순회귀분석에서 표본회귀선의 특징은 다음과 같다.
첫째, 표본 자료를 가장 이상적으로 대표하는 선이 표본회귀선이다.
둘째, 표본회귀선에서
 과
 는 각각
 과
 에 대한 추정치이다.
셋째, 추정된 표본회귀선
 는 모회귀선 E(Y | X) 의 추정치이다.
넷째, 모회귀선은 오직 하나만 존재하지만, 표본회귀선은 표본에 따라 변한다.
그러면 표본 자료를
이상적으로 표현하는 표본회귀선은 어떻게 구할 수 있을까? 즉, 표본회귀선의  과
 는 어떻게 구해야 하는가? 그림 4 에서 알 수 있는 바와 같이 잔차 (
 ) 의 정도가 가장 최소가 되도록 표본회귀선을 구하면 된다.
그림 4 산포도로부터
표본 자료를 가장 이상적으로 표현한 표본회귀선은  이다. 그런데 실제 표본 자료에서 종속변수 값
 와 표본회귀선 상의 종속변수 추정치
 의 차이인 잔차 (
 ) 가 존재한다. 만약 표본 자료에 대응하는 가장 이상적인 표본회귀선이 추정되었다면,
잔차의 합 (
 ) 은 당연히 0 이 될 것이다. 왜냐하면 회귀선을 중심으로 + 값으로 나타나는
잔차와 - 값으로 나타나는 잔차가 서로 상쇄되기 때문이다.
그러므로 잔차의 합은
표본회귀선을 구하는데 별 쓸모가 없다. 그래서 최소자승법 (least square method)
을 이용하여 표본회귀선을 구한다. 잔차의 제곱 합 ( ) 을 최소화시키면서 표본회귀계수
 과 회귀상수
 를 구하는 방법을 최소자승법이라 한다. 그러면 최소자승법으로 표본회귀선을
구하는 과정을 설명하자.
i 번째 종속변수 값
( ) 과 표본회귀선 상의 종속변수 추정치의 차이로부터 잔차의 제곱 합은 식 7 로
정의된다.
|
잔차의
제곱 합 : |
식 7 |
식 5-4 에서  와
 는 표본 자료로부터 주어진 값이고,
 과
 는 미지수이다. 잔차의 제곱 합을 최소화시키는 조건은 식 7 을
 과
 에 관하여 편미분한 것이 0 를 만족해야 한다. 잔차의 제곱 합을 최소화시키는
조건을 풀이하면 식 8 로 표현된다.
|
|
식 8 |
식 8 를 정리하면 식 9 와 같은 정규방정식으로 표현된다.
|
정규방정식 : |
식 9 |
식 9 에서  가 있는 항을 소거하여
 에 관하여 풀이하면 표본회귀계수를 구하는 식 10 을 얻을 수 있다
|
표본회귀계수
(I) : |
식 10 |
 이고,
 이므로 식 10 을 정리하면 표본회귀계수를 구하는 식은 식 11 로 변형된다.
|
표본회귀계수
(II) : |
식 11 |
그리고 식 11 을 X 와 Y 의 편차 형태로 정리하면 표본회귀 계수를 구하는 식은 식 12 로 변형된다.
|
표본회귀계수
(III) : |
식 12 |
최소자승법에 의하여
표본회귀계수  을 구하는 식은 각각 다른 형태의 식 10, 식 11, 식 12 를 이용할 수 있으나,
그 중에서 어떠한 식을 이용하여
 을 구하여도 동일한 결과를 얻는다. 그러나 일반적으로 식 12 를 이용한다. 왜냐하면
종속변수 Y 와 독립변수 X 가 편차 형태로 표현되어 있기 때문이다. 표본회귀계수
 을 구하는 목적은 모회귀계수
 을 추정함에 있다. 그래서
 을 모회귀계수의 추정치라고 부르기도 한다.
이제 식 12 로 표현된
 을 구하는 공식을 자세히 살펴보자. 식 12 에서 분모는 독립변수 X 의 분산을
의미하고, 분자는 독립변수 X 와 종속변수 Y 의 공분산을 나타낸다. 따라서 표본회귀계수
 은 X 와 Y 의 공분산이 상대적으로 X 의 분산으로 나눈 값이다. 즉, 표본회귀계수는
X 와 Y 의 공분산이 상대적으로 X 의 분산보다 클수록 큰 값을 갖는다.
먼저 표본회귀계수
( ) 가 구해지면 회귀상수 (
 ) 는 쉽게 구할 수 있다. 식 9 의 ② 로부터
 에 관하여 정리하면 회귀상수를 구하는 식은 식 13 으로 쉽게 얻을 수 있다.
|
표본회귀상수
: |
식 13 |
이제 X 의 편차형태
 를
 로 표기하고, Y 의 편차형태
 를
 로 표기하자. 그러면 표본회귀계수
 은 간단히 식 14 로 표현될 수 있다.
|
편차형태의
표본회귀계수 계산식 : |
식 14 |
먼저 독립변수  와 종속변수
 값을 식 12 에 대입하여 표본회귀계수
 을 구할 수 있다. 그런데 표본 자료로부터
 을 계산하는 과정은 다소 번거롭다. 그래서 식 11 을 이용하면 조금은 간편하다.
왜냐하면 X 와 Y 의 평균치 편차를 하나하나 계산하지 않고서도
 을 구할 수 있기 때문이다.
물론 표본 자료가 상당히 큰 경우에는 컴퓨터를 이용하여 회귀계수를 편리하고 쉽게 구할 수 있다. 그러나 회귀분석의 원리를 바르게 이해할 수 있을 때 컴퓨터를 바르게 활용할 수 있고, 그 처리 결과도 바르게 해석할 수 있다.
그러면 <표 3>
으로 주어진 유통기간과 비타민 C 파괴량 자료로부터 최소자승법에 의한 회귀계수
 과 회귀상수
 를 구해보자. 먼저 회귀계수가 구해지는 과정을 자세히 살피고자 식 12 를 이용하여
 을 구한다.
 이 구해지면 회귀상수
 는 식 13 을 이용하여 쉽게 구할 수 있다. 계산 과정에서 혼란을 피하기 위해
<표 4> 와 같은 계산표를 만든다.
<표
4> 회귀계수  을 구하기 위한 계산표
|
|
|
|
|
|
|
|
15 20 25 30 35 |
20 25 40 50 65 |
-10 -5 0 5 10 |
-20 -15 0 10 25 |
100 25 0 25 100 |
200 75 0 50 250 |
|
|
|
- |
- |
∑ : 250 |
∑ : 575 |
<표 4> 에서
필요한 값을 선택하여 식 12 에 대입하면 표본회귀계수  은 쉽게 구할 수 있다.

구하고자 하는 표본회귀선의
회귀계수는 2.300 이다. 그리고  = 2.300 이므로 식 13 을 이용하면 회귀상수는 쉽게 구할 수 있다.

따라서 구하고자 하는 표본회귀선의 상수는 -17.400 이다.
그러므로 표본 자료 <표 3> 으로부터 유통기간 (X) 이 변함에 따라 비타민 C 파괴량 (Y) 의 표본회귀선은 식 15 로 표현할 수 있다.
|
추정된
표본회귀선
: |
식 15 |
추정된 표본회귀선에서
회귀계수  은 회귀상수
 보다 매우 중요한 의미를 갖는다. 회귀계수는 독립변수가 한 단위 변함에 따라
종속변수에 미치는 영향력 크기를 의미하기 때문에 매우 중요한 값이다. 그러나 회귀상수는
적합한 회귀선을 추정하기 위한 절편에 해당되므로 그다지 중요한 의미를 갖지 않는다.
그러므로 식 15 의 추정된 표본회귀선에서 상수 (
 ) 가 -17.500 으로 나타난 것은 별로 의미가 없다.
그런데 식 4 의 모회귀선에서
모회귀계수  과 모회귀상수
 는 알려져 있지 않다. 그리고 모집단 전체를 조사하여
 과
 를 구하는 것은 비효율적이다. 그러므로 모집단으로부터 표본을 추출하여 표본회귀선
 에서
 과
 를 최소자승법으로 구한다. 표본회귀계수
 은
 의 추정량이고, 표본회귀상수
 는
 의 추정량이다.
모회귀선은 하나만
존재하므로 모수  과
 는 오직 한 값만을 갖는다. 그러나 최소자승법으로 구한 표본회귀선은 표본 자료에
따라 변한다. 다시 설명하면 최소자승법으로 구한 표본회귀계수
 은 모수
 과 일치하지 않고 오차가 발생한다. 그래서 최소자승법으로 표본회귀선을 구하여
회귀분석함에는 다음과 같은 여러 가지 문제를 점검해야 한다.
첫째, 최소자승법으로
구한 표본회귀계수  은 정확한가?
둘째, 최소자승법으로 구한 표본회귀선에 표본 자료는 얼마나 적합성이 있는가?
셋째, 최소자승법으로
구한 표본회귀계수  은 과연 의미가 있는가?
이러한 세 가지 문제점을 간단히 정확성, 적합성, 유의성이라고 하는데, 다음 절에서 자세하게 설명하고 있다.
앞 절에서 설명한 바와 같이 표본회귀선은 표본 자료를 대표하는 이상적인 직선이다. 그 이상적인 표본회귀선은 최소자승법을 적용하여 구할 수 있다. 그렇다면 모든 표본 자료에 대하여 최소자승법을 적용할 수 있는가? 그렇지 않다.
식 4 로 설정된 모집단
회귀모형에서 종속변수  는 독립변수
 뿐만 아니라 교란항
 과도 깊은 관계가 있다. 그러므로 종속변수에 영향을 미치는 독립변수는 물론
교란항의 성격을 알아야 한다. 이미 설명한 대로 모회귀모형에서 독립변수는 주어진
값으로, 종속변수는 확률변수로 가정한다. 그러면 최소자승법을 적용하기 위한 가정에
대하여 살펴보자.
(가정 1) 교란항의 기대치는 0 이다. [E(ε) = 0].
모집단 회귀모형에서
회귀선을 중심으로 교란항이 존재하는데 그 교란항의 기대치는 0 이다. 즉 모회귀선
위ㆍ아래로 존재하는 교란항은 +, 또는 - 값을 갖는데 그 평균이 0 라는 것이다.
이러한 가정을 만족하는 조건에서 모회귀선은  를 의미한다.
(가정 2) 교란항의
분산은 동일하다 [ ].
주어진 독립변수 X 값에 따라 여러 값으로 나타나는 교란항의 분산은 X 값이 다른 값을 갖더라도 동일하다는 뜻이다. 다시 설명하면 여러 가지 X 값에 대응하는 종속변수 Y 는 동일한 분산을 갖는다는 가정이다. 그림 3 에서 종속변수 Y 가 동일한 분산을 갖는 것을 알 수 있다. 그러므로 가정 2 는 다음과 같은 식으로도 표시할 수 있다.

(가정 3) 교란항 사이에는
서로 상관관계가 없다 [ ].
교란항 사이에 상관관계를
자기상관 (autocorrelation) 이라 하고, 교란항끼리 관련성 정도를 의미한다. 주어진
두 X 값에 대응하는 두 종속변수 Y 값이 종속변수의 평균으로 떨어져 있는 차이를
교란항  라 하자. 그러면 교란항
 와
 는 서로 아무런 관련성이 없다는 가정이다. 모집단에서 독립변수 X 값이 주어졌을
때 종속변수 Y 값은 무수히 많이 존재한다. 따라서 Y 값이 평균으로부터 벗어난 교란항도
무수히 많이 존재한다. 서로 다른 교란항 사이에 관련성은 그림 5 에서와 같이 3
종류 모습을 나타낸다.
그림 5 에서 (가) 와 (나) 의 확률분포는 교란항 사이에 밀접한 관련성이 있음을 알 수 있다. 그러나 (다) 의 확률분포는 교란항 사이에 관련성이 없음을 보여주고 있다. 따라서 가정 3 을 만족시키는 확률분포는 (다) 에 나타나고 있다.
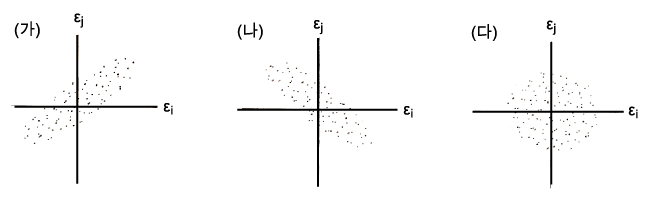
그림 5 3 종류 교란항 확률분포
(가정 4) 교란항과
독립변수 사이에 상관관계가 없다 [ ].
교란항과 독립변수
사이에 상관관계가 없다는 뜻은  와
 사이에 밀접한 상관관계가 있다면, 종속변수 Y 에 미치는 영향력 크기를 분리하여
측정할 수 없음을 의미한다. 그러면 모집단에서 종속변수 실제 값
 는
 로 표현될 수 없다.
(가정 5) 모회귀모형은 적합하게 설정되어 있다.
모회귀모형은 어떤 현상에 적합한 회귀모형이 설정되어야 한다. 예를 들어 경제현상을 분석할 경우 우선 계량경제모형을 설정해야 한다. 따라서 모회귀모형을 설정할 경우에는 다음 사항을 주의해야 한다.
첫째, 모회귀모형은 선형인가 비선형인가?
둘째, 모회귀모형에 포함될 독립변수는 무엇이어야 하는가?
셋째, 모회귀모형에
포함되는 변수  ,
 와 교란항
 의 확률적 성격은 가정을 만족시키는가?
앞에서 설명한 다섯 종류 가정을 만족시킬 때 최소자승법을 적용할 수 있는데, 이러한 가정은 모회귀모형에 해당하고 표본회귀모형에 적용되는 가정이 아니다. 그리고 적합한 회귀모형을 찾고자 하는 경우에는 자료를 분석자가 마음대로 조작하는 것을 피해야 하며, 이론에 벗어나지 않는 회귀모형을 설정해야 한다.
회귀분석의 중요한
과제는 모회귀선에서 모수  과
 를 바르게 밝히는 것이다. 그러나 모집단 크기가 매우 커서 모집단 전체를 조사하여
모수를 밝히는 것은 불가능하다. 그래서 표본을 추출하여 표본 자료를 바탕으로 최소자승법에
의하여 표본회귀선을 구한다. 표본회귀선의 회귀계수
 으로서 모수
 을 추정하므로 표본회귀계수
 을 최소자승추정치라고 부르기도 한다.
그러면 최소자승추정치는 어떠한 특성을 갖고 있으며, 정확성ㆍ적합성ㆍ유의성은 어떻게 측정할 수 있는가? 다음 절에서 설명하기로 한다.
회귀분석의 목적은
모회귀선  에서 모수
 과
 를 밝히는 것이다. 그런데 일반적으로 모집단 크기는 매우 커서
 과
 를 구하는 것은 불가능하다. 그래서 그 모집단으로부터 표본을 추출하여 표본회귀선을
 로 설정하고 최소자승법으로
 과
 를 구한다.
 은 모회귀계수
 의 추정치로,
 는 모회귀상수
 의 추정치로 사용한다.
그러나  과
 는 유일한 값으로 존재하지만
 과
 는 표본자료에 따라 변한다. 최소자승 추정량의 표준편차 즉, 표준오차가 크면
추정량은 정확성에서 문제가 발생한다. 그리고 표본 자료는 회귀모형으로 분석하는데
적합한가를 점검해야 한다. 이번 절에서는 최소자승법으로 구해진 표본회귀선 추정량이
어떠한 성격을 갖는지 살펴보자.
표본회귀선  는 최소자승법에 의하여 표본 자료로부터 구할 수 있다. 그러나 표본회귀계수
 과 회귀상수
 는 표본에 따라 변할 뿐만 아니라, 모회귀선의 모수
 과
 와 일치하지 않고 어느 정도 오차가 발생한다. 만약 오차 정도가 크게 나타난다면,
 과
 는
 과
 에 대한 추정치로써 정확성이 없게된다. 그러면 최소자승법에 의해 구한 표본회귀계수
 이 변화하는 정도는 어떠한가? 즉, 추정치
 의 표준편차 크기는 어떠한가?
만약  의 표준편차가 큰 값을 갖는다면, 표본에 따라
 값은 변화가 심하다는 뜻이므로 모수
 으로부터 오차가 발생할 가능성이 크다는 의미이다. 한편
 의 표준편차가 작은 값을 갖는다면, 표본에 따라
 값은 변화하는 정도가 작으므로 모수
 으로부터 오차가 발생할 가능성이 작다는 의미이다. 따라서 추정치로 사용되는
 의 표준편차를 표준오차 (standard error) 라 부르고 Se(
 ) 으로 표기한다.
그러면  의 표준오차 [Se(
 )] 크기는 어떻게 측량할 수 있는가? 제 3 장에서 설명한 바 있지만, 표준편차란
분산에 대하여 양의 제곱근을 취한 값이다. 또한 표준편차의 제곱이 분산이다. 그러므로
Se(
 ) 을 구하기 위해서 먼저
 의 분산을 계산해야 한다.
▶  의 표준오차
모회귀모형  를 추정하기 위해서 표본을 추출하여 최소자승법으로 표본회귀계수
 과
 를 구할 수 있다.
그런데 표본회귀계수
 은 표본에 따라 변하므로 확률변수로 취급할 수 있다. 그러면
 의 분산은 확률변수의 분산에 대한 정의에 따라 식 16 으로 표현될 수 있다.
식 16 은 이번 장 뒤 부분에 있는 부록 10.1 에서 증명하고 있다.
식 16 에서 회귀계수
추정치 ( ) 의 분산은
 크기에 비례하고,
 크기에 반비례 관계로 나타남을 알 수 있다. 다시 설명하면
 의 분산은 모집단에서 교란항 분산 크기에 비례한다.
|
,
단 |
식 16 |
그리고  의 분산은 독립변수 총 변량
 크기에 반비례한다. 그런데 독립변수 총 변량 크기는 표본 자료로부터 계산할
수 있지만 교란항 분산 (
 ) 은 알 수 없다.
앞 절에서 설명한 바와
같이 모회귀모형에서 독립변수 X 값이 주어졌을 때 종속변수 Y 의 확률분포는 동일한
분산을 갖는다고 가정하였다. 다시 설명하면 모회귀모형에서 교란항 ( ) 의 분산
 은 X 에 관계없이 일정하다는 가정이다. 그렇다면 교란항 분산 (
 ) 이 뜻하는 것은 구체적으로 무엇인가?
교란항 분산이 크다는
것은 종속변수 Y 의 분산이 크다는 것이므로 Y 의 변화 정도가 심하다는 뜻이다.
한편 교란항 분산이 작다는 것은 종속변수 Y 의 분산이 작다는 것이므로 Y 의 변화
정도가 작다는 뜻이다. 그런데 모집단 회귀모형에서 교란항 분산은 알려져 있지 않다.
그러므로 표본회귀선에 존재하는 잔차 ( ) 로서 교란항 분산을 추정할 수밖에 없다.
표본회귀선을 중심으로
잔차가 밀집되어 있으면 추정된 회귀선은 정확성이 있으며 모회귀선을 추정함에 있어서도
오차가 적게 발생될 것이다. 다시 설명하면 잔차의 제곱 합 ( ) 이 작은 값을 갖는다면 추정된 표본회귀선은 적합성이 있고, 모회귀선을 추정함에
오차가 적게 될 것이다. 한편 잔차의 제곱 합 (
 ) 이 큰 값을 갖는다면, 추정된 표본회귀선 (
 ) 은 정확성이 없어 신뢰할 수 없고 모회귀선을 추정함에도 오차가 클 것이다.
물론 표본 자료 개수가 많으면 비교적 잔차의 제곱 합은 큰 값을 갖는다. 그러므로
잔차의 제곱 합을 자유도 (n - 2) 로 나누어서 평균적 개념으로 사용해야 한다.
표본 자료에서 자료의
개수를 n, i 번째 종속변수 값을  , 표본회귀선상에 추정된 종속변수를
 로 표기하자. 그러면 잔차는
 이므로 교란항 분산 (
 ) 의 추정치는 식 17 로 표현된다. 식 17 은 이번 장 뒤 부분에 수록한 부록 10.2
에서 증명하고 있다.
|
교란항
분산 추정치
: |
식 17 |
식 17 로 나타난 교란항 분산 추정치를 양의 제곱근을 취한 것이 표본회귀선의 표준오차이다.
|
표본회귀선의
표준오차 : |
식 18 |
식 18 에서  가 큰 값을 갖는다면 표본회귀선으로부터 잔차가 크게 흩어져 나타나므로 추정된
표본회귀선 (
 ) 은 오차 정도가 크다는 뜻이다. 그런데 만약에 표본회귀선의 표준오차 (
 ) 가 0 값을 갖는다면, 표본회귀선으로부터 잔차가 전혀 존재하지 않기 때문에
종속변수
 값은 모두 표본회귀선 상에 위치한다는 뜻이다. 이러한 경우는 수학적 함수 관계에서만
존재하고 실제에서는 존재할 수 없다. 식 17 에서 잔차의 제곱 합 (
 ) 을 (n - 2) 로 나누는 이유는 교란항 분산 추정치 (
 ) 가 교란항 분산 (
 ) 에 대하여 불편추정량이 되기 위함이다.
그러면 추정된 표본회귀계수
 의 분산을 계산하는 식 16 을 살펴보자. 식 16 에서 교란항 분산 (
 ) 은 알 수 없으므로 식 17 에서 구한 추정치 (
 ) 를 대신 사용한다. 그러므로 식 16 에서
 대신
 를 사용하고 양의 제곱근을 취한 값이 바로 표본회귀계수
 의 표준오차이고 Se(
 ) 로 표기한다.
|
표본회귀계수
|
식 19 |
식 19 에서 Se( ) 가 뜻하는 바를 자세히 살펴보자. 표본회귀계수는 표본 자료에 따라 변하는데,
최소자승법으로 구한 표본회귀계수의 정확성 정도를 측량하는 단위가 바로 Se(
 ) 이다.
Se( ) 이 큰 값을 갖는다는 것은 표본회귀계수
 이 표본에 따라 변화하는 정도가 심하다는 뜻이다. 그리고 Se(
 ) 이 작은 값을 갖는다는 것은 표본회귀계수
 이 표본에 따라 변화하는 정도가 작다는 뜻이다. 그러므로 Se(
 ) 이 작은 값을 가질 때 표본회귀계수
 이 모회귀계수
 에 대하여 오차가 적은 정확성 있는 추정치로 사용될 수 있다.
이제 앞 절에서 표본
자료 <표 3> 으로부터 구한 표본회귀계수  에 대한 표준오차를 구해보자. 최소자승법에 의하여 추정된 표본회귀선은 식
14 로부터 얻은
 이다. Se(
 ) 를 계산하는 과정은 조금은 복잡하고 혼동이 되므로 다음과 같은 순서로 구한다.
첫째, 추정된 표본회귀선
상에 종속변수  값을 구할 수 있다.
둘째, 잔차 ( ) 를 구한다.
표본 자료에서 종속변수
 값으로부터 첫째 단계에서 구한 종속변수 추정치
 를 빼어서
 를 구할 수 있다.
셋째, 잔차의 제곱
합 ( ) 을 구한다.
 은 둘째 단계에서 구한 각각의
 에 대하여 제곱한 다음 합하여 구할 수 있다.
넷째, 교란항의 분산
추정치 ( ) 를 구한다.
셋째 단계에서 구한
 을 (n - 2) 로 나누어
 을 구할 수 있다.
다섯째,  를 식 19 에 대입하여
 의 표준오차를 구한다.
넷째 단계에서 구한
 의 표준오차를 구하기 위하여 <표 5> 와 같은 계산표를 작성하는 것이
편리하다.
<표
5> Se( ) 를 구하기 위한 계산표
|
|
|
|
|
|
|
15 20 25 30 35 |
20 25 40 50 65 |
17.0 28.5 40.0 51.5 63.0 |
3.0 -3.5 0.0 -1.5 2.0 |
9.00 12.25 0.00 2.25 4.00 |
|
|
|
- |
- |
|
<표 5> 로부터
 = 27.500 이므로
 = 9.167 이다.
따라서  = 250 과
 = 9.167 을 식 19 에 대입하여
 의 표준오차를 구하면 0.1915 이다.
 ≒ 0.1915
▶  의 표준오차
표본회귀선에서 회귀상수
 는 회귀계수
 과는 밀접한 관련성이 있다. 표본회귀계수
 이 표본에 따라 변하는 것과 마찬가지로 회귀상수
 도 표본에 따라 변한다. 그리고 동일한 표본에서도
 과
 는 깊은 관련성이 있기 때문에,
 과
 의 공분산 (covariance) 은 식 20 과 같이 표현된다.
|
|
식 20 |
여기서 공분산이란 개념을 살펴보자. 공분산이란 두 변수 사이에 존재하는 관련성 정도를 측정할 때 사용되는 것으로 두 변수가 갖는 공통 분산이다. 두 변수 사이에 공분산이 크다는 것은 두 변수가 관련성이 크다는 뜻이다. 즉, 한 변수가 큰 편차로 나타나면 다른 변수도 큰 편차로 나타난다는 뜻이다. 공분산의 정의로부터 식 20 이 성립함을 증명하자.

식 20 으로 나타난
 과
 의 공분산 성질을 이용하면, 표본회귀상수
 의 분산은 식 21 로 표현된다.
|
표본회귀상수
|
식 21 |
식 21 로부터  의 표준오차는 제곱근을 취함으로써 쉽게 구할 수 있다.
앞 절에서는 최소자승법으로
구한 회귀계수  에 대한 정확성을 측정하는 표준오차에 대하여 설명하였다. 이번 절에서는 표본
자료는 추정된 회귀선 (
 ) 에 적합한가를 측정하는 결정계수 (determination coefficient) 에 대하여 설명한다.
두 변수 사이에 선형관계로 추정된 표본회귀선은 표본 자료에 적합하게 표현된 것인가?
추정된 표본회귀선의 적합성을 반드시 짚어보아야 한다. 서로 다른 적합성을 보이고
있는 두 종류 산포도가 그림 6 으로 나타나 있다.
그림 6 에서 (가) 산포도는 표본 자료가 추정된 회귀선과 적합하지만, (나) 산포도는 적합하지 않음을 보여주고 있다.
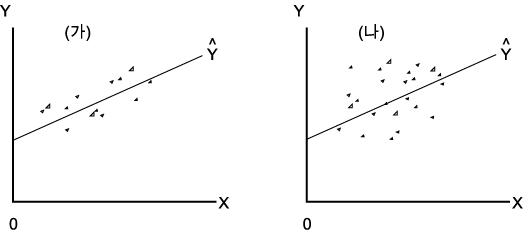
그림 6 두 종류 산포도와 회귀선
따라서 (나) 산포도와 같이 나타난 표본 자료를 회귀분석에 적용하는 것은 적합하지 않다.
그러면 추정된 표본회귀선으로부터
적합성 정도를 어떻게 측정할 수 있는가? 종속변수  의 편차를 기본 단위로 적합성을 측정할 수 있다. 독립변수
 에 대응하는 종속변수
 와 추정된 표본회귀선
 는 그림 7 로 나타나 있다.
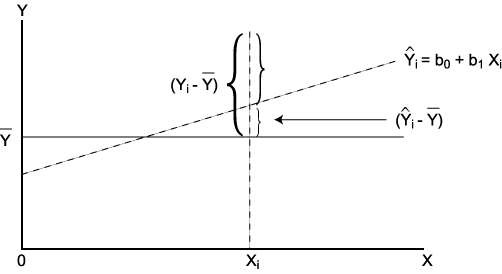
그림 7  의 구성
그림 7 에서 종속변수의
편차  는 회귀선으로 추정된 종속변수의 편차
 와 잔차 (
 ) 의 합으로 구성되어 있다. 이러한 관계를 표현한 것이 식 22 이다.
|
종속변수
편차의 구성 : |
식 22 |
식 22 로부터 종속변수의
총 변량 크기는 어떠한 관계로 표현되는지 살펴보자. 총 변량이란 변수가 갖는 총
변동 크기로서 편차의 제곱 합으로 계산된다. 따라서 종속변수 Y 의 총 변량 크기는
 이다. 식 22 에서 양변에 대하여 제곱 합을 구하는 식을 전개하면 총 변량은
식 23 으로 나타난다.
|
주석 : |
종속변수의 총 변량이 식 23 으로 전개되는 것을 증명하자. 표본
종속변수 종속변수
평균값 : ① 에서 ② 식을 빼어서 정리하면 ③ 식을 얻는다.
편차형태로 나타난 ③ 식을 간단한 기호로 표기하여 ④ 식을 얻는다.
④ 식으로부터 최소자승법에 의하여 추정된 회귀선은 ⑤ 식으로 표현된다.
④ 식과 ⑤ 식으로부터 추정된 회귀선은 종속변수와 잔차로만 구성된 ⑥ 식이 성립한다.
⑥ 식에서 양변에 대하여 제곱합을 취하면 식 6-8 을 얻을 수 있다.
⑦ 식은 식 23 과 같다. |
|
종속변수의
총 변량 : |
식 23 |
식 23 에서 나타난 각각의 변량에 대하여 그 뜻을 살펴보자.
첫째,  은 종속변수가 갖는 총 변량이다.
표본자료에서 나타난 종속변수가 갖는 총 변동 크기가 변량이다.
둘째,  은 추정된 회귀선 상에서 종속변수가 갖는 총변량이다.
 은 추정된 회귀선에 의하여 설명 가능한 변동 크기를 나타내는 변량이다.
셋째,  은 잔차의 제곱 합으로 잔차가 갖는 총 변량이다.
잔차의 제곱 합은 회귀선 위ㆍ아래로 흩어진 크기이므로 추정된 회귀선에 의하여 설명할 수 없는 변동 크기이다.
이제 종속변수의 총 변량은 어떠한 요소로 구성되는지 살펴보자. 총 변량 크기를 TSS (= Total Sum of Squares) 로, 추정된 회귀선에 의하여 설명 가능한 변량을 ESS (= Explained Sum of Squares) 로, 회귀선으로부터 벗어난 잔차의 변량을 RSS (= Residual Sum of Squares) 로 표기하자. 그러면 식 23 은 식 24 와 같은 관계식으로 표현된다.
|
종속변수의 총 변량 : TSS = ESS + RSS |
식 24 |
식 23 과 식 24 에서
양변에 대하여 총 변량 TSS ( ) 로 나누면 식 25 가 성립한다.
|
변량의
상대적비율 : |
식 25 |
식 25 에서 설명 가능한
변량에 대한 총 변량 비율 (ESS/TSS) 을  으로 표기하면,
 은 총 변량 중에서 설명 가능한 변량이 차지하는 비율이다. 그러므로
 값이 크면 클수록 표본 자료는 추정된 회귀선에 의하여 설명 가능한 변량 부분이
크다는 뜻이다. 다시 설명하면
 값이 큰 값을 가질 때 표본 자료는 회귀선에 의하여 잘 설명될 수 있으므로 적합성이
있다는 뜻이다. 따라서
 은 표본 자료를 회귀분석으로 적용함에 적합성이 있는가를 결정하는 결정계수라
한다.
추정된 회귀선이 표본
자료에 적합한가를 측정하는 결정계수 ( ) 는 다음과 같은 특성이 있다.
첫째,  은 제곱 합의 상대적 비율이므로 음 (-) 의 값을 가질 수 없다.
둘째,  은 0 에서 1 사이에 값을 갖는다 (0 ≤
 ≤ 1).
만약에  값이 0 이라면 표본회귀선으로 설명 가능한 부분이 없다는 뜻이므로 두 변수
X 와 Y 사이에는 전혀 관계가 없다. 그러므로
 값이 0 에 가까우면 회귀분석을 적용함에 적합치 않다는 뜻이다.
한편  값이 1 이라면, 표본회귀선은 완전히 적합하다는 뜻이므로 두 변수 X 와 Y 사이에는
잔차가 전혀 없는 하나의 수학적 함수이다. 그러므로
 값이 1 이라면 회귀분석을 적용할 수 없다.
식 25 로부터 결정계수와 변량 비율 사이에 존재하는 관계 식을 표현한 것이 식 26 이다.
|
|
식 26 |
결정계수와 회귀계수는
매우 밀접한 관계가 있다.  값이 1 에 접근할수록 독립변수 X 와 종속변수 y 는 매우 관련성이 크다는 뜻이다.
그러므로 결정계수 (
 ) 는 회귀계수 (
 ) 로부터 계산될 수 있다. 식 25 로부터
 = ESS/TSS 이다. 그런데 ESS 는 다음과 같이 회귀계수로 표현될 수 있다.

따라서 결정계수와 회귀계수 사이에 관계식을 나타낸 것이 식 27 이다. 식 27 로부터 결정계수는 회귀계수 제곱에 두 변수의 변량 비율을 곱한 것이다. 다시 설명하면 두 변수 X 와 Y 의 상관계수는 회귀계수를 두 변수의 표준편차 비율로 곱한 것과 같다.
|
결정계수와
회귀계수 : |
식 27 |
(예제 1) 농촌 가구의 한계소비성향은 어떻게 나타날까? 수많은 농촌 가구를 모두 조사할 수 없다. 그래서 농촌 마을에서 5 농가를 표본으로 추출하여 <표 6> 와 같은 소득과 소비지출에 관하여 자료를 얻었다.
<표 6> 5 농가의 소득과 소비지출
|
소 득 (만원) : X |
65 |
75 |
80 |
85 |
95 |
|
소비지출 (만원) : Y |
50 |
55 |
60 |
65 |
70 |
(1) 표본회귀모형을  로 설정하여 표본회귀선을 구하라.
(2) 추정된 표본회귀계수 ( ) 의 표준오차를 구하라.
(3) 표본 자료는 표본회귀선에 얼마나 적합한가? 결정계수를 구하라.
(풀이 1) 예제로부터 두 종류 변수가 있다. 소득 (X) 은 독립변수이고 소비지출 (Y) 은 종속변수이다.
(1) 최소자승법으로 표본회귀선을 구하기 위해서는
 과
 를 계산하는 공식을 이용하면 된다.
식 12 와 식 13 으로부터  이고
 이다. 먼저
 을 구하기 위해서 <표 7> 과 같은 계산표를 작성한다.
<표 7> 표본회귀계수를 구하기 위한 계산표
|
|
|
|
|
|
|
|
65 75 80 85 95 |
50 55 60 65 70 |
-15 -5 0 5 15 |
-10 -5 0 5 10 |
225 25 0 25 225 |
150 25 0 25 150 |
|
|
|
- |
- |
Σ = 500 |
Σ = 350 |
<표 7> 로부터  이므로 표본회귀계수를 쉽게 구할 수 있다.

표본회귀상수 ( ) 는
 값을 이용하여 구할 수 있다.

따라서 표본 자료로부터 구하고자 하는 표본회귀선은 다음과 같다.

(2) 표본회귀계수 ( ) 의 표준오차 [
 ] 를 구하기 위해서는 식 19 를 이용한다. 그런데 식 19 를 이용하기 위해서는
먼저 교란항 분산의 추정치 (
 ) 를 구해야 한다.
 를 구하는 계산 과정이 복잡하므로 계산표를 만들어 원하는 값을 구한다. 우선
먼저 표본회귀선에
 값을 대입하여
 값을 계산한다.
<표 8>  를 구하기 위한 계산표
|
|
|
|
|
|
|
|
65 75 80 85 95 |
50 55 60 65 70 |
49.5 56.5 60.0 63.5 70.5 |
0.5 -1.5 0.0 1.5 -0.5 |
0.25 2.25 0.00 2.25 0.25 |
100 25 0 25 100 |
|
- |
- |
- |
- |
Σ = 5.00 |
Σ = 250 |
잔차의 제곱 합으로부터 (n - 2) 로 나누어  를 구한다.

독립변수의 편차 제곱 합 ( ) 은 500 이므로 표본회귀계수 (
 ) 의 표준오차 [
 ] 를 쉽게 구할 수 있다.

그러므로 표본회귀계수의 표준오차는 0.0577 이다.
(3) 결정계수 ( ) 는 추정된 표본회귀선의 표본 자료에 적합한가를 측정하는 단위이다. <표
8> 로부터 잔차의 제곱 합 (RSS) 은 5.00 이고, 총 변량 크기 (TSS) 는 250 이므로
식 26 을 이용하여
 를 쉽게 구할 수 있다.

 는 0.980 이므로 추정된 회귀선은 표본 자료에 98 % 정도 적합성을 보이고 있다.
앞 절에서 표본회귀계수 ( ) 의 정확성과 표본회귀선의 적합성에 대하여 설명하였다. 이번 절에서는 최소자승법에
의하여 구한 표본회귀계수 (
 ) 는 모수
 에 대하여 어떠한 특성이 있는지 살펴보기로 한다.
우선  의 표본분포는 어떠한 성격으로 나타나는지 알아보자. 모집단에서 모회귀모형은
 으로 유일하게 존재한다. 그러한 모집단으로부터 크기 (n) 가 동일한 표본은
무수히 많이 추출할 수 있다.
각 표본 자료로부터 최소자승법으로 표본회귀계수
( ) 를 구하면, 각 표본에서 구한
 은 일정한 값이 아니라 변하는 확률변수이다. 그러면 각 표본에서 구한
 은 어떠한 모습을 갖는 표본분포일까?
 의 표본분포는 당연히 그림 8 과 같은 정규분포 모습으로 나타날 것이다.
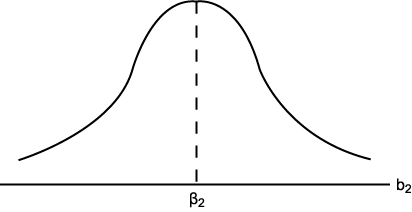
그림 8 표본회귀계수의 표본분포
그런데 최소자승법으로 구한 표본회귀계수 ( ) 의 특성을 한마디로 최량선형불편추정량 (BLUE : Best Linear Unbiased Estimator)
이라고 표현한다. 즉, 최소자승법으로 구한
 은 최고로 좋은 직선 형태를 갖고 편의 (bias) 가 없는 추정량이라는 뜻이다.
이러한 최량선형불편추정량은 다음과 같은 3 종류 특성을 갖는다.
첫째, 추정량  은 선형 (= 직선 형태) 함수이다.
둘째, 추정량  은 모수
 에 대하여 불편추정량이다.
셋째, 추정량  은 다른 추정량보다 최소 분산을 갖는다.
이러한 3 종류의 특성 중에서  이 선형이고 불편추정량인지 증명하여 보자. 표본회귀계수 (
 ) 를 구하는 식은 편차 형태로 식 ① 로 표현된다.
 ㆍㆍㆍ①
① 식에서  이므로
 는 식 ② 로 변형될 수 있다.
 이므로
 ㆍㆍㆍ②
② 식에서  이라 하자. 그러면 ② 식은 ③ 식으로 변형된다.
 ㆍㆍㆍ③
③ 식에서  는 종속변수
 의 선형함수임을 알 수 있다.
그러면 표본회귀계수 ( ) 는 모수
 에 대하여 불편추정량인가? 불편추정량 (unbiased estimator) 란 편의가 없는
추정량이다. 불편 (unbiased) 이란 추정량이 모수에 대하여 한쪽으로 치우침이 없는
상태를 뜻한다. 다시 설명하면 추정량의 기대치를 취한 값이 모수와 같을 때 그 추정량을
불편추정량이라 부른다. 그러므로 불편추정량이란 매우 바람직한 추정량 성격을 뜻한다.
즉,
 를 만족한다면
 은
 의 불편추정량이다.
 이 불편추정량인지 증명하기 전에 ③ 식에 나타난
 의 특성을 먼저 살펴보자.
첫째,  이므로 독립변수
 는 주어진 값으로 간주하기 때문에
 도 확률적으로 변하는 값이 아니라 주어진 값으로 취급한다.
둘째,  의 합계는 0 이다 (
 ).
왜냐하면  에서 분자에 해당하는
 는 편차의 합 [
 ] 이므로 0 이다.
셋째,  와
 를 곱하여 합한 값 (
 ) 은 1 이다.
 에서 양변에
 를 곱하여 더하면 다음과 같다.
|
|
위 식은 다음과 같은 식으로도 변형될 수 있다.
 이므로

넷째,  이 성립한다.
왜냐하면  이 성립하기 때문이다.
이러한  의 성질을 이용하여
 가 불편추정량임을 증명하자. 모회귀선은
 이므로 바로 앞쪽 ③ 식에 대입하여 정리하면 다음과 같은 관계로 나타난다.

 이므로
 ㆍㆍㆍ ④
④ 식에서 기대치를 취하면 다음과 같은 관계가 성립한다.
 ,
 는 모수이므로
 ,
 이므로
 ㆍㆍㆍ⑤
⑤ 식에서  이므로 표본회귀계수는 모회귀계수 (
 ) 에 대하여 불편추정량이다.


 의 최소화 조건 :


 - ①
 - ②


 = 25
 = 40

 의 분산
:

 은 교란항 분산이고,
 은
 이다.


 의 표준오차 :


 = 25
 = 40
 = 27.50
 과
 의 공분산 :

 의 분산 :


 값 :
 ㆍㆍㆍ①
 ㆍㆍㆍ②
 ㆍㆍㆍ③
 ㆍㆍㆍ④ ;
 ,

 ㆍㆍㆍ⑤
 ㆍㆍㆍ⑤
 이므로
 ㆍㆍㆍ⑦
 ㆍㆍㆍ⑧


 와 변량 비율 :


 = 80
 = 60


