핵심 개념 이해하기: 비유
결정 경계(Decision Boundary)가 데이터를 나누는 메커니즘을 현실 세계의 국경선과 바리케이드에 비유하여 직관적으로 이해할 수 있습니다.
고정형 결정 경계 (Static Decision Boundary)
국경선에 튼튼한 콘크리트 장벽을 세우는 것과 같습니다. 한 번 세우면 지형이 바뀌거나 사람이 몰려도 경계선을 쉽게 옮길 수 없습니다.
적응형 결정 경계 (Adaptive Decision Boundary)
상황에 따라 유연하게 움직이는 '이동식 바리케이드'와 같습니다. 특정 구역에 사람이 많아지거나 지형이 변하면, 그에 맞춰 바리케이드의 위치와 모양을 최적의 형태로 조정합니다.
주요 특징 및 작동 방식
적응형 결정 경계는 주로 다음과 같은 상황이나 알고리즘에서 핵심적인 역할을 합니다.
1 개념 드리프트(Concept Drift) 대응
- 시간이 지나면서 데이터의 성격이나 트렌드가 변하는 현상을 '개념 드리프트'라고 합니다.
- 적응형 결정 경계는 실시간 스트리밍 데이터나 시계열 데이터를 학습하면서, 변화하는 트렌드에 맞춰 경계선을 스스로 업데이트합니다. (예: 스팸 메일 패턴 변화 대응, 계절별 금융 이상 거래 탐지)
2 비선형(Non-linear) 데이터 분류
- 데이터가 직선 하나로 깔끔하게 나뉘지 않고 복잡하게 얽혀있을 때, 커널 기법(Kernel Tricks)이나 신경망을 활용해 경계선의 곡률과 형태를 데이터에 맞게 유연하게 구부립니다.
- 단순한 초평면을 넘어 다차원 곡면이나 복합 결정 영역을 동적으로 형성합니다.
3 온라인 학습(Online Learning) 및 능동 학습(Active Learning)
- 데이터가 한꺼번에 주어지지 않고 하나씩 추가될 때마다(온라인 학습), 혹은 모델이 모호한 데이터를 판별하기 위해 추가 라벨링을 요청할 때(능동 학습) 결정 경계를 미세하게 조정해 나갑니다.
- 전체 데이터를 처음부터 다시 재학습하지 않고도 지속적인 성능 개선을 달성합니다.
고정형 vs 적응형 결정 경계 비교
전통적인 고정형 결정 경계와 현대적인 적응형 결정 경계의 핵심적인 특성을 다각도로 비교 분석한 표입니다.
| 구분 | 고정형 결정 경계 (Static) | 적응형 결정 경계 (Adaptive) |
|---|---|---|
| 유연성 | 낮음 (일정한 규칙이나 선을 유지) | 높음 (데이터 분포에 따라 곡선/다차원으로 변형) |
| 변화 대응 | 데이터 트렌드가 바뀌면 전체 재학습해야 함 | 새로운 데이터가 들어오면 실시간으로 경계 수정 가능 |
| 대표 알고리즘 | 선형 회귀, 단순 선형 SVM 등 | 인공신경망(ANN), KNN, 커널 SVM, 앙상블 모델 등 |
| 장점 | 연산이 빠르고 모델 구조가 단순함 | 복잡하고 실시간으로 변하는 데이터 처리에 매우 강함 |
| 단점 | 복잡한 패턴이나 급변하는 데이터 변화에 취약함 | 과적합(Overfitting) 위험이 있고 상대적 연산량이 많음 |
주요 활용 분야
실시간 환경 변화와 사용자 상호작용이 중요한 최첨단 인공지능 시스템 전반에서 적응형 결정 경계가 필수적으로 활용되고 있습니다.
🛡️ 이상 탐지 (Anomaly Detection)
신용카드 부정 사용(FAD) 탐지 시스템에서 사용자의 평소 소비 패턴 변화에 맞춰 정상/이상을 나누는 기준선을 지속적으로 바꿉니다. 해외 여행이나 명절 등 특수 상황에서의 정상 결제를 오탐 없이 유연하게 수용합니다.
🚗 자율주행 (Autonomous Driving)
날씨, 도로 상태, 주변 차량의 움직임 등 시시각각 변하는 도로 환경 데이터를 입력받아 안전 구역과 위험 구역의 경계를 실시간으로 재설정합니다. 폭우나 야간 주행 시 제동 안전 마진을 능동적으로 확장합니다.
🎯 사용자 추천 시스템
사용자의 관심사와 취향이 시간이 흐름에 따라 변화할 때, 최근의 클릭 및 구매 패턴을 가중 반영하여 선호와 비선호의 경계를 동적으로 재조정함으로써 개인화 추천의 정확도를 극대화합니다.
적응형 결정 경계의 수학적 원리 및 가중치 적응 메커니즘
적응형 결정 경계의 근간을 이루는 선형 판별 함수(Discriminant Function)와 오류 정정 학습 규칙(Error-Correction Adaptation Rule)을 표준 HTML 수식으로 분석합니다.
- 결정 경계(Decision Boundary) 방정식: D = 0 은 특성 공간(Feature Space)을 두 개의 클래스로 양분하는 초평면(Hyperplane)입니다.
- 분류 판정 규칙:
- D > 0 이면 Class +1 로 분류
- D < 0 이면 Class -1 로 분류
- D = 0 이면 경계선 바로 위에 위치하여 판정이 모호한 상태를 나타냅니다.
- 두 클래스가 단 하나의 초평면 D = 0 으로 완전 분리될 수 있을 때 선형 분리 가능(Linearly Separable)하다고 부릅니다.
오류 발생 시 가중치 갱신 규칙 (Adaptation Algorithm)
입력 샘플 x의 실제 정답 클래스를 d ∈ {+1, -1} 라 하고, 현재 모델이 계산한 판별 함수를 D 라 할 때, 오분류(D ≠ d 또는 d · D ≤ 0)가 발생하면 다음과 같이 가중치를 적응시킵니다:
w0(new) = w0(old) + c · d · k
🔍 왜 경계선이 정확한 방향으로 스스로 이동하는가? (수학적 증명)
가중치 갱신 후 새로운 판별 함수값 Dnew는 다음과 같이 전개됩니다:
Dnew = Dold + c · d · (k + ∑i=1M xi2)
여기서 c > 0 이고 (k + ∑ xi2) > 0 이므로 항 c(k + ∑ xi2) 는 항상 엄격한 양수(+)입니다.
• 실제 정답이 d = +1 인데 음수로 오분류된 경우: Dnew > Dold 가 되어 판별값이 양수 방향으로 증가합니다.
• 실제 정답이 d = -1 인데 양수로 오분류된 경우: Dnew < Dold 가 되어 판별값이 음수 방향으로 감소합니다.
따라서 가중치를 업데이트하는 것은 부정확하게 분류된 샘플을 올바른 클래스 영역으로 편입시키기 위해 결정 경계를 목표 샘플의 반대편으로 밀어내는 물리적 이동을 의미합니다.
[실제 예제 1] 1차원 데이터의 Step-by-Step 적응 및 수렴 분석
단 하나의 1차원 수치 특성 x를 갖는 가장 기본적인 분류 문제에서, 결정 경계 x = -w0 / w1 가 매 반복 단계마다 어떻게 동적으로 이동하여 최적 분리점에 수렴하는지 관찰합니다.
| 샘플 번호 (i) | 입력 특성 (x) | 실제 정답 클래스 (d) |
|---|---|---|
| 1 | -4 | -1 (Class -1) |
| 2 | -1 | +1 (Class +1) |
결정 경계 수식: D = w0 + w1x = 0 ⇒ x = -w0 / w1
목표 경계 위치: -4 와 -1 사이에 결정 경계선이 위치하면 두 클래스가 완벽히 분리됩니다.
반복 단계별 가중치 및 결정 경계 변화 추적표 (t = 1 ~ 8)
| 반복(t) | 샘플(i) | 특성(x) | 정답(d) | Old w0 | Old w1 | 판별값 D | 오분류 여부 | New w0 | New w1 | 결정 경계 위치 (x = -w0 / w1) |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 1 | -4 | -1 | 0 | 0 | 0 | 오분류 (Error) | -1 | 4 | x = -(-1)/4 = +0.25 |
| 2 | 2 | -1 | +1 | -1 | 4 | -5 | 오분류 (Error) | 0 | 3 | x = -0/3 = 0.00 |
| 3 | 1 | -4 | -1 | 0 | 3 | -12 | 정상 분류 | 0 | 3 | x = 0.00 (유지) |
| 4 | 2 | -1 | +1 | 0 | 3 | -3 | 오분류 (Error) | 1 | 2 | x = -1/2 = -0.50 |
| 5 | 1 | -4 | -1 | 1 | 2 | -7 | 정상 분류 | 1 | 2 | x = -0.50 (유지) |
| 6 | 2 | -1 | +1 | 1 | 2 | -1 | 오분류 (Error) | 2 | 1 | x = -2/1 = -2.00 |
| 7 | 1 | -4 | -1 | 2 | 1 | -2 | 정상 분류 | 2 | 1 | x = -2.00 (유지) |
| 8 | 2 | -1 | +1 | 2 | 1 | +1 | 정상 분류 | 2 | 1 | x = -2.00 (최종 수렴 완료!) |
🎯 1차원 수렴 결과 분석:
초기 경계선 x = 0.25 에서 시작하여 오분류가 일어날 때마다 경계선이 0.25 → 0.00 → -0.50 → -2.00 으로 좌측(음수 영역)으로 점진적 이동(적응)하였습니다.
마침내 t = 7과 t = 8에서 두 샘플(x = -4 와 x = -1) 모두에 대해 에러가 0이 되었으며, 최종 결정 경계는 정확히 두 데이터 사이인 x = -2.00 에 안착하여 알고리즘이 성공적으로 수렴 종료되었습니다.
[실제 예제 2] 그림(The position.GIF)을 활용한 적응형 결정 경계의 실제 작동 예시
2차원 공간 상의 6개 샘플 데이터에 대해, 학습 반복(Iteration)과 하이퍼파라미터 k(특징 스케일 보정 계수)의 크기에 따라 결정 경계선이 어떻게 회전 및 평행이동하며 수렴하는지 기존 연구 도면을 바탕으로 정밀 분석합니다.
2차원 분류 학습 데이터셋 (2 Features, 2 Classes)
| 특성 1 (x1) | 특성 2 (x2) | 정답 클래스 (d) | 데이터 군집 설명 |
|---|---|---|---|
| 2 | 10 | +1 |
Class +1 군집 (원점 근처의 작은 수치 분포) |
| 3 | 8 | +1 | |
| 5 | 2 | +1 | |
| 50 | 25 | -1 |
Class -1 군집 (원거리의 큰 수치 분포) |
| 65 | 30 | -1 | |
| 35 | 40 | -1 |
📊 학습 반복에 따른 적응형 결정 경계의 공간적 이동 궤적
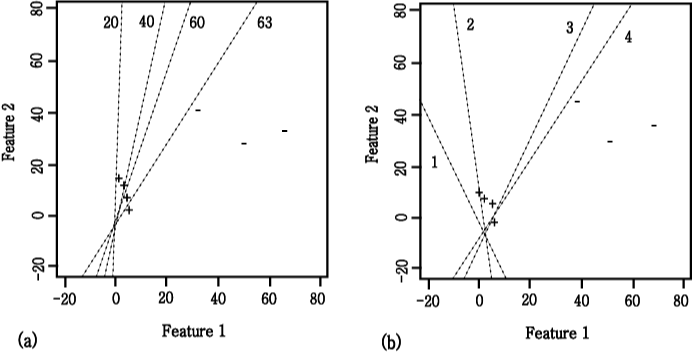
(a) c = 1, k = 1 (기본 파라미터)
지연 수렴: 63회 반복 (381 Step)- 반복 횟수에 따른 경계선 이동: training set에 대하여 20회, 40회, 60회, 63회의 알고리즘 반복에 걸쳐 결정 경계선의 기울기와 절편이 서서히 회전하며 변화합니다.
- 주요 병목 요인 (좌표 5, 2): 좌표 (5, 2)는 Class +1에 속하면서도 Class -1 군집 방향에 가장 근접해 있어, 경계선 마진(Margin)을 확보하기가 매우 까다롭습니다.
- 수렴 속도 지연 원인: 입력 특징의 수치 범위가 정규화(Normalization)되지 않은 상태(최대 65 vs 최소 2)에서 바이어스 스케일 계수 k = 1 이 너무 작았기 때문에, 가중치가 최적 분리선까지 회전하는 데 무려 381 step (약 63회 전체 데이터셋 반복)이 소요되었습니다.
(b) c = 1, k = 23 (평균절대값 스케일링)
초고속 수렴: 단 4회 반복 완료!- 스케일 보정 계수 k = 23 도입: 특징 데이터들의 평균 절대값에 해당하는 k = 23 을 바이어스 업데이트 상수로 지정하였습니다.
- 균형 잡힌 업데이트 보폭: 바이어스 w0의 갱신 보폭(c · d · k)이 특징 가중치 w1, w2의 갱신 보폭(c · d · xi)과 동일한 자릿수(Order of Magnitude)를 갖게 되었습니다.
- 경이로운 수렴 속도 향상: 1회, 2회, 3회, 4회의 알고리즘 반복만에 결정 경계가 완벽한 선형 분리 위치에 도달하였으며, 단 4번의 반복만에 알고리즘이 완벽히 수렴하는 것을 명확히 확인할 수 있습니다.
💡 실제 작동 예시에서 얻는 패턴인식의 핵심 실무 교훈
2. 특징 스케일링(Feature Scaling)의 절대적 중요성: 데이터의 스케일 차이가 크면 특정 축의 가중치만 과도하게 갱신되어 결정 경계의 회전 수렴이 극도로 지연됩니다.
3. 하이퍼파라미터 튜닝: 적응 파라미터(c, k)를 데이터의 통계적 특성(평균, 분산)에 맞추어 적절히 보정해주면 동일한 데이터셋이라도 수렴 속도를 15배 이상 극적으로 단축(63회 → 4회)시킬 수 있습니다.