
패턴인식의 원리 : 서론
패턴 인식의 원리 1권 : 이성환, 홍릉과학출판사, 1994, Page 3~34
인식 능력은 살아 움직이는 다른 유기체뿐만 아니라 인간의 기본 속성으로 간주된다. 우리는 깨어 생활하는 매 순간마다 인식 활동을 하고 있다. 주위에 있는 대상물을 인식한 다음, 그와 관련하여 움직이고 행동한다. 우리는 군중 속에서 친구를 찾아낼 수 있고, 그 친구가 말하는 것을 인식할 수 있다. 아는 사람의 음성을 알아차릴 수 있다. 우리는 필기된 문자나 기호, 그리고 그림 등을 보고 이해할 수 있으며, 지문을 분석할 수도 있다. 화난 몸짓과 미소짓는 표정을 서로 구별할 수 있다. 인간이 매우 복잡한 정보 시스템이라 할 수 있는 부분적인 이유는 월등한 패턴 인식 능력을 보유하고 있기 때문이다.
하나의 패턴은 어떤 대상물을 묘사한 것이다. 우리의 인식 행위는 인식하고자 하는 대상 패턴의 속성에 따라 두 개의 주된 형태로 분류할 수 있는데, 하나는 구체적인 항목에 대한 인식 (recognition of concrete item) 이고, 다른 하나는 추상적인 항목에 대한 인식 (recognition of abstract item) 이다. 우리는 주변의 문자, 그림, 음악, 그리고 여러 종류의 물체를 인식할 수 있는데, 이것을 "감각적 인식 " (sensory recognition) 이라고 부른다. 여기에는 시각 및 청각 패턴을 인식하는 것이 포함된다. 이러한 인식 과정에는 공간적이고 시간적인 패턴에 대한 식별 및 분류가 포함된다. 반면에, 눈을 감고 귀를 막은 상태로 오래된 어떤 논거 또는 문제에 대한 해답을 인식할 수 있다. 이러한 과정은 추상적인 항목을 인식하는 것으로 시각 또는 청각 패턴 인식과 대비하여 "개념적 인식" (conceptual recognition) 이라 부른다. 이 책에서는 첫 번째 형태의 패턴 인식에 관하여 다룬다. 공간적인 패턴으로는 문자, 지문, 천기도, 물체, 그리고 그림 등을 들 수 있고 시간적인 패턴으로는 음성, 파형, 심전도, 그리고 시계열 등을 들 수 있다.
인간이 구체적인 패턴을 인식하는 것은 인간과 물리적인 자극 간의 관계와 연관된 정신 생리학적인 문제 (psychophysiological problem) 로 간주될 수 있다. 인간은 감지한 패턴을 귀납적인 추론을 통해 과거의 경험으로부터 유도해 낸 일반적인 개념이나 단서와 연관지운다. 실제로, 인식 문제는 입력 데이터를 알려진 통계적 모집단 중의 하나와 연관시킬 수 있는 상대적 가능성을 추정하는 것으로 볼 수 있다. 이 때, 통계적 모집단은 과거의 경험에 의존하며 인식에 필요한 단서와 사전 정보를 형성하게 된다. 따라서, 패턴 인식 문제는 개개의 패턴 중에서 입력 데이터를 구별하는 것이 아니라, 모집단의 구성원 중에서 특징 또는 변하지 않는 속성을 탐색함으로써 모집단 중에서 입력 데이터를 구별하는 것으로 간주될 수 있다.
논리적인 측면에서 볼 때, 패턴 인식 문제에 대한 연구는 두가지의 주요 범주로 나눌 수 있다. 하나는 인간 및 다른 유기체의 패턴 인식 능력에 대하여 연구하는 것이고, 다른 하나는 특정 응용 분야에서 주어진 인식 업무를 수행할 수 있는 장치들을 설계하기 위한 이론과 기법을 개발하는 것이다. 첫 번째 문제 영역은 심리학, 생리학, 생물학과 같은 학문 분야와, 두 번째 문제 영역은 주로 공학, 컴퓨터 그리고 정보 과학과 관련된다.
이 책에서는 자동적 패턴 인식 시스템을 설계하는데 연관되는 컴퓨터, 정보 과학, 그리고 공학적인 측면을 다룬다. 간단히 말해서, 패턴 인식은 데이터로부터 중요한 특징이나 속성을 추출하여 입력 데이터를 식별할 수 있는 부류로 분류하는 것으로 정의될 수 있다. 일기 예보를 패턴 인식 문제로 다룰 수 있는데, 인식 시스템은 입력으로 받아들인 천기도에서 중요한 특징을 추출하여 천기도를 해석한 다음, 추출된 특징을 바탕으로 일기 예보를 하게 된다. 의료 진단 역시 패턴 인식 문제로 다룰 수 있다. 어떤 증상이 인식 시스템의 입력 데이터 역할을 하는데, 이 때 인식 시스템은 입력 데이터인 증상을 분석하여 질병을 구별해 낸다. 문자 인식 시스템은 광학 신호를 입력 데이터로 받아들여 그 문자의 이름을 식별하는 패턴 인식 시스템이다. 음성 인식 시스템에서는 입력 데이터로 받아들인 음향의 파형에 바탕을 두고 발음된 단어의 이름을 식별해 낸다. 표 1 에서는 여러 종류의 분류 업무를 각각에 상응하는 입력 데이터 및 출력 반응과 함께 기술하였다.
표 1 다양한 패턴 분류 업무
|
분류 업무 |
입력 데이타 |
출력 반응 |
|
문자 인식 음성 인식 화자 인식 기후 예측 의료 진단 주식 시장 예측 |
광학 신호 또는 영상 음향의 파형 음성 천기도 증상 금융 소식 및 재무 도표 |
문자의 이름 단어의 이름 화자의 이름 일기 예보 질병 시세의 오르내림 예측 |
패턴 인식 문제는 수 많은 과학 분야를 포함할 수 있다. 즉, 많은 패턴 부류 (pattern class) 로 부터, 애매한 구성 요소를 포함하는 집합에서 주어진 한 부류의 구성원을 인식하는 공통의 문제에 대한 해답을 찾기 위하여 이들 과학 분야와 결합하게 된다. 패턴 부류는 어떤 주어진 공통의 속성으로 결정될 수 있는 범주 (category) 이고 패턴은 그 범주에 속하는 패턴 부류를 나타내는 구성 요소를 묘사한 것이다. 서로 다른 부류에 속하는 패턴 집합이 있을 때, 어떤 자동화된 장치를 이용하여 이들 패턴을 그들이 속한 각각의 부류로 분류하는 것이 필요할 때가 있다. 사용이 정지된 수표를 읽어서 구별해 내는 것도 패턴 인식 문제의 한 예가 된다. 이러한 일은 사람도 쉽게 할 수 있으나, 기계를 사용하면 훨씬 빠른 속도로 처리할 수 있다. 반면에, 어떤 인식 업무는 사람 만으로는 거의 수행할 수 없는 종류의 문제일 수도 있다. 그러한 인식 문제의 예로, 수중음 (subaquatic sound) 을 분석하여 다른 선박들의 신호와 잡음이 섞인 가운데에서 잠수함의 음을 감지하는 문제를 들 수 있다.
패턴 인식 문제에 대한 명료하고도 단순한 해법은 각 패턴 부류의 특징을 추출하기 위하여, 개개의 입력 패턴에 대한 간단한 실험을 많이 수행하는 것이다. 그러한 실험은 서로 다른 부류에 속하는 사용가능한 입력 패턴을 서로 구별하기에 충분해야 한다. 예를 들어, 다음 4 개의 글자를 고려해 보자.
|
패 |
턴 |
인 |
식 |
그림 1 문자 분류를 위한 간단한 질의-응답 구조
수직획, 수평획, 폐곡선, 그리고 사선 및 역사선이 있는 지를 조사하고 획수를 세어 봄으로써 이 간단한 문자들을 구별할 수 있다. 그림 1 은 이러한 예제에 대한 패턴 인식 개념을 보여 준다. 두 번째 예로, 다음과 같은 5 자의 영문자를 고려해 보자.
|
C |
O |
I |
N |
S |
만 (bay) 과 같은 하나의 개곡선, 호수와 같은 폐곡선, 수직선, 역사선, 그리고 만과 같은 두 개의 개곡선 등의 특징을 조사해 봄으로써 위의 영문자들을 분류할 수 있다.
이전의 직관적인 개념은 자동적 패턴 인식 시스템의 설계를 상당히 단순화시킬 수 있다. 그러나, 실세계에서 할 수 있는 모든 가능한 실험 가운데 어떤 실험을 입력 패턴에 적용해야 하는 가를 결정해 줄 수 있는 일반적인 이론은 존재하지 않는다. 실험을 너무 적게 하거나 빈약하게 하면, 각각에 해당하는 패턴 부류로 분류되도록 입력 패턴을 특징지울 수가 없다. 반면에, 너무 많은 실험을 하게 되면, 분석시에 소요되는 계산의 복잡도를 증가시키게 된다. 적절한 실험 집합을 찾아내는 방법에 대한 실마리를 제공해줄 수 있는 어떠한 일반적인 규칙도 존재하지 않는다. 이러한 접근방법은 인식 시스템 설계자의 과거 경험과 공학적인 직관에 너무 의존한다. 따라서, 실제로 발생하는 많은 패턴 인식 문제에 대한 만족할 만한 해답을 주지는 못한다. 패턴 인식 과정에 내포된 문제를 주의깊게 연구해 봄으로써, 보다 더 강력한 접근방법을 착안해 낼 수가 있다. 이 책에서는 이러한 문제에 대하여 조사하고 분석한다.
패턴과 패턴 부류 간에는 계층적인 관계가 존재한다. 그림 2 에서, 알파벳과 숫자 및 한자는 패턴이고, 문자는 하나의 패턴 부류에 해당한다. 만일, 알파벳과 숫자를 패턴 부류로 보면, 영어 알파벳과 아라비아 숫자가 패턴에 해당한다. 예를 들어, 인쇄되거나 필기된 문자 A 는 패턴 부류인 영어 알파벳 A 에 속하는 패턴이다. 수 많은 정보 시스템에서, 다양한 활자체로 인쇄된 문자와 숫자, 그리고 서로 다른 형태로 필기된 문자와 숫자를 인식할 수 있는 기계를 필요로 한다. 이 경우, 26 개의 대문자와 26 개의 소문자 그리고 10 개의 숫자를 나타내는 총 62 개의 패턴 부류가 존재한다. 특정 문자 또는 숫자의 다양한 활자체와 형태는 그 패턴 부류내이 패턴을 형성한다.
문자 인식 문제를 고려해 보자. 인쇄체이건 필기체이건 간에 하나의 문자 또는 숫자는 식별가능한 공통 속성을 가지고 있다. 문자 또는 숫자는 관측된 속성에 따라 식별되고 분류된다. 따라서, 패턴 인식 시스템의 기본 기능은 동일한 패턴 부류에 속하는 대상물을 묘사한 패턴에서 공통 특징을 감지하여 추출한 후에, 어떠한 새로운 환경에서든지 이 패턴을 인식하여 해당 패턴 부류의 구성원으로 분류하는 것이다.

그림 2 패턴과 패턴 부류 간의 계층 관계
일반적으로, 자동적 패턴 인식 시스템을 설계할 때 여러 가지 굵직한 문제가 발생한다. 첫 번째는 인식하고자 하는 대상물로부터 측정할 수 있는 입력 데이터를 표현하는 방법에 관한 문제이다. 이것은 감지하는 문제 (sensing problem) 이다. 각각의 측정된 양 (quantity) 은 패턴 또는 대상물의 특성을 묘사한다. 예를 들어, 문제의 패턴이 영문자와 숫자라고 가정해 보자. 이러한 경우에는 그림 3 (a) 에 보인 것과 같은 격자형 측정 기법을 효과적으로 센서에 사용할 수 있다. 격자가 n 개의 원소로 구성되었다고 가정하면, 다음과 같은 측정 벡터 또는 패턴 벡터의 형태로 그 측정치를 표현할 수 있다.
 (1)

그림 3 패턴 벡터의 생성을 위한 간단한 두가지 구조
여기서,  번째 격자가 문자의 일부분을 포함하고
있으면, 원소
 에 1 을, 그렇지 않으면 0 을 배정한다. 의미가 명백한 경우에는 패턴 벡터를
단순히 패턴이라고 부르기로 한다.
그림 3 (b) 는 두 번째 예를 보여 준다. 이 경우,
패턴은 음향 신호와 같이 변수 t 로 구성된 연속 함수에 해당한다. 이 함수가 불연속
점  에서 표본 추출되었다면,
 으로 패턴 벡터를 구성할 수 있다.
패턴 벡터는 x, y, z 처럼 획이 굵은 소문자로
표기하기로 한다. 편의상, 이러한 벡터를 식 (1) 과 같은 열벡터 (column vector)
로 가정한다. 본문에 나타나는  도 같은 의미로 사용할 것이다. 여기서, 프라임 부호 (') 는 전치 (transposition)
를 나타낸다.

그림 4 구별되는 두 개의 패턴 부류
패턴 벡터는 패턴에 관하여 사용가능한 모든 측정
정보를 포함하고 있다. 임의의 패턴 부류에 속하는 대상물을 측정하는 것은 알파벳
집합  에 속하는 하나의 기호를 각 패턴의 특성에 배정하는 부호화 과정 (coding process)
으로 간주할 수 있다. 측정을 통하여 실수 형태의 정보를 만들어 낼 때, 하나의 패턴
벡터를 n 차원 유클리드 공간 (Euclidean space) 상의 한 점으로 간주하는 것이 종종
유용하다. 동일한 부류에 속하는 패턴 집합은 측정 공간상의 임의의 영역내에 산재해
있는 점들의 집합에 해당한다.
 과
 는 각각 프로 미식 축구 선수들과 경마 기수들을 원소로 하는 집합으로 가정할
수 있다. 각각의 "패턴" 은 키와 몸무게에 대한 두 개의 측정치로 특징지워진다.
따라서, 패턴 벡터는
 와 같은 형태가 된다. 여기서,
 은 키를 나타내고
 는 몸무게를 나타낸다. 각각의 패턴 벡터는 2 차원 공간상의 하나의 점으로 간주될
수 있다. 그림 4 에 나타나 있듯이, 이들 두 부류는 측정치의 속성으로 인하여 서로
분리된 집합을 형성한다. 그러나, 실제 상황에서는 말끔히 분리된 집합을 결과로
내주는 측정법을 항상 명시할 수는 없다. 예를 들어, 구별하기 위하여 선택한 기준이
키와 몸무게라면 프로 미식 축구 선수 부류와 프로 농구 선수 부류 간에 상당한 중복이
존재하게 될 것이다.
패턴 인식 시스템 설계시의 두 번째 문제는 받아들인 입력 데이터의 특징 또는 속성을 추출하는 문제와 패턴 벡터의 차수를 줄이는 문제이다. 이러한 문제는 종종 전처리 및 특징 추출 문제라고 일컬어 진다. 예를 들어, 음성 인식에서 주파수 대역내의 주파수에 관한 에너지 분포를 측정함으로써 모음과 유사 모음을 마찰음 및 다른 자음과 구별할 수 있다. 음성 인식에 공통적으로 사용되는 특징으로는 음의 지속 기간, 다양한 주파수 대역에서 에너지의 비율, 주파수 대역에서 최고점 (spectral peak) 또는 포만트 (formant) 의 위치, 시간상에서 이들 최고점의 이동 등을 들 수 있다.
패턴 부류의 특징은 그 부류에 속하는 모든 패턴의 공통적인 성격을 나타내는 속성이다. 그러한 특징을 종종 집합 내부 간 특징 (intraset feature) 이라고 한다. 반면에, 패턴 부류 간의 차이점을 나타내는 특징을 집합 간 특징 (interset feature) 이라고 한다. 고려중인 모든 패턴 부류에 공통적으로 존재하는 집합 내부 간 특징의 원소는 부류 간의 구별에 사용할 수 없는 정보이므로 무시할 수 있다. 특징 추출은 패턴 인식 시스템의 설계에 있어서 중요한 문제로 간주되어 왔다. 측정한 데이타로 부터 각 패턴 부류 간에 서로 구별되는 완전한 특징 집합을 결정할 수 있다면, 패턴 인식 및 분류의 어려움은 별로 없을 것이다. 이 경우, 간단한 정합 과정 또는 테이블 조회 (table look-up) 구조로 자동 인식 과정을 단순화시킬 수 있다. 그러나, 실제로 발생하는 대부분의 패턴 인식 문제에서는, 서로 구별되는 완전한 특징 집합을 결정하는 것이 불가능하거나 아니면 매우 어렵다. 다행스럽게도, 관측한 데이타로 부터 구별력이 강한 특징을 종종 찾아 낼 수 있다. 이러한 특징은 자동 인식 과정을 간단하게 해 준다. 예를 들어, 제 II 권의 5 장에서 소개되듯이, 정보의 손실을 최소화하는 변환을 통하여 측정 벡터의 차수를 감소시킬 수 있다.
패턴 인식 시스템 설계시에 발생하는 세번째 문제는
최적의 결정 절차를 선택하는 문제로, 구별 및 분류 과정에 필요하다. 인식할 패턴으로부터
관측한 데이터를 패턴 공간상의 패턴 점 또는 측정 벡터 형태로 표현한 후에, 이
데이터가 어느 패턴 부류에 속하는 가를 결정해야 한다.  으로 표기된 M 개의 서로 다른 패턴 부류를 인식하는 인식기를 설계한다고 가정하자.
그러면, 패턴 공간이 각 부류에 대한 패턴 점들을 둘러싸고 있는 M 개의 영역으로
구성된다고 간주할 수 있다. 인식 문제는 관측한 측정 벡터를 바탕으로 하여 M 개의
패턴 부류를 분리시킬 수 있는 결정 경계를 생성하는 문제로 볼 수 있다. 예를 들어,
결정 경계가 결정 함수
 로 구성되어 있다고 간주해 보자. 판별 함수라고 부르기도 하는 이 함수들은
스칼라이면서 단일 값을 갖는 패턴 x 에 관한 함수이다.
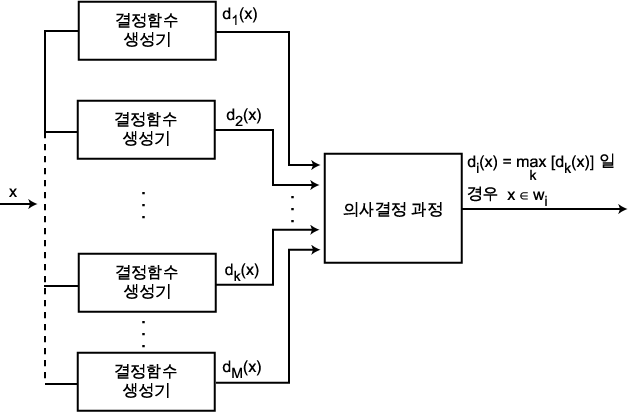
그림 5 패턴 분류기의 블럭 구조도
만일,  가 자신과 다른 모든
 에 대하여
 이면, 패턴 x 는 패턴 부류
 에 속한다. 다시 말해서,
 번째 결정 함수
 가 패턴 x 에 대하여 가장 큰 값을 가지면, 패턴 x 는 패턴 부류
 에 속하게 된다. 그러한 의사 결정 과정을 사용하는 자동 분류 구조가 그림 5
에 개념적으로 설명되어 있다. 다양한 방법으로 결정함수를 만들 수 있는데, 인식할
패턴에 대한 완벽한 사전 지식 (prior knowledge) 을 사용할 수 있는 경우에는 그
사전 지식에 바탕을 두고 결정 함수를 결정할 수 있다. 패턴에 대한 정성적 (qualitative)
지식만을 사용할 수 있는 경우에는 결정 함수의 형태를 합리적으로 추측할 수 있다.
이 경우, 결정 경계는 정확하지 않을 수 있으므로 일련의 조정을 통해서 만족스러운
성능을 얻도록 인식기를 설계할 필요가 있다. 일반적인 상황에서는 인식할 패턴에
관한 사전 지식이 거의 존재하지 않는다. 이러한 환경하에서는 훈련 (training) 또는
학습 (learning) 절차를 사용하여 패턴 인식기를 설계할 수 있다. 먼저 임의의 결정
함수를 가정하고, 일련의 반복 훈련 과정을 통하여 이들 함수가 최적 또는 만족스러운
형태에 접근하도록 수정된다. 결정 함수에 의한 패턴 분류는 다양한 방법으로 접근될
수 있다. 이 책에서는 결정 함수를 생성하기 위한 여러 종류의 결정론적 및 통계적
알고리즘을 소개한다.
일반적으로, 전처리 및 특징 추출의 문제와 최적의 결정 및 분류의 문제를 해결하기 위해서는 매개변수 집합을 추정한 후에 이를 최적화시켜야 한다. 즉, 매개변수 추정의 문제를 야기시킨다. 더우기, 패턴의 문맥 정보 (contextual information) 를 사용하여 특징 추출 과정과 의사 결정 과정을 대폭 개선시킬 수 있다. 문맥 정보는 존재 가능한 확률, 언어적 통계, 이웃의 변화량 등을 통하여 측정될 수 있다. 어떤 응용에서는, 정확한 인식 결과를 얻기 위하여 문맥 정보가 필수불가결 하기도 하다. 예를 들어, 음성의 파형 정보를 보충해 주는 문맥 및 언어학적 정보가 존재할 경우에만 완전한 자동적 음성 인식이 가능하다. 마찬가지 방법으로, 흘려쓴 필기체 문자를 인식하고 지문을 분류할 경우에도 문맥 정보가 매우 유용하다. 왜곡을 극복할 수 있고, 편차가 큰 패턴에도 융통성이 있으며 스스로 조정할 수 있는 패턴 인식 시스템을 설계할 때 적응 문제에 직면하게 된다.
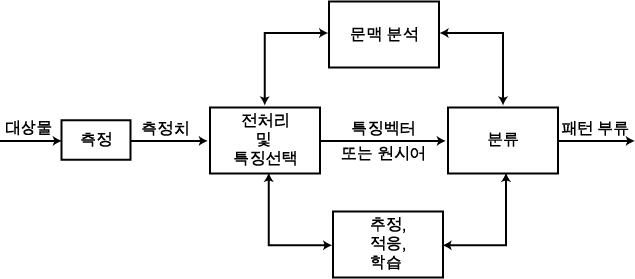
그림 6 적응적 패턴 인식 시스템의 기능적 블럭 구조도
적응적 패턴 인식 시스템을 개념적으로 설명하기 위하여, 그림 6 과 같은 기능적 블럭 구조도를 통하여 패턴 인식에 관련된 주요 문제를 간략하게 설명한다. 이 그림은 패턴 인식 시스템이 수행하는 기능을 자연스럽고 편리하게 나누어 놓은 것이다. 여기서, 기능적 블럭은 분석에 편리하도록 구성하였을 뿐, 블럭 같에 상호작용하는 연산을 구별하기 위하여 구성한 것은 아니다. 최적 결정과 전처리 또는 특징 추출을 반드시 구별할 필요는 없지만, 기능적 분석 개념은 패턴 인식 문제에 대한 명쾌한 이해가 가능하도록 해 준다.
자동적 패턴 인식 시스템으로 인식 및 분류해야 할 패턴은 반드시 측정 가능한 특성들의 집합을 포함하고 있어야 한다. 이러한 측정치가 패턴 집단내에서 서로 유사하면 같은 패턴 부류의 구성원으로 간주한다. 패턴 인식 시스템의 목적은 관측된 정보에 바탕을 두고 측정된 데이타와 유사한 측정치를 생성할 수 있는 패턴 부류를 결정하는 것이다. 측정치에 포함되어 있는 구별되는 정보의 양과 이러한 정보를 얼마나 효율적으로 활용하느냐에 따라 인식의 정확도가 결정된다. 사용할 수 있는 특성을 모두 측정할 수 있고 측정된 정보를 처리할 때 시간상의 제약을 받지 않는다면, 주먹구구식 (brute-force) 방법을 통하여 정확한 패턴 인식 결과를 얻을 수 있다. 그러나, 통상적으로 시간, 공간 및 비용 면에서의 제약이 있으므로, 실용적인 접근방법을 개발해야 할 필요가 있다.
자동적 패턴 인식의 설계 개념은 패턴 부류를 특징지우고 정의하는 방법에서 비롯된다. 경험을 통하여 여러가지 기본적인 가능성이 제시되었다. 어떤 패턴 부류를 그 부류의 구성원에 대한 명부로 특징지울 수 있을 때, 패턴 인식 시스템을 설계하기 위한 방법으로 구성원 명부 (membership-roster) 개념을 사용할 수 있다. 어떤 패턴 부류를 그의 모든 구성원이 공유하는 공통의 특성으로 특징지울 수 있으면, 패턴 인식 시스템을 설계하기 위한 방법으로 공통 특성 개념을 사용할 수 있다. 어떤 패턴 부류가 패턴 공간상에서 군집화 (clustering) 특성을 보이면, 군집화 개념을 바탕으로 패턴 인식 시스템을 설계할 수 있다. 이들 세가지의 기본적인 설계 개념은 다음과 같다.
구성원들의 명부로 하나의 패턴 부류를 특징지우는 것은 원형 정합 (template matching) 에 의해 자동적 패턴 인식을 가능하게 해준다. 같은 패턴 부류에 속하는 패턴들의 집합을 패턴 인식 시스템내에 저장한다. 미지의 입력 패턴이 시스템에 주어질 때, 저장되어 있는 패턴들과 하나씩 비교해 본다. 입력 패턴이 그 패턴 부류에 속하는 저장된 패턴들 중의 하나와 정합되면 패턴 인식 시스템은 입력 패턴을 그 패턴 부류의 구성요소로 분류한다. 예를 들어, 서로 다른 활자체로 구성된 문자들이 패턴 인식 시스템에 모두 저장되어 있다면, 그들이 희미해 졌거나, 질이 좋지 않은 잉크로 쓰여졌거나, 침투성이 있는 종이에 쓰여졌거나 또는 그와 유사한 것으로 인한 잡영으로 왜곡되지 않는 한은 구성원 명부 접근방식으로 인식할 수 있다. 이러한 단순한 개념으로 어떤 응용에서의 목적을 만족시키는 경제적인 인식 구조를 설계할 수 있다. 구성원 명부 접근방법은 거의 완벽한 패턴 표본을 사용하는 조건하에서라면, 완벽하게 패턴 부류를 분류해 낼 것이다.
모든 구성요소가 가지고 있는 공통 특성으로 패턴 부류를 분류하는 것은 유사 특징을 찾아내어 처리하는 자동적 패턴 인식을 가능하게 해준다. 이 방법의 기본적인 가정은 같은 부류에 속하는 패턴들이 유사성을 나타내는 어떤 공통 특성 또는 속성을 가진다는 것이다. 예를 들어, 공통 특성을 패턴 인식 시스템내에서 저장한 후 새로운 패턴을 받아들여 유사한 특징을 가진 패턴 부류로 분류한다. 그러므로, 이 방법에서의 주요 문제는 유한한 표본 패턴 집합으로 부터 공통 특성을 결정하는 것이다.
이 개념은 구성원 명부 접근방법에 비하여 여러 관점에서 우수하다. 하나의 패턴 부류에 대한 특징들을 저장할 때 필요한 기억 공간이 그 부류에 속하는 모든 패턴들에 대한 특징을 저장할 때 필요한 기억 공간 보다도 훨씬 작다. 하나의 패턴 부류에 있어서 특징은 변하지 않으므로, 특징을 비교함으로써 개개의 패턴에 대한 변형을 허용할 수 있다. 반면에, 원형 정합에서는 심한 패턴의 변형은 허용되지 않는다. 만약 표본 패턴으로부터 한 부류에 대한 모든 특징을 결정할 수 있다면, 인식 과정은 단순히 특징 정합 (feature matching) 으로 축소될 수 있다. 그러나, 앞서 언급하였듯이 한 부류에 대하여 구별력있는 특징의 완전한 집합을 찾는 것은 불가능하거나 매우 어려우므로, 이 개념을 적용하기 위해서는 최적의 특징을 선택하는 기법을 개발할 필요가 있다. 특징 선택을 위한 여러가지 방법을 제 II 권의 5 장에서 소개한다. 공통 특징 개념은 정규 언어 이론에 의한 패턴 인식에서도 기본이 된다.
(3) 군집화 개념
임의의 부류에 속하는 패턴의 구성요소가 실수로 구성된 벡터일 때, 패턴 부류는 패턴 공간상에서의 군집화 특성으로 특징지울 수 있다. 이러한 일반적인 개념에 기초한 패턴 인식 시스템의 설계에서, 다양한 패턴 군집을 상대적인 기하학적 배열 형태로 나타낼 수 있다. 만일, 군집 간에 멀리 떨어져 위치하는 특성을 바탕으로 부류를 특징 지울 수 있으면, 최소 거리 분류기와 같은 간단한 인식 구조를 사용할 수 있다. 그러나, 군집이 중첩될 때는 패턴 공간을 분할하는 기법을 사용해야 한다. 군집이 중첩되는 현상은 대부분 관측된 정보가 부족하거나 잡영으로 인하여 나타난다. 따라서, 한 부류의 패턴에 대하여 계산된 측정치의 양과 질을 증가시킴으로써 중첩되는 정도를 최소화할 수 있다.
패턴 인식 시스템을 설계할 때, 사용가능한 정보를 최대한 이용하는 것은 의미있고 중요한 일이다. 직관적으로 보더라도, 좋은 성능을 얻기 위해서 사전 정보 (a priori information) 를 이용하는 것이 바람직하다. 따라서 패턴 인식 시스템의 설계자에게 소속 부류가 알려진 일부 표본 패턴들과 같은 사전 정보가 주어져 있다고 가정한다. 사실, 이런 사전 정보 없이 패턴 인식 시스템을 설계하는 것은 어리석은 일이다.
각 패턴의 속성이나 부류 또는 구조를 알고 있는 전형적인 패턴 집합은 "훈련 집합" 이라 불리우는 데이타베이스를 구성한다. 일반적인 의미에서, 훈련 집합은 입력 데이타를 출력 결정 (즉, 분류 또는 구조적 묘사) 과 연관지우는 데 필요한 의미있는 정보를 제공해 준다. 훈련은 종종 학습과 연관되거나 같은 것으로 간주된다. 훈련 집합은 인식 시스템으로 하여금 통계적인 매개변수, 주요 특징 또는 기본 구조 등과 같은 적절한 정보를 학습시킬 때 사용된다. 구문론적 패턴 인식에서도 문법을 학습시키거나 추론하기 위하여 훈련 표본을 사용할 수 있다.
인공 지능 영역에서의 학습은 좀 더 일반적인 함축된
의미를 갖는데, 이것은 사람에게서 볼 수 있는 자기 적응 (self-adaptation) 과정과
유사하다. 학습 시스템은 이전의 정량화된 성능을 근거로, 더 좋은 반응을 얻기 위하여
자신의 내부 구조를 적용시킬 수 있다. 시스템의 성능은 기대되는 시스템 출력과
실제 시스템 출력 간의 차이로 평가할 수 있다. 이러한 일반적인 학습 개념은 통계적
패턴 인식에서의 선형 결정함수나 신경망을 이용한 패턴 인식에서의 일반화된 델타
규칙을 전개할 때 사용된 오차 교정에 바탕을 둔 패턴 인식 기법과 관련된다. 이들
두 기법은 전형적인 기울기 강하 (gradient descent) 기법으로서, 각각의 실험 또는
반복 결과에 따라 인식 시스템을 수정한다. 이것은 생물학적 실험에서의 전형적인
학습 곡선 (learning curve) 반응에서 유도되었다. 학습 실험을 n 번째 시도할 때,
사람 또는 동물이 정확한 반응을 보이게 될 확률이  이라면, 이 반응을 예측하기 위한 전형적인 공식은 다음과 같다.
 (2)
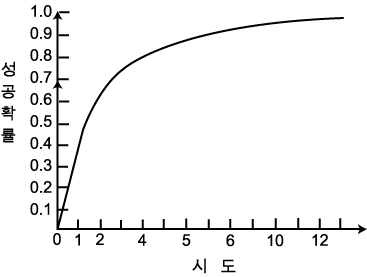
그림 7 전형적인 학습 곡선
여기서,  는 학습 매개변수를 나타낸다. 그림 7 에서는 전형적인 학습 곡선을 보여준다.
불행하게도, 실제 패턴 인식 시스템에서 그림에서와 같이 단조 증가하는 학습 성능을
얻기란 쉽지 않다. 훈련은 실제 응용에서 볼 수 있는 패턴 유형중에서 대표적인 (그리고
보통 부류 표시가 되어있는) 표본을 사용한다. 훈련 집합은
 또는
 로 표기한다. 여기서, 첨자
 는 특정 패턴 부류의 훈련 집합을 나타낸다. 지도
학습 (supervised learning) 은 패턴 부류에 관한 부류 표시가 되어 있는 훈련 집합을
사용하는 반면에, 자율 학습 (unsupervised learning) 에서는 훈련 집합 요소들이
부류 표시를 가지고 있지 않고, 시스템이 표본 데이타의 "자연스러운"
분할 영역을 결정하게 된다.
부류 표시 분할 영역이  이고 부류 표시가 되어있는 훈련 집합
 이 주어졌다고 가정하자.
 에 관한 부류 표시가
 이면, 표본
 는 분할 영역
 에 배정된다.
 의 모든 요소를 정확하게 분류하기 위하여 (또는 H 의 모든 요소를 정확히 분류할
수 있는 결정 영역을 생성하기 위하여) 선형 기계라 부르기도 하는 선형 결정 함수
집합을 사용할 수 있다면, 이는 선형으로 분리가능한 문제라 할 수 있다. 다시 말해서,
 를 선형으로 분리할 수 있으면,
 의 분할 영역들 즉,
 는 쌍으로 선형 분리할 수 있다 (pairwise linearly separable) [Nilss65].
패턴 인식은 여러가지 형태로 응용된다. 어떤 예에서는, 패턴의 생성을 위한 내재되어 있으면서 정량화된 통계적인 바탕이 존재한다. 또 다른 예에서는, 패턴에 내재된 구조가 인식에 기본적인 정보를 제공해 주기도 한다. 그 외의 예에서는 위의 두가지 경우 중 어느 것도 성립되지 못하므로 입력 패턴이 기대되는 응답으로 정확하게 연관되도록 시스템의 구조를 개발하거나 학습시킬 수 있다. 따라서, 어떤 주어진 문제에 대하여 하나 이상의 서로 다른 접근방법으로 그 문제에 대한 해를 구할 수 있다. 어떤 문제를 해결하고자 할 때, 지침이 될 수 있는 원칙 중의 하나는 "그 일에 가장 적합한 도구를 사용하라" 는 것이다.
자동적 패턴 인식의 예는 다방면에 걸쳐 풍부하게 존재한다. 인쇄되거나 타이핑된 문자들을 읽거나, 심전도와 뇌파를 촬영하거나, 발음된 단어를 인식하거나, 지문을 구별하거나 사진을 해석하는 인식기를 설계 또는 제작하려는 시도가 성공리에 이루어져 왔다. 이 외에도 필기체 문자나 단어의 인식, 의료 진단, 지진파의 분류, 목표 감지, 일기 예보, 기계 장치 및 제조 과정의 고장 및 결함을 구별하는 등의 많은 응용 분야가 있다. 본 절에서는 세가지 관점에서의 패턴 인식 접근방법에 대하여 간략히 소개하고 이들 패턴 인식 개념이 성공리에 응용되고 있는 분야에 대한 응용 예를 알아 본다.
통계적 패턴 인식은 통계적인 가정에 바탕을 두고 분류 업무를 수행한다. 입력 데이타로부터 추출된 특징 값은 각각의 특징 벡터를 c 개의 부류들 중의 하나로 배정하는데 사용된다. 자연 상태에서 특징을 추출한 것으로 가정하면, 바탕이 되는 모델은 자연 상태 또는 확률 (확률 밀도 함수) 의 부류 조건부 집합 (class-conditioned set) 중의 하나가 된다.
예제 :
원격 탐사된 영상 데이타에 통계적 패턴 인식을
적용한 기본적인 예로, 지구 자원 탐사 위성으로 부터 촬영된 영상의 특징이나
토지의 유형 등을 결정하는 문제를 들 수 있다. 지구 궤도내에 있는 위성에 장착된
센서는 영상 데이타를 수집하는 가장 중요한 장치 중의 하나이다. 획득된 지구
영상은 스펙트럼 형태로 분포될 수 있으며, 군사, 경제 및 인도주의적인 면에서의
여러 응용에 필요한 정보를 포함하고 있다. 예를 들어, 광물질이 매장된 지역을
식별하거나, 특수 농작물을 재배하는 지역을 분류할 수 있다. 지구를 원격 탐사하는
일련의 위성을 사용한 지구 자원 탐사 계획이 1972 년 부터 시작되어 활발히
진행되어 왔다. 이 연구에서는 지구 자원 탐사 위성에 다중 스펙트럼 스캐너
시스템을 장착시켜 지구 자원 영상내에 모든 화소에 대하여 각각 하나의 특징
벡터를 생성시킨다. 이 때, 특징 벡터의  번째 구성 요소는 해당 화소 위치에서의
특정 스펙트럼의 명암 반응을 나타낸다. 예를 들어, 표 2 는 초기 세대의 지구
자원 센서에 대한 스펙트럼 매개변수를 보여준다.
표 2 영상의 특징에 대한 지구 자원 스펙트럼 매개변수
|
분류 업무 |
입력 데이타 |
출력 응답 |
|
|
0.50 - 0.60 μm 0.60 - 0.70 μm 0.70 - 0.80 μm 0.80 - 1.10 μm |
눈으로 볼 수 있음 눈으로 볼 수 있음 결정불가능한 영역 결정불가능한 영역 |
지구 자원 데이타를 응용한 예로, 토지 분류나 지도 제작을 들 수 있다. 영상화된 토지의 형태 (즉, 모래, 나무, 산, 그리고 물) 를 나타내는 지도의 제작이 가능하다. 이러한 형태의 토지에 대해서 서로 다른 스펙트럼 반응 (즉, 표 2 에 보인 스펙트럼에서 모래의 반응은 물의 반응과 다르다.) 을 얻을 수 있으므로 부류에 대한 특정한 모델을 가정하고 그 모델을 학습시킴으로써 인식 시스템이 각 화소를 이들 영역 중의 하나로 분류한다. 지구 자원 영상 데이타에 대하여 이들 네개의 특징 만을 사용하여 실험하면, 약 17 % 의 분류 오류가 발생한다. 이것은 스펙트럼 특징 만을 고려한 결과이므로 공간적 또는 시간적 특징과 같은 또 다른 특징을 추출하여 사용하면 오류율을 더 줄일 수 있다. 지구 자원 데이타의 분류에 사용된 공간적 특징 이외에 일반적인 영상 분할에 사용되는 특징으로는 구조, 배경, 모양 및 구조적 관계성 등을 들 수 있다. 분류의 정확도를 증가시키기 위해서는 일반적인 분류 절차 이외의 추가적인 계산이 필요하다.
한 패턴에 대한 의미있는 정보로 특징의 유무 또는 수치를 만들 수 있지만, 특징간의 상호 관련성 또는 상호 연결성 정보와 같은 중요한 구조적 정보도 만들 수 있다. 이러한 구조적 정보는 구조적 묘사 또는 분류를 쉽게 해준다. 이것이 바로 구문론적 (또는 구조적) 패턴 인식의 기본이다. 그러나, 구문론적 접근방법을 사용하기 위해서는 구조적 정보를 정량화하여 추출할 수 있어야 하며 패턴의 구조적 유사성을 평가할 수 있어야 한다. 구문론적 접근방법은 패턴의 구조를 정규 언어의 구문 (syntax) 으로 연관시키는 것이다. 전형적으로, 구문론적 패턴 인식 접근방법은 간단한 부분 패턴으로 구성된 복잡한 패턴을 계층적으로 묘사한다. 가장 하위 계층에서는 입력 데이타로 부터 원시어 (primitive) 요소를 추출한다. 구문론적 패턴 인식의 구별되는 특성은 원시어의 선택과 관련이 있다. 원시어는 부분 패턴 즉, 건축물에서의 벽돌에 해당하는 반면에, 특징은 이에 대한 임의의 측정치이다.
예제 :
문자 a, b, 또는 c 로 구성된 문자열 입력 패턴이 주어졌다고 가정하자. 이 문자열은 심전도 파형 또는 음성 신호에서와 같이 원래의 입력 패턴을 전처리한 결과에 따라 만들어질 수 있다. 두가지의 특성 상태로 두 부류의 패턴을 생성하는데, 각각은 그 구조에 의하여 특징지워진다. 이러한 표본들이 표 3 에 나타나 있다.
표 3 전형적인 패턴 (문자열)
|
부류 1 |
부류 2 |
|
ac abc abbc abbbc |
bc abc aabc aaabc |
부류 1 에 속하는 패턴은  와 같은 형태를 취하는 반면에, 부류 2 에 속하는 패턴은
 와 같은 형태로 또는 구조를 취한다. 더우기, 두 부류 모두에 속하는 여러개의
패턴들이 생성될 수도 있다. "aaabbc" 와 같은 패턴이 주어질 경우,
구문론적 패턴 인식을 분류 업무에 적용할 때의 목표는 과연 어떤 부류가 이
패턴을 생성하였는 가를 결정하는 것이다.
현대의 컴퓨터는 생물계의 계산 방식을 흉내내지 않는다. 생물의 신경계가 정보를 어떻게 저장하고 다루는 가에 관한 지식을 이용하려는 시도로 부터 또 다른 방법인 신경적 계산 방식이 부상하게 되었고, 신경망이라 불리우는 인공 신경계의 연구 분야를 이끌어 냈다. 이러한 연구는 심리학, 신경 과학, 인지학 및 시스템 이론과 같은 매우 다양한 분야의 연구를 혼합한 것으로 최근에 새롭게 상당한 주목을 받고 있다.
신경망은 비교적 새로운 계산 방식이다. 전통적인 계산 방식에 대한 신경망의 장점, 단점, 응용, 그리고 관련성이 완벽히 이해되지 않은 상태에 있으므로, 신경망 영역에 대한 기대는 매우 높다. 신경망은 패턴 연상 (pattern association) 에의 응용에 특히 적합하다. 자동화된 추론 또는 패턴 인식에 관한 모든 문제를 인공 신경망 (artificial neural network) 으로 해결할 수 있다고는 생각되지 않는다. 이 책에서는 패턴 인식 시스템을 구현하기 위한 방법으로 신경망을 고려한다.
통계적 패턴 인식, 구문론적 패턴 인식, 그리고 신경망을 이용한 패턴 인식을 명확하게 구별하기란 쉽지 않다. 특정한 패턴 인식 문제가 주어질 때, 학습 능력의 적합성 뿐 만 아니라 문제에 내재되어 있는 통계적 요소나 문법적 구조의 분석을 바탕으로 하여, 통계적 패턴 인식, 구문론적 패턴 인식, 그리고 신경망을 이용한 패턴 인식 등 여러 접근방법 중의 하나를 선택할 수 있다.
통계적 패턴 인식 또는 결정 이론적 접근방법에서는 패턴의 구조가 그리 중요하지 않다. 그러나, 그 구조는 적절한 특징 선택에 의해 영향받을 수 있다. 즉, 이진 특징 벡터는 관측된 관계의 유무를 나타낼 수 있다. 마찬가지로, 어떤 경우에는 신경망을 이용한 패턴 인식 접근방법이 통계적 패턴 인식 및 구문론적 패턴 인식 접근방법으로 부터 유래된 것으로 볼 수 있다. 패턴에 관한 명시적인 구조적 정보를 사용할 수 있을 때는 구문론적 패턴 인식을 선택하는 것이 의미가 있다. 반면에, 이러한 구조적 정보를 사용할 수 없을 때는 통계적인 패턴 인식을 사용할 수 있다. 패턴 인식을 적용할 많은 실제적인 문제들이 이들 두 극단 간에 놓이게 된다. 예를 들어, 속성 문법 (attributed grammar) [Tsai80] 은 통계적인 접근방법과 구문론적인 접근방법을 서로 결합시켜 주는 방법을 제공한다.
신경망을 이용한 패턴 분류는 급 부상하는 연구 영역으로 그의 기원은 약 30 년 전으로 거슬러 올라간다. 패턴 인식 (또는 계산) 에서, 신경망을 이용한 패턴 인식을 새로운 개념으로 보아야 할 지, 아니면 단순히 통계적 또는 구조적 접근방법의 구현을 위한 또 다른 기법으로 보아야 할 지는 아직 명확하지 않다. 표 4 에 서로 다른 패턴 인식 접근방법을 요약하였다.
표 4 통계적, 구문론적, 신경망을 이용한 패턴 인식 접근방법의 비교
|
|
통계적 패턴인식 |
구문론적 패턴인식 |
신경망을 이용한 패턴인식 |
|
1. 패턴 생성 (저장) |
확률 모델 |
정규 문법 |
안정 상태 또는 가중치 배열 |
|
2. 패턴 분류 (인식) |
추정/결정 이론 |
파싱 |
신경망의 (예측가능한) 특성에 기반 |
|
3. 특징 구성 |
특징 벡터 |
원시어 및 관측된 관계 |
신경 입력 또는 저장된 상태 |
|
4. 학습 방법
|
밀도/분포 추정 (모수적) 군집화 |
문법을 구성 (문법 추론) 군집화 |
신경망 시스템의 매개변수 결정 군집화 |
|
5. 제약 |
구조 정보의 표현이 어려움 |
구조 규칙의 학습이 어려움 |
네트워크로 부터 의미 정보를 거의 얻을 수 없음 |
그림 8 에서는 간단한 문자 인식 문제를 보여주는데, 여기에는 다양한 패턴 인식 접근방법이 사용될 수 있다. 그림에 나타난 바와 같이, 이 접근방법은 아주 적은 특징을 추출하는 것에서 부터 복잡한 원시어를 추출하는 것에 이르기까지 광범위하며 공간적인 관계를 수반한다. 그림 9 는 모델에 바탕을 둔 패턴 생성과 분류를 위한 그 역과정의 관점에서 통계적 패턴 인식 접근방법과 구문론적 패턴 인식 접근방법의 관계를 설명해 준다.

그림 8 패턴 인식 접근방법의 예
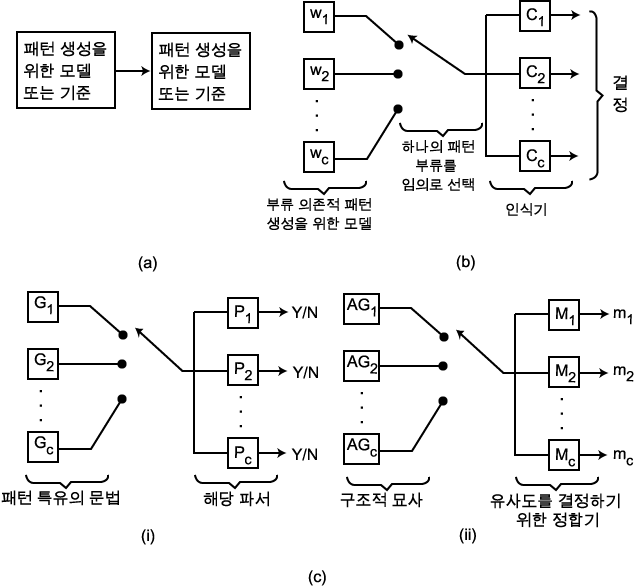
그림 9 모델 기반 패턴 인식에서 통계적
패턴 인식과 구문론적 패턴 인식의 관계 ;
(a) 전체 구조, (b) 통계적 패턴 인식의
예, (c) 구문론적 패턴 인식의 예 ;
(i) 문법적 접근방법, (ii) 속성 그래프 접근방법
실제의 응용에서, 자동적 패턴 인식 시스템을 설계하는 것은 복잡하고 반복적이며 많은 상호작용을 필요로 한다. 이러한 모든 것을 포함하는 것이 불가능하긴 하지만, 밀접하게 상호 관련되고 근간이 될 수 있는 단계들을 소개한다.
단계 1. 특징을 찾기 위하여 고려중인 패턴 부류들을 조사한다. 즉, 부류 내부 및 부류 간의 유사도 또는 비유사도 뿐 만 아니라 정량화할 수 있는 패턴 구조 및 확률적으로 특징지울 수 있는 가를 조사한다. 덧붙여, 패턴의 변형 가능성이나 불변 특성, 그리고 잡음 근원의 묘사 등을 이 시점에서 고려한다.
단계 2. 특징 또는 측정 데이타를 사용할 수 있는가를 결정한다.
단계 3. 시스템의 기대 성능 및 계산 자원에 관한 제약 조건 (즉, 처리 속도나 인식 성능 등) 을 고려한다.
단계 4. 훈련 데이타의 사용가능성을 고려한다.
단계 5. 적절하고 잘 알려진 패턴 인식 기법 (즉, 통계적 패턴 인식, 구문론적 패턴 인식, 군집화 등) 의 사용 가능 여부를 고려한다.
단계 6. 패턴 인식 시스템을 시뮬레이션한다. 이 실험을 통하여 모델, 문법, 네트워크의 구조 등을 선택한다.
단계 7. 시스템을 훈련시킨다.
단계 8. 시스템의 성능을 시뮬레이션한다.
단계 9. 기대 성능을 얻을 때 까지 위의 단계들 중에서 필요한 부분을 반복한다.
자동적 패턴 인식을 위한 간단한 수학적 모델을
통해 패턴 인식의 기본 개념을 알아 보자. 패턴 인식을 위한 간단한 구조는 두 개의
구성요소인 특징 추출기와 분류기로 구성된다. 특징 추출기는 인식할 패턴을 패턴
벡터  으로 변환시켜 주는 장치이다. 분류기는 일련의 결정 함수를 계산함으로써 각각의
입력을 유한한 갯수로 구성된 부류 중의 하나로 배정해 주는 장치이다. 오류는 패턴
부류
 에 속하지 않는 패턴을 패턴 부류
 에 배정할 때 발생한다. 패턴 분류기
 이 패턴 분류기
 가 범하게 될 오류 확률보다 더 적은 오류를 범하게 될 확률을 가질 때, 패턴
분류기
 은 패턴 분류기
 보다 더 우수하다고 말한다. 특징 추출기의 출력은
 으로, 이것은 실제 패턴에 대한 n 개의 측정값을 나타낸다. 측정된 벡터는 x
는 M 개의 패턴 부류
 중의 하나에 속하는 것으로 가정하고, 각 부류가 발생할 사전 확률이 같다고
가정한다. 즉 x 가 나타나게 될 확률이 모든 부류에 대해 동일하다.
 를 x 의 확률 밀도 함수라고 할 때, x 가 부류
 로 부터 주어졌다고 가정할 경우, 측정된 벡터 x 가 실제로 부류
 로 부터 나타날 확률은 다음과 같이 주어진다.

따라서, x 가 부류  로 부터 나타나지 않을 확률, 즉 오류 확률은 다음과 같다.

이면, 최적의 결정 함수  로, 오류 확률이 x 의 각기 가능한 값들에 대하여 가장 작은 경우이다.
 를 가장 작게 하는
 의 값은
 를 가장 크게 한다. 따라서,
 또는
 , 모든
 에 대하여
이면, 최적의 결정 함수  는 x 를 부류
 에 배정한다.
 인 모든
 에 대하여,
 이고
 일 때 최적의 결정 함수
 는 x 를 부류
 나
 에 배정할 수 있다. 주어진 x 의 값에 대하여, 분류기는 최적의 결정 함수를
결정하게 된다. 이제, 측정된 값이 다음과 같은 공분산 행렬 (covariance matrix)
로 정규 분포되어 있다고 가정하자.

여기서,  는 측정 벡터 x 의
 번째 및
 번째 구성요소 간의 공분산이고
 는 x 의
 번째 구성요소의 분산이다.
 가 평균 벡터 (mean vector) 일 때, 정규 확률 밀도
 는

이므로, 두개의 조건부 확률 밀도  와
 의 비율은 다음과 같다.

공분산 행렬은 대칭이므로 이 조건부 확률의 비율은 다음과 같이 간단하게 정리할 수 있다.

 를 다음과 같이 정의하면,

다음과 같은 인식 함수를 얻게 된다.

최적의 인식 함수는  인 모든
 와
 에 대하여,
 개로 구성된
 의 값들 중에서 가장 큰 것을 선택함으로써 결정된다.
 가 가장 크면 x 는 부류
 에 속한다고 말한다. 이와 같은 분석에 바탕을 둔 최적의 인식 구조가 그림 10
에 나타나 있다.
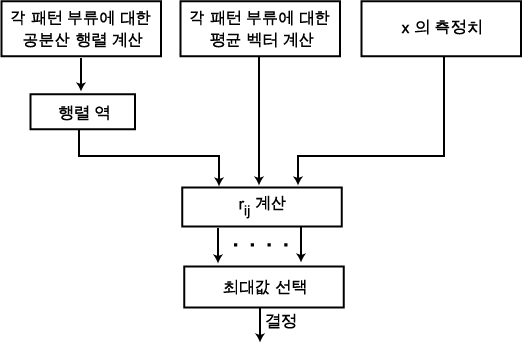
그림 10 간단한 인식 구조

이 식은 두 부류의 경우인
 일 경우
그리고
 일 경우
에 대하여 공간을 두 부분으로 나누는 n 차 공간
상의 초-평면을 나타내 준다. 그러므로,  은
 번째와
 번째 부류 간의 결정 경계를 형성한다. 다음 장에서 결정 함수와 결정 경계에
대해 포괄적으로 설명한다.
8. 패턴 인식 관련 문헌
본 절에서는 패턴 인식 분야를 발전시키는데 많은 기여를 하고 있는 국내외의 저명한 학술지 및 학술 회의 그리고 전문 서적들을 소개한다.
- 일본전자정보통신학회 논문지 (1947 ~ )
- 일본 정보처리학회 논문지 (1960 ~ )
- 대한전자공학회 논문지 (1964 ~ )
- Pattern Recognition Journal (1968 ~ )
- IEEE Trans. on Systems, Man and Cybernetics (1971 ~ )
- 한국정보과학회 논문지 (1973 ~ )
- IEEE Trans. on Pattern Analysis and Machine Intelligence (1979 ~ )
- Pattern Recognition Letters (1982 ~ )
- International Journal of Computer Processing of Chinese and Oriental Languages (1983 ~ )
- International Journal of Pattern Recognition and Artificial Intelligence (1987 ~ )
- 한국인지과학회 논문지 (1989 ~ )
- IEEE Trans. on Neural Networks (1990 ~ )
- Neural Networks Journal (1988 ~ )
- International (Joint) Conference on Pattern Recognition (1973 ~ )
- International Conference on Pattern Recognition and Image Processing (1977 ~ 1982)
- International Graphonomics Society Conference on Handwriting (1981 ~ )
- International Conference on Computer Vision and Pattern Recognition (1983 ~ )
- International Conference on Computer Vision and Pattern Recognition (1987 ~ )
- International Workshop on Structural and Syntactic Pattern Recognition (1988 ~ )
- International Conference on Document Analysis and Recognition (1991 ~ )
- Annual Symposium on Document Analysis and Information Retrieval (1992 ~ )
- 국내 문자 인식 워크샵 (1993 ~ )
- International Workshop on Document Analysis Systems (1994 ~ )
- International Joint Conference on Neural Networks (1988 ~ )
- T. Sakai and M. Nagao, Characters and Figures Recognition Machine, Kyoritsu, Tokyo, 1967 (In Japanese).
- K. S. Fu, Sequential Methods in Pattern Recognition and Machine Learning, Academic Press, 1968.
- S. Watanabe (Ed.), Methodologies of Pattern Recognition, Academic Press, 1969.
- K. S. Fu, Pattern Recognition and Machine Learning, Plenum Press, 1971.
- K. Fukunaga, Introduction to Statistical Pattern Recognition, Plenum Press, 1971.
- C. H. Chen, Statistical Pattern Recognition, Hayden, 1973.
- R. O. Duda and P. E. Hart, Pattern Classification and Scene Analysis, Wiley-Interscience, 1973.
- J. T. Tou and R. C. Gonzalez, Pattern Recognition Principles, Addison-Wesley, 1974.
- K. S. Fu, Syntactic Methods in Pattern Recognition, Academic Press, 1974.
- C. H. Chen (Ed.), Pattern Recognition and Artificial Intelligence, Academic Press, 1976.
- K. S. Fu, Syntactic Methods in Pattern Recognition, Academic Press, 1974.
- K. S. Fu (Ed.), Digital Pattern Recognition, Springer Verlag, 1976.
- A. K. Agarwala (Ed.), Machine Recognition of Patterns, IEEE Press, 1977.
- K. S. Fu (Ed.), Syntactic Pattern Recognition, Applications, Springer Verlag, 1977.
- T. Pavlidis, Structural Pattern Recognition, Springer Verlag, 1977.
- Y. T. Chien, Interactive Pattern Recognition, Dekker, 1978.
- K. S. Fu (Ed.), Application of Pattern Recognition, CRC Press, 1982.
- K. S. Fu (Ed.), Syntactic Pattern Recognition and Applications, Prentice-Hall, 1982.
- J. Kittler, K. S. Fu and L. F. Pau (Eds.), Pattern Recognition Theory and Applications, D. Reidel Publishing, 1982.
- S. Mori, Fundamentals of Characters and Figures Recognition Techniques, Ohm, Tokyo, 1983 (In Japanese).
- S. T. Bow, Pattern Recognition - Applications to Large-Set Problems, Marcel Dekker, 1984.
- S. N. Srihari (Ed.), Computer Text Recognition and Error Correction, IEEE Computer Society Press, 1984.
- T. Kohonen, Self-Organization and Associative Memory, Springer-Verlag, Berlin, 1984.
- K. S. Fu and T. Y. Young (Eds.), Handbook of Pattern Recognition and Image Procesing, Academic Press, 1985.
- S. Watanabe, Pattern Recognition : Human and Mechanical, Wiley-Interscience, 1985.
- D. E. Rummelhart and J. L. McClelland, Parallel Distributed Processing-Explorations in the Microstructure of Cognition, Vols. I and II, Cambridge, Mass., 1986.
- E. A. Patrick and J. M. Fattu, Artificial Intelligence with Statistical Pattern Recognition, Prentice-Hall, 1986.
- P. A. Devijver and J. Kittler (Eds.), Pattern Recognition Theory and Applications, Springer Verlag, 1986.
- J. A. Anderson and E. Rosenfeld (Eds.), Neurocomputing : Foundations of Research, MIT Press, Cambridge, Mass., 1988.
- 이 영석, 김 인광, OCR 의 기술동향 및 인식기술, 기술정보 시리즈 제 21 호, 산업연구원 1988.
- M. Pavel, Fundamentals of Pattern Recognition, Marcel Dekker, 1989.
- T. Iijima, Theory of Pattern Recognition, Morishita Publishing, 1989 (In Japanese).
- Y. H. Pao, Adaptive Pattern Recognition and Neural Networks, Addison-Wesley, Reading, Mass., 1989.
- S. Mori and T. Sakakura, Fundamentals of Image Recognition, Vols, I and II, Ohm, Tokyo, 1990 (In Japanese).
- T. Khanna, Foundations of Neural Networks, Addison-Wesley, Reading, Mass., 1990.
- 오 영환, 패턴 인식론 : 문자ㆍ음성ㆍ화상, 정익사, 1991.
- S. T. Bow, Pattern Recognition and Image Preprocessing, Marcel Dekker, 1992.
- R. Schalkoff, Pattern Recognition - Statistical, Structural and Neural Approach, John Wiley & Sons, Inc., 1992.
- 이 성환, 문자 인식 : 이론과 실제, 홍릉과학출판사, 1993.


