퍼지이론의 응용분야
알기 쉬운 퍼지 이론 : 무카이노도 마사오 저, 전자신문사, 1991, Page 101~165
퍼지이론은 현재 여러분야에서 응용된다. 그 배경이 되고 있는 생각하는 방법을 중심으로 소개하기로 하겠다. 응용사례는 당초에는 퍼지제어를 중심으로 한 공학적인 분야에 많았지만 의료진단이나 주식투자용 엑스퍼트 시스템 등에서 나타나고 있는 것 같이 서서히 여타과학 분야에도 확산되고 있다.
먼저, 퍼지이론의 응용상 기초가 되고 잇는 퍼지추론의 얘기부터 하기로 한다. 우리가 평상시 생각하고 있는 추론과 컴퓨터나 논리학에서 말하는 추론과는 이미지가 틀린다.
첫째, 논리학에서 말하는 추론에 대해 살펴보자. 학문적인 추론이란 'A 는 B' 며 'A 는 C' 가 된다고 하는 ' ... 라면' 하는 것이 응용되는 삼단논법이란 것이다. 보다 기본적으로는 'A이면 B이다' 라는 전제가 성립해 있을 때 A가 정확하면 B라고 할 수 있으며 역으로 B 가 아닌 것을 알게 되면 A 가 아니라는 결론을 얻을 수가 있다는 것이다. 예를 들면 「부자는 구두쇠다」라는 것을 논리학적으로 말하면 '부자이면 구두쇠다'로 된다. 이것이 진실인지 아닌지는 차치해 두고 이 전제가 가령 진실이라고 하자. 지금 나의 친구 A 씨가 부자였다고 하면 이 전제로부터 곧 'A 씨는 구두쇠다' 라는 결론을 얻을 수 있다. 역으로 B 씨는 구두쇠가 아니었다고 하면 B 씨는 부자가 아니라고 추론할 수가 있다. 단 C 씨가 구두쇠라고 해도 이 전제에서는 C 씨는 부자인지 아닌지는 판단할 수가 없다. 그 반대는 반드시 진리다 라고 할 수 없다는 것이다. 학교에서 주로 배우는 추론은 대체로 이와 같은 것이다.
물론 이들 추론은 일상의 우리들의 추론으로부터 추상화하여 이론화한 것이다. 단 모든 사실은 YES 냐 NO 냐의 하나일 것이라는 二値 논리에 기초를 둔 것이다. 예를 들면 구두쇠가 아니라는 사실로부터 부자가 아니라는 것을 유도해 내는 과정은 다음과 같다.
만약 부자라면 구두쇠일 것이다. 지금 B 씨는 구두쇠가 아니니까 B 씨가 부자이다 라고 가정하면 모순이다. 따라서 부자이다 라는 것이 틀렸다면 부자가 아니다 라는 결론 밖에 유도해 낼 수 없다는 것이다. 여기서는 부자인지 아닌지의 어느 하나이다 라는 二値논리의 원리가 중간의 회색적존재는 인정하지 않는다는 배중률이 지도원리로 되어 있다.
이상의 추론에서는 부자이냐 구두쇠냐 하는 말을 사용하고 있으나 그 의미와는 일체 무관한 것이다. 각각의 것을 A 라든지 B라든지 하는 기호로 바꾸어 놔도 마찬가지이다. 이와 같은 논리학을 기호논리학 이라고 한다. 컴퓨터를 이용한 추론이란 것도 본질적으로는 기호논리학에 있어서의 추론 그 자체이다. 컴퓨터도 二値의 원리로 동작하고 있으며 컴퓨터의 설계는 기호논리학이 응용되어 있다.
'부자는 구두쇠이다.' 라고 하는 명제는 사실인가? 사실이 아닌가? 일상의 우리들의 감각으로는 이와 같은 종류의 명제가 항상 진실이냐의 여부를 가려야 하는 二値논리의 대전제를 받아들이기는 어렵다고 생각된다. 대부분의 명제는 애매한 것이다. 예컨데 진실이었다고 해도 B 씨는 좀 부자이다 라는 사실에서 무엇이 유도될 수 있을까 ?
종래의 컴퓨터에서는 의미를 생각하지 않고 있기 때문에 부자 A 라는 기호를 주었다고 하면 약간 부자는 A 도 A 의 부정도 아니기 때문에 다른 기호, 예를 들면 C 를 붙일 수 밖에 없다. 이렇게 하면 A 라는 기호와 C 라는 기호는 무관하여 컴퓨터를 이용해서 'A 이면 B 이다' 라는 전제와 C 이다 라는 사실에서 어떤 결론도 도출할 수가 없을 것이다.
이처럼 二値논리에 기초한 추론은 진리가 YES 와 NO 의 둘 밖에 없다면 극히 명확하고 확실한 방법이지만 우리들의 일상의 추론에 대한 이미지와는 동떨어져 있다는 것을 알게 된다. YES, NO 만으로는 더구나 의미가 없다.
하나의 예를 더 들어 보자. 미인은 박명하다고 한다. 아름다운 것은 덧없다 는 일반적인 의미로도 받아 들어지며 글자 그대로 미인은 일찍 죽는다는 단명이라고도 해석된다. 그녀는 제법 미인이기 때문에 그다지 오래 살지 못할지도 모른다고 하는 애매한 추론은 우리들의 일상생활에서는 보통의 추론이 된다. 그러나 여기서 나오는 명제 '미인박명' 도 앞에서 소개한 '부자는 구두쇠이다' 라는 것도 다 애매한 사실로써 진실이라고도 거짓이라고도 결정하기 어렵다. 명제 그 자체도 애매하지만 더욱이 그것을 구성하고 있는 언어, 미인 이니 박명이니 하는 것도 애매한 말 즉 퍼지한 말이다. 그리고 주어진 애매한 사실, 약간 부자라느니 제법 미인이라느니 하는 것도 마찬가지로 퍼지한 말이다. 이들을 사용한 애매한 추론은 기계에는 적용하기 곤란한 것이지만 사람에게는 아무렇지도 않게 통용된다.
애매성의 존재를 허락하치 않는 데에 기계의 근본적인 결함이 있다. 한편 인간은 애매성이 존재하는 것이 보통이며 자연스러운 현상이다.
Lofti A.Zadeh 교수도 이와 비슷한 애매한 추론의 예를 들고 있다. '만약 토마토가 붉다면 그 토마토는 잘 익은 것이다' ' 이 토마토는 매우 붉다. 따라서 이 토마토는 매우 잘 익었다' 라는 결론을 얻는 예를 들고 있다. 이것은 앞에서 기술한 것처럼 우리들이 일상에서 보통 행하고 있는 추론이다. 이와 같은 추론을 종래의 二値논리에 기초한 기호논리학으로 설명하는 것은 곤란하다. 전제 자체가 애매하며 동시에 붉다거나 매우 붉다고 하는 말은 퍼지한 의미로 쓰여지고 있기 때문이다.
Zadeh 교수는 이들 언어에 퍼지집합을 적용시켜 그 의미에 상당한 것을 멤버십함수를 사용하여 표현함으로써 컴퓨터로도 이 같은 애매한 추론이 가능하다는 방법을 제안하고 있다. 이것을 특히 퍼지추론이라고 부르고 있다.
여기서 좀 수학적인 문제가 될 지는 모르겠지만 Zadeh 교수에 의해 定式化된 퍼지추론에 대해 간단히 소개해 두겠다.
'미안박명' 을 논리학의 방법으로 표기한다면 '만약 그녀가 미인이라면 그녀는 박명하다' 가 된다. 이것은 퍼지집합을 사용하여 '만약 X 가 F 라면 Y 는 G 이다.' 와 같이 적는다. 이 표현에 대해 약간의 설명이 필요하다.
X 라고 하는 것은 변수로서 어떤 특정한 여성의 집합을 전체집합으로 하여 기호 U 로 나타내기로 한다. 예를 들면 'U = 숙희, 현숙, 선영, 지혜' 와 같은 것이다. X 는 이 중 누군가를 나타내고 있다. 다음으로 F 는 U 의 각자에 대해 미인의 정도에 상당하는 0 과 1 과의 사이의 어느 값을 매기고 있는 멤버십 함수 μF(x) 를 가지고 있다. 즉 F 는 U 의 퍼지집합인 것이다. 숙희양의 美人度 μF(x) 는 0.8 인지 1 인지는 물론 당신의 주관에 의해 자유로이 결정해도 된다.
어쨌든 이와 같은 U 의 각자에게 수치를 주는 관수, 즉 멤버십함수 μF 가 F = 미인이란 퍼지집합의 의미를 나타내고 있다고 생각하는 것이다.
한편, Y 는 그녀가 죽게 될듯한 연령을 나타내는 변수이다. 사람의 수명으로는 통상 0 세에서 100 세 정도까지를 생각해 두면 충분하기 때문에 Y 는 0 과 100 사이의 어떤 값을 취하는 변수이다. Y 가 값으로써 취할 수 있는 전체집합, 이 경우엔 [1,2,3, ... , 100] 을 V 로 나타내기로 한다.
이렇게 하면 G 는 V 상의 퍼지집합으로 박명을 나타내고 있다. G 의 멤버십함수 μG(y) 는 Y 가 V 의 어떤 수명을 취했을 때의 박명, 즉 단명의 정도를 나타내고 있다. 이것도 주관적으로 정하면 되는 것이다.
그럼 다음으로 주어진 사실로써 '그녀는 귀엽다' 를 생각해 보자.
이 주어진 조건하에 'X 는 F 다' 라고 적을 수 있다 .물론 X 는 U 상의 사람을 가리키는 변수로 F' 는 귀엽다에 대응하는 U상의 퍼지집합이다. F' 의 멤버십함수 μF'(x) 도 이미 주어져 있다고 하자. 여기서 주의해야 할 것은 전제조건에서 나타내어진 U 상의 퍼지집합 F = 미인 과 사실에서 주어진 U 상의 퍼지집함 F' = 귀엽다 와는 반드시 일치하지 않아도 된다는 것이다. 퍼지 집합의 특징의 하나는 여기에 있다. 종래의 二値에 기초를 둔 기호논리학에서는 이같은 경우엔 전술한 바와 같이 아무런 답도 유도해 낼 수가 없다.
퍼지 추론은 이와 같이 퍼지집합을 사용한다. 일반적으로는 'X 가 F 라면 Y 는 G 이다.' 라고 하는 것처럼 定式化할 수가 있다. F와 F' 는 같은 전체집합 U 상의 퍼지집합이다. 그런데 이 예에서 F=미인, F' = 귀엽다, G = 박명이다 라고하는 세 개의 퍼지집합이 있을 때 귀여운 여인의 수명에 대해서 무엇이라고 말해야 할 것인가?
이 전제와 사실에서 'Y 는 G 이다.' 라고 하는 결론을 도출하고 싶은 것이다. G' 는 물론 수명의 집합 V 상의 퍼지집합이다. 이 경우에 G' 를 유도하는 방법은 지금까지 몇 가지의 案이 나오고 있다. 그러나 결정적으로 이것이 가장 좋다고 말할 수 있는 것은 없는 것 같다.
Zadeh 교수 자신이 제안한 방법은 먼저 F와 G로부터 U 와 V 와의 어떤 퍼지관계 R을 정의하는 것이다. 이 퍼지관계 R을 써서 주어진 UTKDDML 사실 F' 로부터 V 상의 어떤 사실 G' 를 유도하는 것으로써, 병의 증상으로부터 병명을 추측하는 것과 같다.
지금까지 제안되고 있는 퍼지 추론의 방법은 Zadeh 교수가 제안한 형태의 것이 대부분이지만 F 와 G 로부터 어떤 퍼지관계 R 을 정의하느냐가 다르다. 이 정의에 대해서 여러 가지 案이 있을 수 있다는 것은 애매성의 취급은 이것이다 하고 한마디로 설명되지 않는다는 것을 뜻하며, 특히 취급하고 있는 애매성이나 퍼지니스 중에도 여러 가지 양상이 있어서 각각 적합한 퍼지 추론법이 있을 수 있음을 나타내고 있는 것이다.
단, 귀엽다고 하는 퍼지집합이 미인에 가까운 것이라면 결론 G는 박명에 가까운 것이 될 것이며 귀엽다와 미인이 관계가 없다면 결론은 무엇이라고도 할 수 없으며 미정이라고 하는 것이 정답이 될 것이다.
결론 G'는 이 경우 말이 아닌 퍼지집합의 멤버십함수로 얻어진다.
따라서 최종적으로 언어로 출력하고자 할 경우 얻어진 멤버십함수를 가장 잘 표현하는 언어를 역으로 찾아내지 않으면 안 된다. 이것은 주어진 멤버십을 언어로 近似 표현한다고 하는 흥미있는 문제를 제기하고 있다.
그렇다면 만약 '미인박명이다' 라고 하는 전제 자체가 완전히 진실이 아닌 경우엔 어떻게 하느냐 라는 문제가 남는다. 예를 들어 '거의 진실이다' 라고 한다면, 이것은 '만약 X 가 F 라면 Y 는 G 이다' 라고 하는 것은 '거의 진실이다' 라고 하는 것이 된다. 거의 진실이다라고 하는 언어 眞理値에는 진리치의 집합 0 과 1 사이의 수치상 어떤 퍼지집합 T 가 대응하고 있다. 이 경우의 최종적인 해답은 다음과 같이 얻어진다.
즉, 먼저 앞의 경우와 같이 하여 F 와 G 사이에서 U와 V 와의 사이의 퍼지관계 R을 구한다. 다음에 거의 진실이라고 하는 퍼지집합 T를 사용하여 R을 새로운 퍼지관계 R' 로 변경시킨다. R와 T 사이에서 R'를 구하는 방법도 밝혀져 있으나 여기서는 생략하기로 하겠다. R'가 구해지면 뒤는 마찬가지로 퍼지관계 R' 와 사실 F' 로부터 V 상의 퍼지집합 G' 가 구해진다.
좀 어렵게 되었지만 이상과 같은 방법으로 애매한 결론을 유도해 낼 수가 있다. 이 과정에서 가장 중요한 역할을 하고 있는 것은 퍼지집합과 그 멤버십함수이다. 즉 애매한 전제나 사실은 언어, 다시 말해 퍼지집합을 써서 나타내어진다. 그 언어를 기호 그래도 써서 추론하는 것이 아니라 일단 의미에 상당하는 멤버십함수로 하여 수치로 표현을 변환하는 것이다. 이 멤버십함수를 사용하여 각종 계산을 해서 어떤 멤버십함수로 표현되는 퍼지집합을 얻는 것이다.
이와 같은 순서를 거치면 우리들이 일상 행하고 있는 추론도 컴퓨터에 실행시킬 수가 있게 되는 것이다. 이것은 퍼지집합을 도입한 덕택이다.
앞의 예에서는 미인 박명이니 하는 장난스런 예를 들었지만 이 퍼지추론은 실은 매우 유용한 방법이다. 예를 들면 '비가 내리면 속도를 낮춰라' 라고 하는 단 하나의 명령으로 비가 조금 내리면 속도를 조금 낮추는 것도, 또 비가 많이 내리면 속도를 더 낮추는 것도 가능해지는 것이다. 이것이 퍼지추론의 특징이다.
지금까지의 기호논리에 바탕을 둔 추론으로는 불가능했던 이것은 퍼지추론의 가장 중요한 응용의 하나인 것이다. 퍼지전문가시스템 이나 퍼지제어 등은 이 퍼지추론의 한 응용 사례라고 할 수 있다. 어쨌든 퍼지추론법에 의해 우리들이 일상 말을 사용해서 행하고 있는 추론을 퍼지이론을 응용, 컴퓨터로 실현할 수 있게 되었다.
인공지능, 영어로 AI (Artificial Intelligence) 라고 하는 것으로 지금 이에대한 연구가 활발하다. 우리는 여러 분야에서 인공지능이란 말을 듣는다. 이 말을 인공적으로 인간의 뇌와 유사한 것을 만든다는 것으로 생각하기 쉬우나 사실은 그런 것은 아니다. 인간과 같이 생각할 수 있는 인공 뇌를 만든다는 것은 지금으로서는 전혀 불가능하며 앞으로도 당분간 가능성이 없다. 그렇다면 AI 란 무엇인가? 이것은 지금까지 인간이 우월했던 분야에 컴퓨터를 응용하는 기술이라는 것이 가장 타당한 정의라고 말할 수 있다. 더욱이 인간과 컴퓨터와의 man-machine interface 를 보다 유연하게 하여 컴퓨터가 인간의 보다 지적인 일을 할 때의 파트너가 되도록 하기 위한 응용기술이라고 말할 수 있다.
이와같은 사정을 더 자세히 보기로 한다. 컴퓨터는 수치 계산(계산기라고 불리웠다) 에서 정보처리(정보처리장치라고 불리게 됐다) 로, 그리고 최근에는 지식정보를 취급하게 되어 (AI 시스템이라고 불린다) 점점 고도화해 가고 있다. 또한 컴퓨터는 그 응용범위를 빠른 속도로 넓혀 우리들의 사회생활에도 알게 모르게 깊이 파고 들었다. 더욱이 통신기술 및 데이터베이스 기술과 융합, 고도 정보사회를 주도하며 그 중요성을 더해 가고 있다. 이같은 경향은 앞으로도 당분간 지속될 것이다.
컴퓨터가 부분적이긴 하나 우리들 인간이 知的인 작업이라고 생각해 온 것들을 대신 취급하게 되면 컴퓨터에게 사람처럼 생각하고 추론하는 능력을 부여할 수 없을까 하는 기대를 갖게 되는 것은 하나도 이상하지 않을 것이다. 이것이 AI 연구의 동기인 것이다. 여기서 지적이라고 하는 말의 의미가 문제가 된다. 옛날에는 덧셈이나 곱셈도 지적인 일이라고 생각되었으나 현재는 아무도 그렇게 생각지 않는다. 컴퓨터가 할 수 있는 기계적 일이 되고 말았기 때문이다.
AI 연구에는 주로 두가지 흐름이 있다. 하나는 생리학적으로 뇌의 매커니즘을 밝혀 이에 바탕을 두고 인간의 뇌처럼 생각하는 기계를 만들 수 없을까 하는 연구이다. 글자 그대로 AI 또는 人工頭腦라는 이름에 어울리는 것이지만 이것에 관해서는 거의 모르고 있다고 할 수 있다. 한편, 기존의 컴퓨터를 인간 쪽이 우월하다고 생각되는 분야에도 응용하자는 연구가 있다. 바로 후자의 연구가 주가 되어 있다. 이와같이 AI연구는 컴퓨터의 응용기술에 대한 프론티어이며 그 내용은 시대와 함께 변화하는 것이다.
전자이 흐름인 AI연구는 극히 중요하고 흥미 있는 과학적 테마이며 이후에도 적극적으로 연구를 해 나가지 않으면 안될 것이라 생각된다. 또 후자의 흐름을 본연의 AI 연구라고 해서 크게 틀림이 있는지 의문스럽지만 컴퓨터의 발달에 의해 보다 많은 지식정보를 취급할 수 있게 된 현재, AI 연구라는 이름 아래 지식 정보에 대한 조직적인 컴퓨터의 응용기술개발이 행하여지는 것은 그 의미가 크다고 생각한다. 이후에도 실용적인 AI 시스템에 개발되어 공학에 있어서도 산업에 있어서도 급격한 발전을 기대할 수 있다고 생각한다.
현재의 컴퓨터 원리로 지적인 작업이 어디까지 가능한 것일까? 현재의 컴퓨터는 노이만형 컴퓨터라고 불리고 있으며 디지털 정보처리를 하고 있다. 노이만형 컴퓨터는 명령에 해당하는 프로그램을 자신의 기억장치 속에 저장해 두고 그것을 수시로 하나하나 꺼내서 추리하는 타입의 컴퓨터를 말한다. 이같은 형의 컴퓨터가 원칙적으로 무엇을 할 수 있는가 하는 논의는 이미 Alan Turing 이라는 수학자에 의해 실제 컴퓨터가 등장하기 이전에 밝혀진 바 있다. 그는 Turing Machine 이라고 하는 수학적인 모델을 제창, 그 기계로 수학적인 처리가 가능한 것을 밝혔다. 원리상으로 현재의 컴퓨터로 실현할 수 있는 것은 Turing Machine 로 할 수 있는 것에 한정되어 있다는 사실은 이미 알려진 바와 같다.
즉, 컴퓨터에 한계가 있다는 것은 이미 명확하게 밝혀져 있다는 것으로, 컴퓨터는 실행하는 방법을 알고 있는 것밖에는 할 수 없다는 말이 된다. 이는 기계라고 불리는 것 전부에 해당되는 말이라고 볼 수 있다. 컴퓨터에게 방법을 학습시키면 된다고 생각되겠지만 그 학습의 방법을 지정하지 않으면 안된다. 그렇지 않으면 학습이 안되는 것이다. 지정한 방법 이외의 방법으로 학습을 할 수가 없는 것이다. 원래의 인간두뇌에 학습은 매우 중대한 기능이긴 하나 그 방법은 잘 알지 못한다. 학습의 방법을 조금이라도 구명 하고자 하는 것이 前者의 흐름인 AI 연구의 중요한 테마이다.
인간의 배우는 방법은 태어날 때부터 딱 한가지로 정해져 있는 것이 아니다. 자유분방하다. 발상, 직관, 창조 등의 방법이 이미 정해져 있다고는 생각되지 않는다. 아니면 두뇌에 대한 연구가 발달되지 못했기 때문에 그 방법이 구명되지 않고 있는지 모를 일이다. 이 점이 기계와 인간의 근본적으로 다른 갈림길이 된다. 그러나 현재 이 문제에 대해 아무도 이것이다 하고 대답할 수 는 없다.
인간의 두뇌는 현재의 컴퓨터처럼 노이만형도 아니며, 신경적으로는 애널로그형의 정보도 있기 때문에 디지털 정보만을 처리하고 있는 것도 아니다. 이런 점으로 미루어 보면 현재의 컴퓨터와 인간의 두뇌와는 근본적으로 다르다. 현재의 컴퓨터에 대표되는 디지털 표현을 사용한 처리에는 잘 할 수 있는 분야와 잘 할 수 없는 분야가 있다. 따라서 후자의 흐름인 AI 연구에 있어서는 '디지털 기계에도 자신있는 ,그리고 인간의 뇌에도 극히 자연스러운 제한을 어떻게 부여하느냐 하는 연구' 라는 관점이 중요하다고 주장하고 있으며 이 주장은 중요한 의미를 갖고 잇다.
AI 연구가 컴퓨터에게 인간처럼 생각하게 하는 것을 목표로 한다면 인간이 일상적으로 사용하고 있는 '애매성 (Ambiguity)' 을 잘 처리할 수 없는 한 그 목표에 도달할 수 없을 것이다. 더욱이 컴퓨터를 인간과 협력하여 문제해결을 실행하는 기계로 만들기 위해서는 man-machine interface 의 유연성, 부드러움이 중요하며 여기서도 애매성이 중요한 역할을 하고 있는 것이다.
지금까지의 AI 연구중 실용적으로 성공을 거두기 시작한 것으로는 전문가시스템 이란 것이 있다. 이것은 특정분야, 예를 들면 고장의 진단이나 주식상담 등의 분야를 정해 그 분야의 전문가가 가지고 있는 노하우나 지식을 컴퓨터에 실어 그 전문가와 같은 판단을 컴퓨터에게 시키자는 시스템이다. 그렇다면 전문가의 지식이란 어떤 것이면 어떻게 해서 컴퓨터에게 알 수 있도록 표현하는 것인지, 전문가시스템을 만드는 법부터 살펴 보기로 하자.
먼저, 전문가의 애기를 듣는다. 다음에 IF-THEN 형식의 룰(규칙)이라고 하는 '만약 ... 이면, ... 하라' 라고 하는 형식으로 전문가의 지식을 고쳐 쓴다. 그것을 종래의 기호논리학에 기초하여 추론을 컴퓨터에게 실행시켜 전문가와 같은 판단을 시키고자 하는 것이다.
여기서 가장 어려운 것은 전문가의 지식을 끌어내는 것, 그리고 그것을 컴퓨터에 실을 수 있도록 IF - THEN 의 룰로 변형시키는 것이다. 전문가는 통상 룰로서 의식하고 있지 않으며 엄밀한 형태로 룰을 만들 수는 없다. 기껏 언어에 의해 이런 때는 이렇게 하면 잘되는 수가 많다고 하는 형태가 될 수밖에 없다. 이것을 종래의 기호논리학에서 처리할 수 있도록 하기 위해서는 YES, NO로 대답할 수 있는 명확한 형태로 하지 않으면 안되지만 이것은 현실적으로 극히 곤란한 작업이다.
그러나 실제의 전문가시스템에서는 이것을 무시하고 있다. 그래서 마구잡이로 룰이 많아져 여간해서 실용화가 되지 않거나 만들어는 보았으나 변경이나 개량이 매우 어렵게 되곤 하는 것이다. 이 결점은 복잡한 것이나 애매한 것을 二値논리에 바탕을 두고 분석하고 있어 지금까지의 과학기술에서 발생하고 있는 결점과 꼭 같다.
전문가시스템이 지향하는 점은 종래의 이론으로는 잘 되지 않는 사항들, 즉 기계화할 수 없는 일을 인간들은 잘 소화하고 있기 때문에 그 인간의 지식과 경험을 살리자는 취지이다. 그러므로 전문가시스템으로는 애매한 사항에 대한 처리는 필요불가결한 것이다. 그렇다면 전문가시스템이야 말로 퍼지이론이 필요하며 퍼지이론의 첫째 응용분야는 전문가시스템이라고 말할 수 있다. 더구나 전문가시스템은 '만약 ... 이면, ... 이다' 라고 하는 추론의 형태를 갖는 룰을 사용하기 때문에 앞에서 말한 퍼지추론이 그대로 적용되는 분야인 것이다.
퍼지이론을 응용한 전문가시스템을 생각해 보자. 먼저 전문가로부터 노하우를 듣는다. 이것을 평상시에 사용하고 있는 언어 - 자연언어 - 로 적어서 받는다. 그리고 몇 가지 룰의 형태 ' 만약 ... 이면, ..으로 된다.' 또는 '마약 ...이면, ... 하라' 로 고쳐 적는다. 여기에서 나타내고 있는 말은 퍼지집합으로 간주, 이 말에 대한 멤버십함수를 그 전문가에게 주관적으로 결정해 달라고 한다. 실제의 적용은 퍼지추론의 장에서 기술한 방법으로 실행한다. 만약 결과가 생각같지 않을 때에는 멤버십함수의 값을 적당히 변경하면 된다.
최근엔 입력과 출력을 보고 멤버십함수를 학습하는 방법도 몇 가지 제안되고 있다. 퍼지엑스퍼스트시스팀에서 사용되는 룰은 퍼지집합을 사용하여 기술되어 있기 때문에 특히 퍼지룰이라고 불리고도 한다. 퍼지제어도 퍼지전문가시스템의 전형적인 예인 것이다. 애매성을 갖는 인간의 지식을 이용하여 컴퓨터에게 인간에 가까운 추론을 시키고자 하는 시도는 퍼지집합을 이용함으로써 하나의 새로운 분야를 열었다고 할 수 있다.
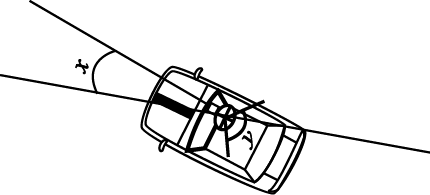
퍼지전문가시스템의 지극히 간단한 예를 소개한다. 그림 1 에서 차의 방향제어를 생각해 보자 간단히 차의 각도만을 생각해 보자. 주의하고 있는 부분은 차의 방향이므로 이를 제어하는 것은 차의 핸들각도 선택만으로 가능하다. 이런 정도의 제어는 아이들도 할 수가 있다.
이것으로 퍼지룰을 만들어 보자. 우선 말로 표현해 보기로 하면' 차가 우측으로 향해 있으면 핸들을 좌측으로 돌려라.' '차가 놔측으로 향하면 핸들을 우로 돌려라.' 그리고 '똑바로 향하고 있으면 핸들은 그대로 두어라' 의 세 가지 정도는 누구든지 알 수 있다. 이것을 퍼지룰로 고치려면 차의 각도를 x, 핸들의 각도를 y,로 하면 다음과 같이 된다.
<그림 1> 차의 핸들제어(x는 차의 방향, y는 핸들의 각도)
퍼지룰1 - 만약 x가 우측이면 y를 좌측으로 돌려라.
퍼지룰2 - 만약 x가 좌측이면 u를 우측으로 돌려라.
퍼지룰3 - 만약 x가 똑바르면 y를 그대로 둬라.
이룰에서 퍼지집함으로 표시되어야 할 부분은 차의 방향인 우측과 좌측, 직진 그리고 핸들의 회전방향인 우회전, 좌회전, 현재 그대로 등 여섯가지이다. 지금 이들 멤버십함수를 각각 <그림 2>(a) ~ (c) , <그림 3>(a) ~ (c) 처럼 나타내기로 한다.
퍼지룰 1을 퍼지함수로 나타내 보자. 차의 방향 전체집합을 -15도 ~ 15도로 하도 U 로 표시한다. 핸들의 회전방향 전체집합을 -45 ~ 45도로 하여 V 로 표시한다.
퍼지룰 1에서 U와 퍼지 관계를 정의하는 방법은 몇 가지가 있으나 여기서는 가장 간단한 단두법이라는 방법을 활용하도록 한다.
간단하게 하기 위해서는 U는 [-15도, -10도, -5도, 0도, 5도, 10도, 15도]의 일곱 개의 점을 , V는 [-45도, -30도, -15도, 0도, 15도, 30도, 45도]의 일곱 개 점으로 하여 그 이외의 점은線形褓間 (그 점을 포함하는 양쪽 끝의 점의 수치로부터 비례해서 계산)하기로 한다.
이상과 같이 가정하여 퍼지룰 1은 표 1(a)와 같은 퍼지관계 R1이 된다. 이 퍼지관계를 만드는 법은 매우 간단하다. 차의 방향이 분명히 우로 향해 멈버십함수의 값이 1인 때 (그림 2(a)에서 10도나 15도)에는 V상의 퍼지집합으로 하여 좌회전 그대로를 내어 멤버십 함수가 작을 때 (그림 2(a) 에서는 5도이면 0.5)에는 그 값으로 좌회전의 멤버십함수의 머리를 잘라 버리고 출력하는 것이다.
마찬가지로 퍼지룰 2와 3은 각각 표 1(b)~(c)로 표시되는 퍼지관계 R2, R3이 된다.

<그림 2> 차의 방향에 관한 멤버십함수

<그림 3> 핸들의 회전방향에 관한 멤버십함수
|
|
-45˚ |
-30˚ |
-15˚ |
0 |
15˚ |
30˚ |
45˚ |
|
15˚ |
1 |
1 |
0.5 |
0 |
0 |
0 |
0 |
|
10˚ |
1 |
1 |
0.5 |
0 |
0 |
0 |
0 |
|
5˚ |
0.5 |
0.5 |
0.5 |
0 |
0 |
0 |
0 |
|
0 |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
-5˚ |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
-10˚ |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
-15˚ |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
(a) 퍼지 룰1을 나타내는 퍼지
|
|
-45˚ |
-30˚ |
-15˚ |
0 |
15˚ |
30˚ |
45˚ |
|
15˚ |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
10˚ |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
5˚ |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
0 |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
-5˚ |
0 |
0 |
0 |
0 |
0.5 |
0.5 |
0.5 |
|
-10˚ |
0 |
0 |
0 |
0 |
0.5 |
1 |
1 |
|
-15˚ |
0 |
0 |
0 |
0 |
0.5 |
1 |
1 |
(b) 퍼지 룰2를 나타내는 퍼지
|
|
-45˚ |
-30˚ |
-15˚ |
0 |
15˚ |
30˚ |
45˚ |
|
15˚ |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
10˚ |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|
5˚ |
0 |
0 |
0.5 |
0.5 |
0.5 |
0 |
0 |
|
0 |
0 |
0 |
0.5 |
1 |
0.5 |
0 |
0 |
|
-5˚ |
0 |
0 |
0.5 |
0.5 |
0.5 |
0 |
0 |
|
-10˚ |
0 |
0 |
0 |
0 |
0 |
1 |
1 |
|
-15˚ |
0 |
0 |
0 |
0 |
0 |
1 |
1 |
(c) 퍼지 룰3을 나타내는 퍼지
[표 1]
지금 차의 방향이 5도 였다고 하자. 이때 퍼지관계 R1에서 그림 12의 A라고 하는 멤버십함수가, 퍼지관계 R3에서 B라고 하는 멤버십 함수가 출력된다. R2로부터는 아무것도 출력되지 않는다. 퍼지전문가시스템에서는 각 룰을 동시에 병렬로 1회만 적용하여 출력된 각각의 퍼지집합의 집합체중 큰 쪽을 취한다. 이것이 지금까지 사용하여 온 전문가시스템과 크게 다른점이다. 추론은 대략적으로 그리고 얕게 라는 정신이 깔려 있다.
멤버십함수도 여기서는 극히 간단한 것을 사용했지만 실제 퍼지제어등에서 사용되고 있는 것도 이 정도로 간단한 것이다.
<그림 4>의 출력을 말로 표현하자면 다음과 같이 될 것이다. 차의 방향이 우로 5도 향하고 있을 때는 핸들을 좌로 돌리는 것과 그대로 두는 것을 반반으로 적용하도록 하라. 즉 좌회전과 그대로의 중간으로 하도록 지시하고 있다. 보통 운전자 없이 자동운전을 하기 위해서는 출력때 수치 하나로 핸들의 각도를 결정해야 한다. 이는 출력의 퍼지집합으로부터 하나의 crisp 값을 찾아내는 것으로 디퍼지화 , 즉 脫퍼지화라고 부르고 있으며 여기에도 여러 가지 방법이 있다. 여기서는 가장 단순한 방법으로서 최대의 멤버십함수치를 sor hdlT는 점의편균치로 계산하여 -45도에서 15도 까지가 0.5를 내고 있기 때문에 -15도 ,즉 좌로 15도 핸들을 회전시키라는 결론을 얻게 된다.
이상에서 차의 방향이 10도, 7.5도, 5도 2.5도, 0도, -2.5도 -5도, -7.5도 ,-10도로 변화했을 때의 출력에 대한 예기 <그림 5>(a) ~ (i) 에 표시되어 있으니 확인해 보기 바란다.
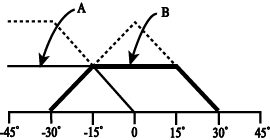
<그림 4> (c)x=5˚ 인때의 출력
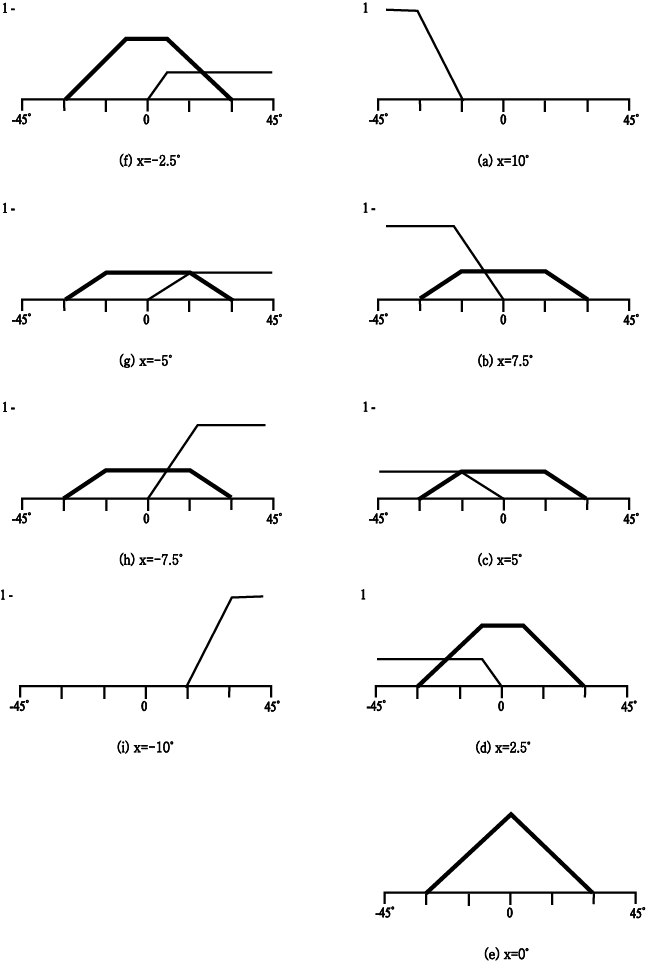
<그림 5> 차의 방향이 10˚ ~ -10˚으로 변화했을때의 출력
지금까지의 예에서 보면 입력은 차의 방향으로 crisp 값 즉 10도라든지 5도라든지 하는 것이 얻어진다. 입력도 퍼지집합의 경우에는 퍼지추론에서 언급한 것처럼 쉽게 계산할 수 있다.
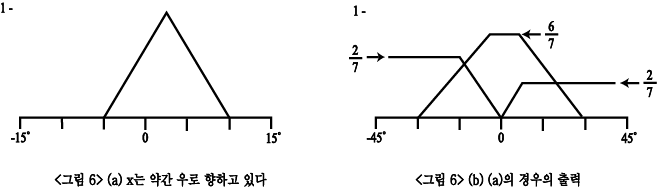
예를 들면 입력시 사람의 언어를 받아들여 '약간 우로 기울고 있다' 고하자. 이때 퍼지집합을 <그림 6>(a) 라고 하면 출력은 (b)가 된다.
이런 간단한 룰로 자동차의 제어가 가능해진다. 더구나 인간과 동일한 실행방법으로 되어 있는 것에 유의하여 주기 바란다. 이 룰에는 종래의 제어에서는 중요한 것이었던 차의 무게도 속력도 표면에 나오지 않는다. 이런 간단한 룰로 잘 된다면 종래의 엄밀한 이론에 기초를 둘때면 훨씬 더 잘 되겠지 하고 생각되겠지만 어떤 면에서는 사실일지라도 퍼지전문가시스템에서는 복잡한 것이라도 간단한 퍼지룰로 잘 되는 수도 있다는 것, 나아가 종래의 엄밀한 방법으로는 잘 되지 않으나 인간은 잘하고 있다는 경우 등에 적용할 수 있다는 것이다.
퍼지룰의 선택법이나 멤버십함수를 정하는 방법들에 많은 미해결의 문제나 시행착오가 있으나 퍼지전문가시스템의 전형적인 예인 퍼지제어에서는 수많은 성공사례가 나오고 있다.
퍼지집합의 생각하는 법이 1965년에 Zadeh 교수에 의해 제안된 당초에는 주로 이론적인 것으로 한정되어 있었다. 이 무렵에는 퍼지이론 그 자체를 구축하고 있던 초기시대이기도 하지만 퍼지라고 하는 사고방식을 기존의 수학적 이론에 응용하던 시대이기도 하다. 기존의 수학적 이론은 보통집합 (crisp set) 위에 성립되어 있기 때문에 그 기초적인 집합론을 퍼지집합론으로 바꾸면 그 수학은 퍼지화된 새로운 수학으로 바뀌어 나타나게 되는 것이다.
예를 들면 통상적인 숫자 2 나 3 에 퍼지의 사고방식을 도입하면 '거의' 2 나 '대체로' 3 이라고 하듯이 퍼지한 수(fuzzy number)가 된다. 그렇게 하여 퍼지연산 이 만들어진다. 마찬가지로 적분은 퍼지적분으로 되고 토폴로지라고 하는 수학의 분야에서는 퍼지토폴로지라고 하는 새로운 수학이 생겨나게 되는 것이다. 그와 같은 것의 하나가 종래의 二値에 의한 추론에 퍼지의 사고방시을 도입한 퍼지추론 이었다. 이론적인 연구만으로 아무런 쓸모가 없다고 일컬어지던 퍼지이론도 이 퍼지추론의 공학적인 응용에서 돌파구가 열린 것이다.
1974년에 영국 런던 대학의 E.H Mamdani 박사가 스팀엔진의 자동운전에 퍼지추론을 응용해 좋은 결과를 얻었다. 이것이 퍼지추론을 제어에 응용한 퍼지제어 (fuzzy control) 라고 하는 공학적 응용분야에서 효시가 되었다. 1980년에는 이 추론을 토대로 실용화의 제 1호가 덴마크의 Smidth 사에서 cement kiln 용의 fuzzy controller 로서 등장하게 되었다. 1970년대 후반부터 이 퍼지제어의 연구가 왕성해져 1980년대에 들어서 많은 분야에서 실용화되기 시작했다. 일본에서도 최초로 도쿄공대와 후지전기의 공동연구로 정수장의 약품 주입제어에 퍼지제어가 응용되었다. 그 이후 급격히 활발해져 산업계에서 주목받는 분야가 된 것이다. 지하철의 제어나 엘리베이터의 제어등에 퍼지제어가 사용되어 성공을 거둔 많은 사례가 보고되었다.
퍼지제어는 인간의 능숙한 제어나 승차감이라고 하는 주관적인 요소를 도입한 제어분야에서 위력을 발휘하고 있다. 일본의 퍼지제어는 세계를 주도할 정도로 고수준의 하이테크 기술로 발전을 계속하고 있다. 또, 미국에서는 군사관계에 퍼지 제어를 응용하자고 하는 움직임이 일고 있다.
퍼지제어는 퍼지추론의 하나의 응용으로서 퍼지엑스퍼트시스템을 말한다. 퍼지추론 에서는 룰은 퍼지집합에 대응하는 언어로 표기된 퍼지룰이며 그것을 퍼지로 변형해서 사용하였다. 퍼지추론에서는 crisp 한 어떤 확정된 값 또는 퍼지집합이 입력되었지만 출력되는 것은 항상 퍼지집합이었다. 그러나 퍼지제어와 같이 출력치에 의해 기계가 제어될 경우는 그 값이 확정되지 않으면 안된다. 입력도 기계로 하므로 역시 명확한 하나의 값이 나와야 한다. 더구나 입력은 하나의 수만을 측정하는 것이 아니고 일반적으로 둘 이상 있다. 더욱이 퍼지제어에서 사용하는 퍼지관계는 단두법이라고 불리는 극히 간단한 방법을 쓰고 있는 경우가 많다. 이 경우엔 퍼지관계를 사용하지 않아도 퍼지룰을 간단히 그림으로 나타낼 수가 있다. 이상의 상황을 좀더 자세히 설명해 보기로 한다.
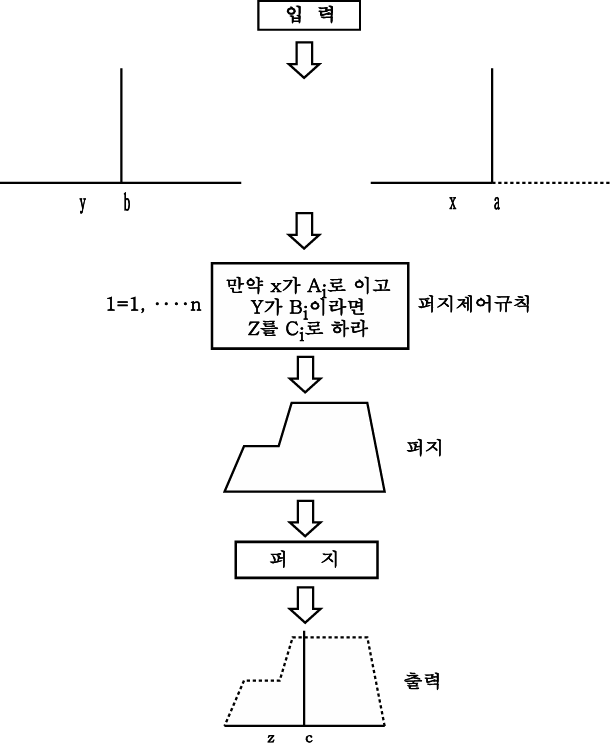
퍼지제어에서는 퍼지룰을 써서 실제의 프로세스 등 대상의 제어를 행한다. 예를 들면 '만약 기온(x) 이 높아 (Ai) 지는 동시에 그 변화 (Y) 가 적 (Bi) 으면 밸브를 잠그는 힘 (Z) 을 약간 약 (Ci) 하게 하라' 처럼 퍼지집합 Ai, Bi 및 Ci를 포함한 언어표현으로 룰이 주어진다. 퍼지제어에서 사용되는 퍼지룰은 특히 퍼지제어 규칙이라고 부른다. 일반적으로 이 같은 룰이 많을 때 n 개가 있다고 하면 이것을 i=1...n 로 적는다. 여기서 기록한 퍼지제어 규칙은 i 번째의 규칙으로 한다.
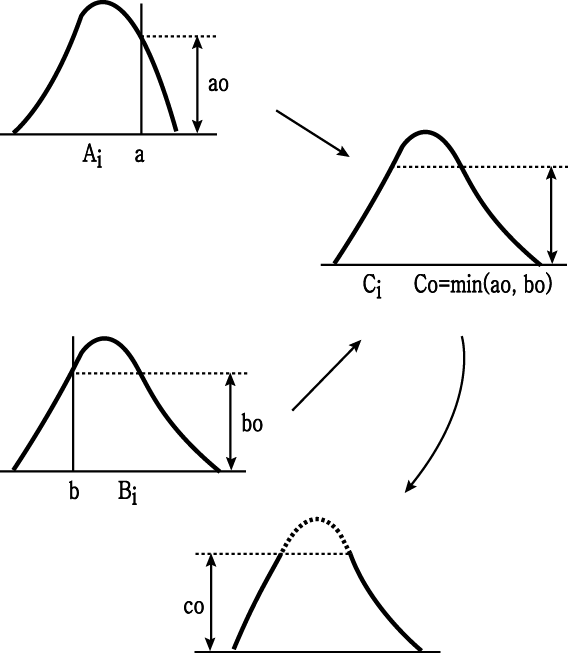
이때, 입력의 값으로 x=a, y=b 가 얻어졌다고 하자. 지금 퍼지집합 Ai, Bi 및 Ci 가 다음 그림처럼 되어있었다고 한다면, 먼저 i 번째의 규칙의 전반부('만약 ... 이면' 의 부분) 와도 일치도를 구한다. 이것은 Ai에 대한 입력값 a 의 일치도, 즉 a 에 있어서의 멤버십 함수 Ai 의 값 a0 과 Bi 에 대한 입력값, 입력값 b 에 있어서의 멤버십함수 Bi 의 값 b0 과의 작은 편을 택한다. 이것은 한 편을 작은 쪽으로 취한다고 하는 해석에 따르고 있다.
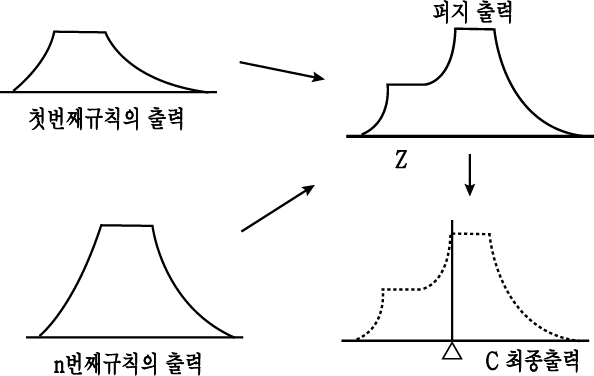
지금 이 작은 쪽의 값이 Co 였다고 하자. 다음 그림에서는 이것을 Co=min(a0, b0) 라고 표기되어 있다. 그러면 i 번째의 규칙을 이 입력에 적용한 결과는 규칙의 후반부 ('...하라'의 부분)의 퍼지집합의 멤버십함수 Ci 의 머리를 Co 으로 자른 퍼지집합으로 하는 것이다. 이와 같은 출력이 규칙의 수만, 즉 n 개를 한꺼번에 얻을 수 있다. 그중 어느 것을 선택해야 좋을까. 어느 것이 가장 큰 것인지하고 생각하는 것은 퍼지집합의 경우엔 이젠 일반적으로는 말할 수 없다. 대소관계는 정할 수가 없다. 보통 이들 n 개 출력의 合集合, 즉 변수 n 의 각 값에 있어서 각각의 출력 멤버십함수의 소속척도 중에서 가장 큰 것을 취함으로써 얻을 수 있는 퍼지집합으로 하고 있다.
이를 비교한 내용이 다음 그림에 나타나 있다. n 개의 출력 합집합의 결과가 퍼지출력이라고 적혀 있는 퍼지집합이다.
단, 일반 퍼지추론에서는 더욱 복잡한 퍼지 관계를 사용한다. 앞의 예는 이 단순한 단두법을 퍼지관계로 나타낸 것 뿐이다. 실제의 퍼지제어라도 좀 더 복잡한 방법도 사용될 때가 있으나 현재로서는 이 단두법이 주류를 이루고 있다.
최종출력은 이 퍼지출력으로부터하나의 명확한 값으로 하지 않으면 안된다. 퍼지엑스퍼트시스팀의 예에서는 소속척도가 1인 것의 평균치라고 하는 예를 표시했으며, 일반적으로는 중심이라 하여 소속척도가 1 이외의 모든 값을 고려한 평균치가 쓰이고 있다. 이처럼 퍼지집합으로부터 명확한 하나의값을 추출하는 것을 퍼지화(fuzzification)와는 반대되는 탈퍼지화 (defuzzification) 라고 부르고 있다.
이상이 퍼지제어 시행방법의 간단한 소개이다. 누구든지 이해할 수 있는 듯한 간단한 사소방법이다. 이는 종래의 제어이론보다 훨씬 인간의 시행방식에 가깝기 때문이다.
여기서 사용하는 퍼지제어규칙을 전문가에게 물은 다음 사용하고 있는 퍼지집합의 멤버십함수도 전문가에게 정해달라고 하든지 또는 적당히 정해놓고 실험에서 수정해 가면 되는 것이다.
종래의 제어방법에 비교한 퍼지제어의 특징에 대해 생각해 보자. 먼저 종래의 제어와 근본적으로 다른 것은 '만약 ... 이면, ... 하라' 라고 하는 IF - THEN 형의 룰이 기본이 되어 있다. 그리고 각 퍼지제어규칙은 전문가(엑스퍼트)로부터 얻는다. 다시 말해 엑스퍼트시스팀인 것이다. 이것이 첫째 특징이다. 다음으로 엑스퍼트의 지식에는 그 개인의 주관이 들어 있으며, 거기에 포함되어 있는 애매성을 퍼지집합을 사용하여 적극적으로 수치화하여 입력시키고자 하는데 둘째 특징이 있다. 룰 형식으로 해서 바라볼 때의 퍼지 제어의 특징은 모든 룰을 병렬로 그리고 동시에 고려하고 있는 데에 있다. 이것이 셋째 특징이다.
종래의 룰 형식에 기초한 시스팀에서는 주어진 사실, 여기서 소개한 예에서는 x=a, y=b에 정확히 일치하는 하나의 룰이 선택된다. 일반적으로는 그 결론이 성립되는 것을 사실로 간주하고 다음으로 일치하는 전반부를 갖는 룰을 찾으며 이것이 몇 단계 계속되는 것이 보통이다.
전반부가 성립하는 범위라는 관점에서 종래의 룰형식 시스팀을 생각해 보자. 변수 x가 취하는 전체집합을 U, y의 값이 취하는 전체집합을 V라고 하면 각 룰의 전반부가 성립하는 범위는 U와 V로부터 이루어지는 공간을 명확히, 즉 크리습하게 나눈 부분집합의 어느 하나가 된다.
다음 그림에서는 M1, M2, ... , M5를 1,2, ... ,5 번째 룰의 전제부가 성립하는 범위로 한다. 주어진 사실 Co은 두 번째 룰의 전반부에만 일치되었고 그 이외의 룰 전반부에는 전혀 일치되지 않았다. 이 경우 결론은 두 번째 룰의 후반부가 된다. 만약, 입력치가 변경돼 Co에서 c1, c2 로 변화하면 사용되는 룰은 M4, M3 로 바뀌게 되어 그 때마다 결론도 급격히 변화될 가능성이 있다.
한편, 퍼지제어에서는 룰의 전반부는 퍼지집합으로 기술되어 있으므로 U와 V로 이루어지는 입력의 공간은 애매하게 분리되어 있는 것이 된다. 어떤 하나의 사실 Co에 대해 그 전반부와의 일치도에 따라 보든 룰이 동시에 적용되어 한 단계가 얕은 추론으로 결론을 얻는 것이다.
다음 그림의 F1, ... F5는 다섯가지 룰이 있을 경우의 각 전반부를 나타내는 퍼지집합이며 Co 라고 하는 입력은 F2, 즉 두 번째의 룰에 가장 강하게 일치하고 있지만 F3에도 F4에도 어느 정도의 척도로 일치하고 있는 것이다. 그러므로 Co 이 C1, C2 로 조금씩 변화하면 출력도 연속적으로 조금씩 변해 급격히 변화하는 일은 없다. 이것이 소프트한 제어결과가 얻어지는 요인이다.
|
|
|
확실한 분할 |
애매한 분할 |
복잡한 프로세스에는 룰 그 자체에 어쩔수 없는 애매성이 내재해 있다. 이것을 무리하게 YES(1), NO(0) 의 두값에 억지로 맞추고는 몇 단계 깊이 추론하는 경우 최종 결론이 현실과 동떨어진 것이 되어 버린다고 해서 이상할 이유가 없다. 퍼지제어는 룰 자체에다 애매성을 흡수하여 인간이 그렇게 하듯 간단한 추론으로 대체적인 결론을 얻는다는 퍼지이론의 정신에 따르고 있다.
이 밖에 퍼지제어의 또 하나의 특징이 있다. 그것은 고장에 강하다는 것이다. 예를 들면 아래 그림 에서 하나의 룰이 고장이 나서 가동하지 못하게 되었다고 가정하자. 그때 그때의 척도는 낮을지는 모르나 다른 룰이 그 척도에 따라서 도와주고 있는 것이다. 종래의 룰 시스템에서는 에서는 그렇게 되지 않는다. Co 이라고 하는 입력이 있었을 때 첫 번째나 다섯 번째의 룰이 고장이 나도 문제가 없으나 두 번째의 룰이 고장이 나면 그 룰 밖에 적용되지 않기 때문에 출력은 전혀 얻을 수 없다는 결론이 된다.
현재 퍼지제어가 실제로 응용되고 있는 예를 몇가지 들어보기로 한다.
(1) 지하철이나 열차의 자동운전
(2) 컨테이너의 자동운전
(3) 엘리베이터의 집단 관리
(4) 정수장의 약품제어
(5) 로봇의 팔제어
(6) 우리용광로의 온도제어
(7) 쓰레기소각로의 제어
(8) 냉연(冷延) 프로세스의 제어
(8) 소결(燒結) 프로세스의 제어
(10) 아크로봇의 제어
(11) 공급 온수의 온도제어
(12) 자동차 정속(正速)주행제어 등이다.
(1)의 지하철 자동운전은 센다이의 지하철에 히타치제작소가 퍼지제어를 응용하여 자동운전을 실행했던 것이다. 운전사의 경험을 토대로 안전성, 승차감, 에너지 절감, 주행시간 단축, 정지정확도에 관한 퍼지제어규칙을 유도해 내어 실제로 자동운전을 시켰던 것이다. 종래의 제어방법에 비해 브레이크를 거는 회수가 줄었기 때문에 연비가 절약되고 승차감도 좋아졌다는 평이었다.
퍼지 이론의 제창자인 Zadeh 교수는 현대 제어이론 창설자의 한사람 이기도 하지만 아무리 엄밀한 이론을 구성하고 있어도 복잡한 시스템의 제어에는 대처할 수가 없어 그 좌절감으로 퍼지이론을 연구하게 되었다. Zadeh 교수는 자신은 퍼지이론이 제어에 응용될 수 있다고는 예상을 못했었다고 후에 술회하고 있었지만 퍼지이론은 그 이론의 발생토대인 제어이론에 보답을 한 셈이다. 퍼지 이론의 제어에의 응용은 유럽에서 본격적으로 시험되었고 현재 퍼지제어는 일본에서 꽃을 피우고 있다.
문과계로 구분되는 사회과학이나 인문과학과 이과계로 분류되는 이학이나 공학 그 어느 쪽이 애매성이 많을까? 물론 사회·인문과학일 것이다. 여기서 말하는 애매란 적당히란 뜻은 무론 아니다. 사회 · 인문 과학은 연구대상이 인간이기 때문이며, 인간만큼 애매한 것은 없기 때문이다. 이와 달리 이과계는 연구대상이 물체이다. 그 중에서도 공학에는 인간의 책터가 약간 내재되어 있다. 만든 물건을 이용하는 주체가 인간이기 때문이다. 공학 분야에서 연구대상이 복잡해진다든지 연구대상에 불분명한 점이 많아진다든지, 인간과의 조화를 생각한다든지, 지적인 인간의 실행방법을 흉내내려고 한다든지 할 때 애매성을 피해갈 수가 없게 된다.
이것이 공학 분야에서 퍼지이론이 적응하게 된 배경이다. 물체는 인간에 비하면 훨씬 명확한 것이다. 그렇게 명확한 것도 애매한 파악, 애매한 추론이 치밀하고 엄밀하게 하는 경우보다 더욱 잘 처리되는 경우가 있으며 지금까지는 안되었던 것이 되어지는 공학분야, 특히 퍼지제어의 분야에서 이같은 일이 분명해지는 경우가 있다. 퍼지이론의 유용성이 실증되는 것이다. 그러나 퍼지이론이 정말 필요한 것은 문과계 쪽인지 모른다. 이 경우 대상이 인간이며 인간은 애매하기 때문에 퍼지이론이 공학 분야에서 제창되어 그 유용성이 입증되었지만 퍼지 본래의 힘을 발휘하는 쪽은 문과계 분야에 있어서일 것이다. 그렇게 볼 때 문과계에서 취급해야 할 애매성은 공학 분야에서의 애매성이 비해 월씬 많고 크다. 퍼지이론으로 모든 애매성을 취급할 수 있다고 생각할 수 없지만 확률이란 애매성을 취급하기 위한 하나의 수단으로 인식되고 있다.
지금까지도 사회과학등을 중심으로 자연과학이나 공학에서 개발된 매우 경직된 이론을 문과계통에 응용한 예는 허다하게 있다. 그러나 그것이 사실상 성공하고 있는지 여부와 소프트하고 애매한 연구대상에 대하여 글자체와 같이 분명한 것에 적용시키기 위해 개발된 하드한 이론을 적용하는 것은 무리라는 생각이 든다.
지금까지 이과계에서 애매성을 취급하기 위하여 개발한 이론적 도구는 확률론이었다. 사회과학쪽에서도 이 확률론과 그것을 응용한 통계학이 활발히 이용되고 있다. 그러나 불확실한 것을 만나면 모두 애매성이라고 해서 바판없이 확률통계를 그대로 사용하고 있다.
좋고 싫고의 주관적인 문제에 확룰을 그대로 사용하는 것은 이상하다고앞에서도 기술했었다. 이와같은 의미에서도 퍼지이론은 문과계, 특히 사회과학분야에 하나의 충격이 될 것이다.
애석하게도 퍼지이론은 사회과학 연구자에게는 그다지 잘 알려져 있지 않다. 그 방면에서의 응용은 별로 눈에 띄지 않고 있다. 그러나 공학자가 사회과학 방면에 응용을 시도하거나 일부 사회과학 연구자가 이용하기 시작했다.
현재 사회과학분야에서 퍼지이론이 응용되고 있는 것에 대하여 말하기 전에 그것이 어떻게 사고방법상 응용이 가능한지를 간단한 예를 통하여 살펴보기로 하자.
공학분야에서의 응용되는 퍼지제어 예를 앞에서 소개했다. 이것은 물체를 대상물의 목표에 맞도록 컨트롤 하는 것이었다. 퍼지제어의 기초가 되고 있는 것은 퍼지이론 중에서도 퍼지추론의 사고방법이다. 이 퍼지추론을 응용한 퍼지엑스퍼트시스팀의 응용은 공학에만 한정시킬 필요는 없다. 종종 물체의 컨트롤에 응용할 것이 공학에서 성공한 퍼지제어였다. 만약 이 퍼지엑스퍼트시스팀을 주식의 투자상담에 적용하면 야마이치증권이 이미 실용화 하고 있는 것처럼 증권투자용의 엑스퍼트시스팀이 만들어진다.
퍼지엑스퍼트시스팀이 사회과학에 응용될 수 있다는 것은 명확하다. 여기서는 퍼지추론보다도 더 간단한 퍼지집합의 일치도의 사고 방법을 사용한 예를 몇가지 소개하기로 한다.
그다지 적절한 예가 아닐지는 모르지만 다음과 같은 흡연의 예를 생각해 보자.
어떤 의사는 하루에 피우는 담배 개피수가 10개피 이하이면 거의 건강에 해가 없이 안전하다고 생각하고 있다고 하자. 바꿔서 50개피 이상을 피우면 극히 해롭고 20~30개피는 요주의이다라고 생각한다면 의사의 흡연에 관한 사고방식을 퍼지집합을 사용하여 그림으로 나타내면 <그림 12>와 같이 된다. 횡축은 하루에 피우는 담배의 개피수이고 종축은 안전, 요주의 및 위험을 나타내는 퍼지집합의 멤버십함수의 값, 즉 척도를 나타내고 있다.
A씨는 몇 개피 정도 피우면 되는지 퍼지집합을 써서 알아보자.
가령 하루에 10~20 개피를 피우면 만족이다라고 하여서 <그림 12>의 A와 같은 퍼지집합으로 됐다고 해 보자. 이때의 A씨의 흡연에 관한 안전도 ,요주의 및 위험도는 이 의사가 보면 각각 퍼지집합과의 일치도로 나타낼 수가 있다.
퍼지집합의 일치도를 구별하는 방법은 앞에서 설명한 것처럼 交집합을 취했을 때의 멤버십함수의 가장 큰 값으로서 간단히 구해진다. 그림의 예에서는 A씨의 안전도는 0.8, 요주의도는 0.9, 그리고 위험도는 0이 된다.
마찬가지로 B씨는 하루에 40~50 개피를 피우지 않으면 안된다고 하고 그림의 B와 같은 퍼지집합으로 됐다고 한다면 이 경우에는 위험도 0.85, 그리고 안전도는 거의 0이 된다
안전이나 요주의 및 위험을 표시하는 멤버십함수는 과거의 통계를 활용해도 되며 그 환자를 보고 의사가 주관적으로 정해도 된다고 생각한다. 이 예에서 아무래도 적당히 넘어가는 수치밖에 안 나올지도 모르지만 주관적인 사고방법이 일치하게 되는 예를 들어봤다.
최종적으로 환자를 안전이냐 요주의냐 혹은 위험이냐 의 등급으로 나누고자 할 때는 그 일치도가 가장 큰 등급으로 하면 좋을 것이다. 더욱이 이 예에서는 앞에서 언급한 일치도의 예와 마찬가지로 횡축은 연속적인 수치로 되어 있다는 것에 주의하기 바란다.
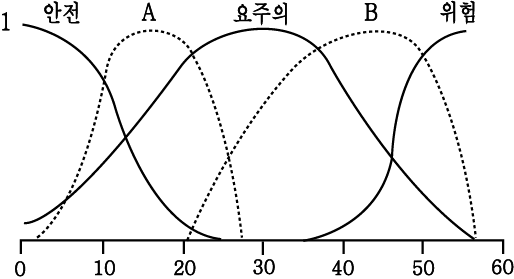
<그림 13> 흡연에 관한 퍼지집합
최근의 앙케이트조사에는 응답을 적어넣는 곳에 YES(1), NO(0)뿐만이 아니고 모른다라든가 어느쪽도 아니다, 약간 그렇다고 생각한다 등의 기입란도 있다. 이것이 벌서 퍼지이론의 사고방법 바로 그것이다. 이런점으로 말하면 퍼지이론의 사고방법은 이미 여러 분야에서 부분적으로 도입되고 있엇다고 할 수 있다. 예를 들면 컴퓨터에 의해 선을 보는 시스팀의 데이터들은 분명히 퍼지한 데이터로 차 있을 것이라고 상상할 수 있다. 부분적으로 생각되고 있던 것들이 퍼지이론 덕택에 통일적으로 그리고 조직적으로 취급되 되었다. 앙케이트와 관련해서 한가지 더 간단한 예를 소개하기로 한다.
앞의 예에서의 橫軸은 연속적인 수치로서 옆의 이웃끼리는 연속적인 관계이기도 했다. 여기서는 횡축은 부분적으로는 독립된 것으로 그 예는 주관적인 앙케이트 조사에 대한 해답이다. 연구실에 출입하는 두 사람의 학생을 대상으로 다음과 같은 9개 항목의 앙케이트 조사를 실시했다. 응답은 정말 그렇게 생각하면 1, 그렇지 않으면 0으로, 그 중간이면 자기 기분에 따라서 0과 1 사이의 임의의 수치를 가늠으로 응답해 받기로 한다.
C1 : 퍼스널 컴퓨터는 친구다.
C2 : 언제나 마감에 쫓기고 있다.
C3 : 맛있는 것이라면 다소의 지출은 아끼지 않는다.
C4 : 수학을 좋아한다.
C5 : 커피는 레귤러라야 한다.
C6 : 놀이를 희생해서까지 공부에 파고 들려고는 하지 않는다.
C7 : 선배와 후배의 상하 관계에 신경을 쓴다.
C8 : 관혼상제의 의리는 저버리지 않는다.
C9 : 사람과의 관계를 많이 갖는 일은 싫다.
이상 C1 ... C9의 9개 항목이 모두 주관적인 앙케이트로 YES(1), NO
|
|
|
C1 |
C2 |
C3 |
C4 |
C5 |
C6 |
C7 |
C8 |
C9 |
|
(a) |
I |
0.9 |
0.9 |
0.6 |
0.8 |
0.4 |
0.6 |
0.2 |
0.1 |
0.1 |
|
S |
0.2 |
0.1 |
0.8 |
0.1 |
0.7 |
0.9 |
0.6 |
0.7 |
0.9 |
|
|
(b) |
A |
0.6 |
0.2 |
0.7 |
0.1 |
0.5 |
0.5 |
0.8 |
0.7 |
1.0 |
|
B |
0.9 |
0.9 |
1.0 |
0.6 |
0.8 |
0.1 |
0.4 |
0.3 |
0.1 |
[표 2] 주관적인 앙케이트의 결과
A, B 두사람에게도 같은 앙케이트를 한 결과가 [표 2](b)에 나타난다.
I 학생 , S 학생을 각각 시티파, 어반파 라고 정의했으므로 A 학생과 B 학생의 시티파度, 어반파度를 각각 퍼지집합과의 일치도로 정의 하기로한다. 이 경우, A 학생의 시티파度는 0.6 ,어반파度는 0.7로 그리고 B 학생의 시티파度는 0.9, 어반파度는 0.8이 되는 것을 확인할 수 있다.
이 예도 앞에서와 마찬가지로 일치도의 정의가 너무나 단순하긴 하지만 퍼지이론을 사용해 애매한 것(앙케이트 결과)를 애매한 것(시티파와 어반파)으로 취하는 하나의 간단한 예가 된다.
이 앙케이트조사와 같은 경우엔 일치도로서 또 하나의 다른 사고방법을 채택할 수가 있다.
예를 들어 0.8과 0.6에서는 0.2밖에 차이가 없으며 마찬가지로 0.4와 0.2에서도 0.2 밖에 차이가 없기 때문에 두 경우가 다 같은 척도로 일치해 있다고 보는 것이다. 이 정의에서는 같은 수치는 완전히 일치하고 0과 1은 전혀 일치해 있지 않다. 따라서 일치도롤 1에서 양자의 차를 뺀 값으로써 정의해 보겠다.
그러면 앙케이트 항목 C1, C4 , C5, C8만을 가지고 I학생으로부터 본 이들 항목끼리의 관련도를 이 일치도를 가지고 계산해 보자. 결과는 쉽게 알수 있듯이 표9와 같은 매트릭스로 표현할 수 있다. 이것은 C1, C4, C5, C8이라는 요소로 된 집합에 있어서의 자기자신 사이의 퍼지관계라고도 볼 수가 있다. 이 정의로는 물론 Ci 와 Cj와의 관련도는 Ci 와 Cj와의 관련도와 일치하기 때문에 매트릭스는 대칭형으로 되어 있다. 더욱이 대각선상의 값이 모두 1로 되어 있는 것에도 유의하기 바란다. 성질은 대칭적 및 반사적이라고 한다. 同매트릭스는 <그림 13>(퍼지그래프)와 같이 고쳐 쓸 수도 있다.
그럼 여기서 친구의 친구는 친구이다라고 하는 관계에 대해 생각해 보기로 한다. 현재는 이 관계가 만족되지 않고 있다. 사실 친구의 어떤 친구와의 관계가 매우 나쁠 수 있다. 그러면 간단하게 하기 위해서 항목 사이의 관계는 이 같은 친구의 친구는 친구다라고 하는 관계(이것을 推移的인 관계라고 부른다)가 만족되고 있다고 하자.
|
|
C1 |
C4 |
C5 |
C8 |
|
C1 |
1 |
0.9 |
0.5 |
0.2 |
|
C4 |
0.9 |
1 |
0.6 |
0.3 |
|
C5 |
0.5 |
0.6 |
1 |
0.7 |
|
C8 |
0.2 |
0.3 |
0.7 |
1 |
[표 3]
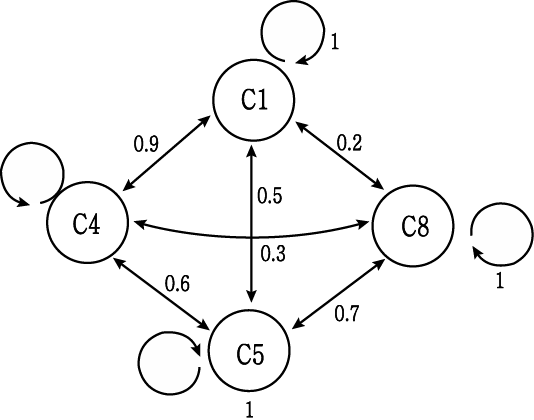
<그림 13> 퍼지 그래프
그런데 퍼지관계의 경우, 예를 들면 <그림 13>에서 C1과 C4의 관련도는 0.9 , C4와 C5와의 관련도는 0.6 이니까 C4를 경유한 C1과 C5와의 관련도를 어떻게 정의하면 좋을까.
퍼지이론에서의 될 수 있는대로 간단한 연산을 사용한다는 정신이기 때문에 물론 작은 쪽 0.6을 취한다. 이렇게 하면 [표 1]은 좀 이상한 관계가 되어 버린다. 친구의 친구로서의 C4를 경유한 C5에의 관련은 직접 가는 경우와 C4를 경유하는 경우외에 C8을 경유하는 경우, C4-C8 및 C8-C4와 같이 경우하는 경우의 합은 총 다섯가지가 있다.
추이성을 만족시키는 새로운 관련도를 이것들 중의 가장 큰 값으로 정의해 보자
|
|
C1 |
C4 |
C5 |
C8 |
|
C1 |
1 |
0.9 |
0.6 |
0.6 |
|
C4 |
0.9 |
1 |
0.6 |
0.6 |
|
C5 |
0.6 |
0.6 |
1 |
0.7 |
|
C8 |
0.6 |
0.6 |
0.7 |
1 |
[표 4]서로 닮은 관계
이것도 max-min 연산의 하나이다. 그렇게 하면 표 8에서 표9이 얻어진다.
이처럼 대칭적, 반사적이며 동시에 추이적인 퍼지관계는 특히 유사관계(Similarity Relation)라고 부른다. 표 9의 유사관계에서 다음과 같은 사실을 알 수 있다. 0.6 이상의 관련도의 것은 하나의 그룹이라고 생각하면 C1, C4, C5, C8 전부가 하나의 그룹에 들어가버린다는 사실이다.
그러면 0.7 이상의 강도라고 하면 C1, C4 및 C5, C8 이 그룹을 만들어 크게 둘러 나뉘어진다. 마찬가지로 0.9 이상, 1 이상으로 하면 그룹을 셋 그리고 넷으로 각각 나뉘어진다. 이 모양은 그림 23에 나타나 있다.
그림에서 a는 분류하기 위한 관련도의 세기를 나타낸다. 이것은 그림 2에서 a 이상의 가지만을 남겨 다른 것은 사라져 버린 대에 서로 연결되어 있는 것을 친구로 하여 하나의 그룹으로 한 것이다.
그림 23에서 알 수 있는 것은 예컨데 관련도를 0.7로 보면 I 학생에 있어서 앙케이트의 각 항목간의 관계는 다음과 같이 된다. 퍼스컴은 친구다라고 하는 감각과 수학을 좋아한다고 하는 감각과는 관련이 잇으며, 그리고 커피는 레귤러에 한 한다고 하는 감각과 관혼상제의 의리는 저버리지 않는다는 감각과는 관련이 있으나 이 두 그룹사이에는 관련이 없다는 결론이 된다.
이상과 같이 퍼지이론의 사고방법을 도입하면 주관적인 앙케이트 항목등의 사이에도 그룸화가 가능하며 동시에 a 의 값을 작게 할수록 대략적으로 분류되어 질 수가 있다.
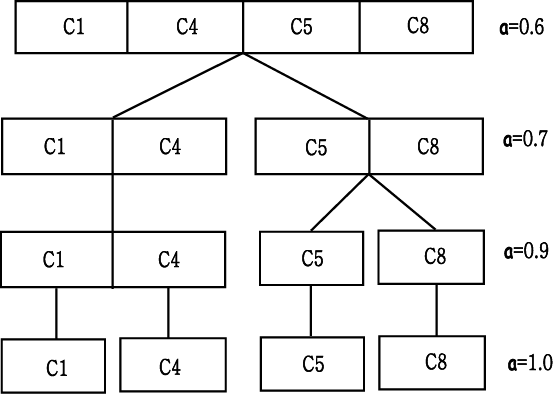
<그림 14> 앙케이트의 그룹화
데이터베이스란 컴퓨터로 읽을 수 있도록 되어 있는 데이터의 집합이다.
작은 것은 퍼스컴에서 움직이는 개인용의 주소록에서부터 큰 것은 신문기사의 검색서비스나 과학기술정보센터 등에서 하고 있는 학술잡지의 문헌 검색시스템 등이 있다. 후자인 시스템은 계약을 맺으면 퍼스컴 등의 단말기를 이용해서 전화통신선 등을 경유해 어디서든지 이용할 수가 있도록 되어 있는 것은 주지의 사실이다.
데이터베이스는 고도정보사회를 구성하는 중요한 사회기반의 하나가 되고 있다.
그에 관련된 데이터를 데이터베이스 중 대량의 데이터 속에서 찾아 내는 것이다.
현재 데이터베이스의 대부분은 입력된 키워드와 동일한 항목이 나와 있는 기사나 문헌을 찾아내는 것이다. 그 중에는 키워드의 관련표를 가지고 있어 입력된 미워드에 대해 먼저 관련된 키워드를 찾아 그들 키워드도 포함되어 있는 듯한 데이터도 출력하는 시스팀이 있기는 하나 그것은 일반적인 것은 아니다.
아무튼 지금까지의 데이터베이스는 키워드와 일치하는 항목이 있느냐 없느냐의 어느 하나라고 하는 두값의 원리로 움직이고 있음은 확실하다.
키워드는 단순한 기호로써 사용되고 있을 뿐, 그 의미가 고려되지 않고 있다. 단 기워드의 관련표라는 것은 기계조작에는 상당한 의미를 갖고 있다. 아무튼 우리들이 일상에 사용하고 있는 애매한 정보는 지금까지의 데이터베이스로는 취급할 수가 없다.
그렇다면 데이터베이스에 퍼지이론의 사고방법을 도입해 보자.
성명과 연령, 직업 일람표가 있다고 치자(그림 15). 지금까지의 방법대로라면 성명을 넣으면 연령과 직업이, 또는 연령이나 직업을 넣으면 성명 일람표가 출력된다 이와 같은 방법에서 '젊고 지적인 직업인'을 찾고 싶다고 하자. 지적이란 것과 젊다는 것은 언어로서 데이터베이스에는 나타나지 않음으로 키워드로써 사용할 수가 없다. 지적이니 젊다느니 하는 말은 주관에 따라 달라지는 애매한 정보이다.
|
성명 |
연령 |
직업 |
|
A1 |
15 |
학 생 |
|
A2 |
60 |
사 장 |
|
A3 |
20 |
세일즈맨 |
|
A4 |
28 |
기 술 자 |
|
A5 |
30 |
교 사 |
<그림 15> 기본 데이터
이와 같은 예를 <그림 16>에서 퍼지이론의 생각하는 방법을 도입, 퍼지데이터베이스의 구성예를 소개한다. <그림 16>에서 기본 데이터라고 표시되어 있는 것이 주어진 데이터의 일람표(그림15)를 나타내고 있다. 통상 데이터베이스라도 문의를 해석하기 위한 관리 시스팀이 있는 반면에 퍼지데이터베이스는 해석용 데이터라는 것이 새롭게 추가된다.
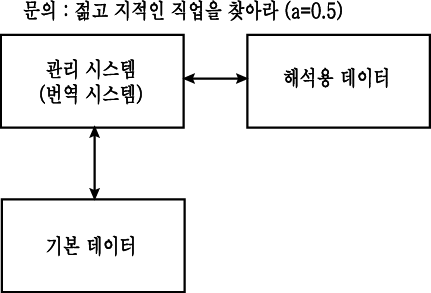
<그림 16> 퍼지데이터베이스의 예
관리시스템에서는 '젊고 지적인 직업인을 찾아라' 라고 하는 요구가 있을 때 젊다고 하는 언어가 연령이라고 하는 집합상의 퍼지집합이며 지적인 직업이라고 하는 말이 직업이라고 하는 집합상의 퍼지집합이라는 것을 알 수 있다(실제 요구는 연령=젊다, 직업=지적집업 등과 같이 적는다). 다음에 젊다라든지 지적직업을 해석용 데이터 중에서 찾는다.
여기에는 각각의 퍼지집합의 멤버십함수가 <그림 17>처럼 기억되어 있다. 연령과 같이 연속적으로 소속척도가 바뀌는 멤버십함수에서는 일반적으로 <그림 17>(a) 처럼 대표점에 대한 수치만을 표시해 두고, 도중의 점에 대한 값은 線形補間이라 하여, 그 점을 포함하는 양끝의 점을 수치에서 비례계산하는 것이 보통이다.
|
연령 |
μ |
|
직 업 |
μ |
|
0 |
1 |
|
사 장 |
0.6 |
|
20 |
1 |
|
세일즈맨 |
0.3 |
|
25 |
0.8 |
|
기 술 자 |
0.8 |
|
30 |
0.5 |
|
교 사 |
0.9 |
|
35 |
0 |
|
학 생 |
0.5 |
|
(a) 젊다 |
|
(b) 지적직업 |
||
<그림 17> 번역용 데이터멤버십관수
기본데이터의 각 사람에 대해 젊고 지적인 직업의 척도를 계산해 보자.
A 씨는 15세 이니까 젊다고 하는 멤버십함수의 값은 <그림 17(a) 에 의해 1이 된다. 학생이기 때문에 지적인 직업이라고 하는 면에서는 <그림 17>(b)에서 0.5가 된다. 젊고 지적인 직업이란 젊고 동시에 지적인 직업이란 의미이다. '동시에' 에 상당하는 연산은 단순히 작은 쪽을 취한다는 것이 되기 때문에 A1 씨의 이 요구에 대한 일치도는 1과 0.5의 작은 쪽이니깐 0.5가 된다 A2씨에 대해서는 젊다고 하는 소속도가 0이기 때문에 결과는 곧 0이다.
마찬가지로 A3, A4 및 A5 씨는 각각 0.3, 0.62 및 0.5가 된다.
A4 28 기술자 0.62 A5 30 교 사 0.5 A1 15 학 생 0.5
<그림 18> 문의에 대한 회답 |
A4씨가 0.62가 되는 것은 연령 28세의 소속도를 <그림 17>(a)에서 線形補間에서 구한 값이다.
그럼 이제 출력을 보자. 성명, 연령 및 직업과 함께 출력해 보면, <그림 16>의 요구에서 a=0.5 라고 표기되어 있는 것은 일치도가 0.5이상의 것을 출력하라는 것이다. 이 값은 자유로이 설정할 수 있다 그러므로 이 경우의 답은 <그림 18>과 같이 일치도의 크기순에 따라 세가지로 출력되어 A4가 0.62로 가장 일치도가 높은 것을 알 수 있다.
이상, 극히 간단한 예로 퍼지데이터베이스의 사고방법을 소개했다. 그러면 해석용 데이터 정의를 누가 내리는가를 생각해 보자. 물론 사용자가 개인의 주관에 의해 임의로 정해도 되는 것이다. 일반적으로는 표준인 해석용 데이터는 준비해 두고 사용하는 사람에 따라 마음에 들지 않으면 자유로이 바꿔도 된다. 또한 해석용 데이터에 쓰고 싶은 언어에 대한 퍼지집합이 입력되어 있지 않을 때는 추가설정이 가능하도록 해 둘 수 있다.
여기서 소개한 퍼지데이터베이스는 명확한 데이터로 구성되어 있는 종래의 데이터베이스(그림 15의 기본 데이터)를 개인의 주관에 의해 달라지는 안경(그림 16에서는 해석용 데이터)으로 바라보는 것처럼 볼 수가 있다. 그러므로 개인용 안경으로써 해석용 데이터만을 바꾸면 그 사람에게 맞는 것 같은 해석이 되는 데이터베이스를 구축할 수 있게 되는 것이다.
오히려 이 예에서는 기본 데이터는 종래의 데이터베이스, 즉 각 항목의 내용은 크리습 데이터로 했으나 예를 들어 연령의 항목에 15세라고 적는 대신 '매우 젊다'라든지 30세 대신에 '중년' 이라고 하는 것처럼 퍼지 집합으로 나타내어진 퍼지 데이터로 표기하는 것도 생각할 수 있다. 사실 이와 같은 퍼지 데이터베이스도 얻어지고 있다.
이 경우 데이터의 일치도는 퍼지 집합끼리의 일치도로 되는 것은 물론이다.
사회과학분야에도 응용이 가능한 간단한 아이디어를 퍼지이론의 일치성이라고 말하는 단순방식으로 처리한 例로써 소개해 왔다. 실제로 이를 응용하는 것은 다소 복잡하여서 엄밀한 이론에 바탕을 두고 있다.
공학 또는 의학관계 이외의 분야에서 현재까지 보고되어 있는 퍼지이론외 응용분야에는 경제학, 사회학, 경영학, 심리학 및 언어학 등이 있다. 각 분야의 공통점은 애매한 환경 하에서의 의사결정, 애매한 대상, 애매한 모델과 애매구조의 결정 등이다.
의사결정에는 오퍼레이션즈 리서치(OR)의 분야에서 종래의 크리습한 집합론에 기초한 수법이 있다. 예컨데 線形계획법(LP)이나 多殷 결정문제의 해결방법인 動的계획법(DP)등을 들 수 있다.
한편 확률론에 기초한 모델 化法에도 回歸모델이나 時계열모델을 위한 이론 및 수량화이론등이 있으며, 이들 手法에는 이미 퍼지이론의 사고방법이 도입되어 각각 퍼지 線形계획법, 퍼지動的계획법, 퍼지 回歸모델, 時계열모델 및 퍼지수량화 이론등이 개발되고 있다.
예를 들면 퍼지선형 계획법은 가장 일찍부터 퍼지화된 이론의 하나이다. 종래의 선형계획법에서는 <그림 19>(a) 와 같이 어떤 주어진 제약 조건 하에서 (예컨대 1천만원 이내의 투자로)최적의(예컨대 최대수익인)답을 구하라는 것 등이다.
우리들의 일상 생활에서 제약조건이란 일반적으로 그렇게 엄격히 정해진 것은 아니다. 1천만원 이내라는 개념은 대부분 대략 1천만원이내라고 하는 의미를 갖고 있다. 그러므로 제약조건의 경계를 퍼지로 하여 제약조건으로부터 멀어짐에 따라 만족도가 떨어져가는 것 같은 퍼지 제약조건으로 인해 <그림 19>(b)와 같이 목표도 퍼지목표로 하면 우리들의 감각에 조금이라도 가까워질 수 있을 것이다. 이것이 퍼지 線形계획법의 사고방법이다.
퍼지 線形계획법은 실제로 독일에서 대기오염의 규제에 응용했다고 한다. 이러한 퍼지의 사고방법을 도입한 각종 이론은 그와 같은 이론이 개발되었다(더구나 공학자에 의해 개발된 예가 많음)는 것만 있지 실제의 응용되었다는 보고는 그다지 많지 않다.
그래도 경제학, 경영학(특히 마케팅) 및 심리학 등의 분야에서는 구매 요인 분석, 잠재의식의 구조분석, 階層 귀속의식의 분석 그리고 집단 내의 인간관계 등에 응용했다는 보고가 있다. 이 밖에도 퍼지 예측이나 퍼지 클래스털링 (그룹나누기)을 사용한 응용사례의 보고도 있으나 본격적인 응용은 아직 걸음마 단계일 뿐이라고 말할 수 있다.
앞에서 말한 바와 같이 퍼지이론의 생각하는 방법은 사회과학의 분야로 치중되고 있는 것으로 생각된다 때문에 퍼지이론의 장점과 단점을 이해함으로써 사회·인문과학까지 넓게 사용되기를 바라는 마음이다.
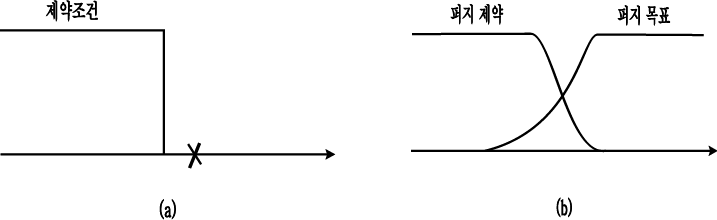
<그림 19> 퍼지결정

