1 반복적 깊이증가 탐색(IDDFS)이란 무엇인가?
BFS의 메모리 폭발 문제와 DFS의 무한 루프·비최적성 한계를 동시에 극복한 무정보 탐색의 표준 해법
인공지능의 고전적 무정보 탐색(Uninformed Search)에서 연구자들은 오랜 기간 "공간(메모리) 복잡도"와 "시간 및 최적성(Completeness & Optimality)" 사이의 치명적인 상충관계(Trade-off)에 직면해 왔습니다:
- • 장점: 해가 존재하면 반드시 찾아내며(완전성), 스텝 비용이 동일할 때 가장 얕은 최단 경로의 최적해를 보장합니다.
- • 치명적 결함: 큐(FIFO Queue)에 프론티어 전체를 저장해야 하므로 공간 복잡도가 O(bd)로 지수적 폭발을 일으켜 현실 문제에서 컴퓨터 RAM이 고갈됩니다.
- • 장점: 오직 현재 탐색 중인 경로(Stack)의 노드들만 기억하므로 공간 복잡도가 O(b × m)으로 매우 가볍습니다.
- • 치명적 결함: 무한 루프(순환 경로)에 빠지거나, 얕은 깊이에 더 좋은 해가 있음에도 엉뚱한 깊은 경로를 헤매어 최적해를 찾지 못합니다.
💡 IDDFS의 독창적인 해결책: 깊이 제한의 점진적 확장
반복적 깊이증가 탐색(Iterative Deepening Search, IDS)은 깊이 우선 탐색(DFS)의 가벼운 메모리 구조를 그대로 채택하면서, 탐색 깊이 한계선인 Limit = 0, 1, 2, 3, ...을 1씩 점진적으로 늘려나갑니다. 각 한계선마다 루트 노드부터 새로이 깊이 제한 탐색(DLS)을 수행함으로써, BFS의 완전성과 최적성을 100% 달성하면서도 메모리는 DFS처럼 O(b × d) 선형 크기만 사용하는 기적적인 조화를 이루어냅니다.
2 원본 학습 자료 및 단계별 탐색 과정 도해
클래식 AI 연구 자료에 수록된 반복적 깊이증가 탐색 과정 도면과 상세 구조 분석
📷 원본 보존 도해: 반복적 깊이증가 탐색 과정 (Iterative Deepening Process)
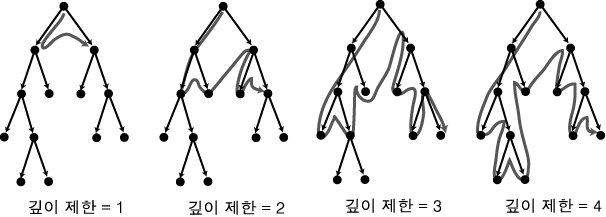
[그림] 깊이 제한(Limit)을 0부터 1씩 증가시키며 계층별로 루트에서부터 DFS를 반복 확장하는 구조
반복적 깊이증가(IDDFS)의 단계별 실행 메커니즘
Limit = 0
오직 루트 노드(Root)만 검사합니다. 루트가 목표(Goal)인지 확인 후 목표가 아니면 탐색을 종료하고 한계선을 올립니다.
Limit = 1
루트 노드에서 출발하여 깊이 1의 모든 직계 자식 노드들을 DFS 순서로 탐색합니다. 목표를 못 찾으면 이전 상태를 버립니다.
Limit = 2
다시 루트부터 시작하여 깊이 2의 모든 손자 노드들까지 DFS로 파고듭니다. 깊이 2를 넘는 노드는 잘라내고(Pruning) 백트래킹합니다.
Limit = d
마침내 목표 노드가 존재하는 깊이 d에 도달하면, 가장 얕은 위치의 목표를 즉시 발견하고 최적 경로를 반환하며 즉각 성공 종료합니다.
3 수학적 증명: "중복 방문의 역설"과 놀라운 연산 효율성
루트와 상위 노드를 매 반복마다 다시 탐색하는데 왜 시간적 낭비가 거의 없는가?
IDDFS를 처음 접할 때 대부분의 개발자와 학생들은 "매번 깊이 제한을 늘릴 때마다 처음부터 다시 탐색하면 엄청난 중복 연산(Overhead)으로 너무 느리지 않을까?"라는 직관적인 의구심을 품습니다. 그러나 상태 공간 트리가 지수적으로 팽창하는 기하급수적 구조(Branching Factor b ≥ 2)에서는 놀랍게도 상위 노드의 재방문 비용이 전체 탐색의 극히 일부에 불과합니다.
📐 노드 생성 횟수의 수학적 유도 (분기 계수 b, 목표 깊이 d)
📊 실제 수치 계산 비교: 분기 계수 b = 10, 목표 깊이 d = 5 일 때
| 탐색 깊이 (Level) | 해당 레벨의 노드 수 | 너비 우선 탐색 (BFS) 노드 생성 | 반복 깊이증가 탐색 (IDDFS) 노드 생성 |
|---|---|---|---|
| Level 1 | 101 = 10 | 10 | 5 × 10 = 50 |
| Level 2 | 102 = 100 | 100 | 4 × 100 = 400 |
| Level 3 | 103 = 1,000 | 1,000 | 3 × 1,000 = 3,000 |
| Level 4 | 104 = 10,000 | 10,000 | 2 × 10,000 = 20,000 |
| Level 5 (목표) | 105 = 100,000 | 100,000 | 1 × 100,000 = 100,000 |
| 합계 (Total Nodes) | - | 111,110 개 | 123,450 개 |
| 소요 메모리 (상태 보관) | - | 100,000 개 (수백 MB~GB 고갈) | 단 50 개 노드 (수 KB) |
4 전통적 AI에서의 특징, 종류 및 대표적 활용 분야
컴퓨터 체스/바둑 엔진, 실시간 계획 수립, 로봇 공학 및 Anytime 알고리즘
체스나 오셀로 같은 2인 적대 게임에서 플레이어에게 주어지는 턴당 생각 시간(Time Limit)은 한정되어 있습니다. DFS는 시간을 초과하면 아무 답도 내지 못하고, BFS는 깊이 4~5에서 메모리 부족으로 뻗어버립니다.
하지만 IDDFS를 사용하면 언제 시간이 종료되더라도 직전 반복(Iteration)에서 완전히 계산해 둔 최선의 수(Best Move)를 즉시 반환할 수 있습니다. 이를 "Anytime Algorithm"이라 부르며, 딥블루(Deep Blue) 등 고전 체스 프로그램의 게임 트리 탐색 필수 기법이었습니다.
자율 주행 로봇이나 매니퓰레이터의 작업 공간(Workspace)은 경로 길이가 사전에 정해져 있지 않습니다. 목표 상태까지 몇 단계의 액션이 필요한지 모르는 상황에서, IDDFS는 로봇이 취할 수 있는 최소 동작 횟수의 최적 동작 계획을 메모리 걱정 없이 단계적으로 찾아냅니다.
특히 비행선, 우주 탐사선 등 하드웨어 메모리가 수 메가바이트로 극도로 제한된 임베디드 AI 환경에서 최우선으로 선택되는 표준 탐색 기법입니다.
단순 깊이 제한 대신, 휴리스틱 평가 함수 f(n) = g(n) + h(n)의 한계선(Threshold)을 기준으로 삼아 반복적 깊이증가를 적용한 것이 바로 IDA* (Iterative Deepening A*)입니다.
15-퍼즐, 루빅스 큐브(Rubik's Cube)의 최적 해법을 찾을 때, 일반 A* 알고리즘은 열린 노드 집합(OPEN List)의 메모리 폭발로 풀 수 없었으나, Richard Korf 교수가 제안한 IDA*를 통해 최초로 실시간 최적해 계산에 성공하였습니다.
논리 프로그래밍 언어(Prolog)의 전통적인 실행 엔진은 순수 DFS를 사용하여 깊은 재귀나 왼쪽 재귀 규칙(Left Recursion)에서 무한 루프에 빠져 프로그램이 정지하지 않는 결함이 있었습니다.
현대 논리 엔진과 SAT/SMT Solver 및 자동 정리 증명기(Automated Theorem Provers)는 IDDFS 탐색 전략을 도입하여 유한한 단계 안에서 가장 짧은 수학적 증명 경로를 반드시 찾아내도록 보장합니다.
5 최신 LLM과 인공지능 에이전트에서 IDDFS의 진화와 결정적 중요성
사고의 사슬(CoT)을 넘어선 테스트 시간 계산 확장(Test-Time Compute Scaling)과 적응형 심층 추론(Adaptive Deep Reasoning)
2024~2026년 인공지능 분야의 가장 거대한 패러다임 전환은 "사전 학습(Pre-training) 규모 확장"에서 "추론 시점 계산량 확장(Inference-Time / Test-Time Compute Scaling)"으로 이동한 것입니다. OpenAI o1/o3, DeepSeek-R1, Google Gemini 2.0 Thinking 모델 등은 단번에 답을 출력하는 대신, 내부적으로 복잡한 탐색 과정을 수행합니다. 여기서 고전 AI의 반복적 깊이증가(IDDFS) 원리는 가장 본질적이고 현대적인 형태로 부활하였습니다.
모든 질의에 동일한 수만 개의 추론 토큰을 소모하는 것은 극도로 비효율적입니다. 현대 LLM은 IDDFS처럼 추론 깊이(Reasoning Depth)를 점진적으로 심화합니다:
쉬운 문제는 얕은 깊이(Depth 1)에서 즉시 출력하고, 난해한 올림피아드 수학 문제는 깊이를 증분시켜 최고 난도의 검증을 완수한 후 답변합니다.
사용자와 상호작용하는 자율 에이전트(Autonomous AI Agents)는 웹 브라우징, 도구 호출(Tool Calling), API 연동 시 응답 지연(Timeout) 제약에 직면합니다.
순수 DFS형 에이전트는 하나의 복잡한 하위 태스크 토끼굴에 빠져 전체 프로세스가 멈추고, BFS형 에이전트는 동시 다발적 툴 호출로 API Rate Limit을 초과합니다. IDDFS 기반 에이전트는 전체 계획을 1차 개요 → 2차 세부 액션 → 3차 정밀 실행으로 점진 구체화하므로, 언제 인터럽트가 발생하더라도 현재 깊이까지 완성된 최선의 플랜을 즉각 제공합니다.
Tree of Thoughts(ToT) 프레임워크에서 거대 언어 모델은 여러 사고 경로를 분기시킵니다. 이때 무한정 가지를 뻗으면 조합적 폭발이 일어나 GPU VRAM이 바닥납니다.
최신 시스템은 반복적 깊이증가 게이팅(IDDFS Gating)을 적용합니다. 모든 유망 사고를 깊이 1에서 짧게 생성해 가치 평가 모델(PRM: Process Reward Model)로 스코어링한 뒤, 합격점을 받은 경로에 대해서만 깊이 한도를 늘려 심층 추론을 전개합니다.
트랜스포머 모델의 자기주의(Self-Attention) 메커니즘에서 Key-Value(KV) 캐시는 시퀀스 길이가 길어질수록 GPU 메모리를 막대하게 점유합니다.
수십 개의 병렬 사고 체인을 동시에 메모리에 띄우는 빔 서치(Beam Search)는 80GB H100 GPU에서도 곧바로 OOM(Out of Memory)을 일으킵니다. 반면 IDDFS 방식은 단일한 추론 스택만을 유지하며 깊이를 늘려가므로 선형적 메모리 O(T)만을 소비하여 초대형 모델의 긴 호흡 추론을 가능케 합니다.
🎯 LLM에서 IDDFS가 왜 결정적으로 중요한가? (핵심 가치 요약)
과거의 IDDFS가 "제한된 컴퓨터 RAM 속에서 어떻게 최단 경로를 찾을 것인가"의 문제였다면, 최신 LLM에서의 IDDFS는 "한정된 추론 시간과 비용(토큰) 예산 속에서 어떻게 환각을 방지하고 수학적·논리적 신뢰성을 극대화할 것인가"의 문제로 치환되었습니다. 문제를 대하는 깊이를 0단계(상식적 직관)에서부터 단계적으로 확장하며 자기 비판(Self-Critique)과 검증을 누적하는 IDDFS 철학은 인공 일반 지능(AGI)으로 향하는 추론 모델의 핵심 기틀입니다.
6 전통 무정보 탐색 알고리즘 핵심 비교표
BFS, DFS, 깊이 제한 탐색(DLS), 반복적 깊이증가 탐색(IDDFS), 양방향 탐색의 특성 완벽 비교
| 탐색 알고리즘 | 완전성 (Completeness) | 최적성 (Optimality) | 시간 복잡도 | 공간 복잡도 (메모리) | 주요 장단점 및 특성 |
|---|---|---|---|---|---|
| 너비 우선 (BFS) | 예 (b 유한 시) | 예 (비용 동일 시) | O(bd) | O(bd) [지수적] | 최단 해 보장하나 메모리가 조기 고갈됨 |
| 깊이 우선 (DFS) | 아니오 (무한 경로) | 아니오 | O(bm) | O(b × m) [선형] | 메모리가 가벼우나 무한 루프 위험 및 최적해 미보장 |
| 깊이 제한 (DLS) | 아니오 (l < d 시) | 아니오 | O(bl) | O(b × l) [선형] | 무한 루프는 방지하나 제한값 l을 모르면 해를 못 찾음 |
| 반복적 깊이증가 (IDDFS) | 예 (b 유한 시) | 예 (비용 동일 시) | O(bd) | O(b × d) [선형] | BFS의 완전성/최적성 + DFS의 선형 메모리 완벽 결합 |
| 양방향 탐색 (Bidirectional) | 예 | 예 | O(bd/2) | O(bd/2) | 탐색 시간을 대폭 단축하나 역방향 연산자 및 목표 상태 정의 필요 |
* 표 표기 안내: b = 분기 계수(Branching factor), d = 최적 목표 노드의 깊이, m = 상태 공간 트리의 최대 깊이, l = 깊이 제한값
7 IDDFS 핵심 알고리즘 구현 (Python & 의사코드)
루프 기반 반복 깊이 증가와 재귀적 깊이 제한 탐색(DLS)의 깔끔한 구현 코드
# Iterative Deepening Depth-First Search (IDDFS) Python Implementation
def iterative_deepening_search(root, is_goal_func, max_depth=1000):
    """
    깊이 한계를 0부터 1씩 증가시키며 목표 상태를 탐색하는 IDDFS 메인 함수
    """
    for depth in range(max_depth):
        result, remaining = depth_limited_search(root, is_goal_func, depth)
        if result is not None:
            return result  # 최단 경로 최적해 발견 성공!
        if not remaining:
            return None    # 트리 전체를 탐색했으나 해가 없음
    return None

def depth_limited_search(node, is_goal_func, limit):
    """
    주어진 limit까지만 재귀적으로 파고드는 깊이 제한 탐색 (DLS)
    """
    if is_goal_func(node):
        return (node, True)
    if limit <= 0:
        return (None, True)  # 더 깊은 서브트리가 존재할 수 있음을 알림

    any_remaining = False
    for child in node.get_children():
        result, remaining = depth_limited_search(child, is_goal_func, limit - 1)
        if result is not None:
            return (result, True)
        if remaining:
            any_remaining = True

    return (None, any_remaining)
이 구현에서 확인할 수 있듯, depth_limited_search는 호출 스택(Call Stack) 상에 오직 현재 탐색 중인 경로(최대 깊이 limit)의 노드들만 유지하므로 시스템 메모리를 지극히 적게 소모합니다.
8 멀티미디어 강의 & 원문 학술 레퍼런스
하버드/MIT 석학들의 정규 AI 강좌와 스튜어트 러셀, 닐스 닐슨 교수의 원문 학습 자료
Harvard CS50 AI - Search Algorithms (IDS & DFS)
탐색의 기본 원리, BFS vs DFS의 한계와 Iterative Deepening의 실전 활용을 직관적으로 설명하는 하버드 대학 정규 강의
Iterative Deepening Search (IDDFS) 동작 구조 해설
그래프와 트리에서 레벨별 탐색 반복 및 노드 생성 수식 오버헤드를 세부적으로 시각화한 튜토리얼
AI 탐색 알고리즘 시리즈 함께 보기
무정보 탐색부터 휴리스틱 정보 탐색, 게임 트리 적대 탐색까지 단계별로 완전 정복하세요.