SECTION 01 · OVERVIEW
1. 발견에 의한 학습(Learning by Discovery)의 본질과 목표
지금까지의 machine learning 과정은 대부분 외부의 안내자 (Tutor) 가 단서를 주거나 또는 문제해결 방법을 추적하는 내부적인 과정에 의해 정보를 얻어 지식을 구축하는 형태이다. 그러나 오직 관찰과 실험을 통해 현상의 규칙성을 파악해야 하는 상황이 많이 발생한다. 이러한 것은 과학자들이 새로운 사실이나 이론을 발견하는데서 많이 찾아 볼 수 있는 방법이다. 새로운 분류법이 형성이나 관찰된 데이터의 규칙성을 통해 어떤 법칙을 발견하는 것이 바로 발견에 의한 학습 (Learning by Discovery) 의 주요 목표이다. 이에는 분류법형성과 개념적 집단화방법과 규칙의 발견방법 등이 포함된다.
💡 지도학습(Supervised Learning)과의 근본적 차이
기존의 지도학습(예: 퍼셉트론, 역전파 신경망, 의사결정 트리)은 정답 레이블(Target Class)이 사전에 부여된 훈련 데이터를 필요로 합니다. 반면, 발견에 의한 학습은 정답을 알려주는 외부 교사(Teacher)가 부재한 상태에서, 데이터 자체에 내재된 잠재적 패턴, 대칭성, 상관성 및 불변량을 스스로 파악하여 새로운 개념(Concept)과 자연 법칙(Empirical Laws)을 능동적으로 도출해 냅니다.
SECTION 02 · TAXONOMY FORMATION
2. 분류법 형성과 개념적 집단화 (Conceptual Clustering)
우리는 무수히 주어지는 객체들을 어떤 기준으로 분류하지 않으면 학문의 발전이 이루어지기 힘들다는 것을 안다. 예를 들어, 생물에 대한 이해를 증진하기 위해 우리는 무수한 생명체를 크게 동물과 식물, 그리고 동물을 다시 포유류, 조류, 어류 등의 하위클래스로 나누게 된다. 우리에게 주어진 관찰대상이 그림 13 에 제시된 어떤 세포라고 하자. 각 세포는 핵과 꼬리의 두 개의 부분으로 구성되어 있으며, 각각은 핵을 한 개 혹은 두 개, 그리고 꼬리를 한 개 혹은 두 개를 가지고 있다. 이러한 세포들을 어떤 기준으로 분류할 것인가. 우리의 목표는 분류기준을 세우는 것이다. 그리고 나서 그 분류된 무리에 대해 어떤 이름을 부여할 것이다.
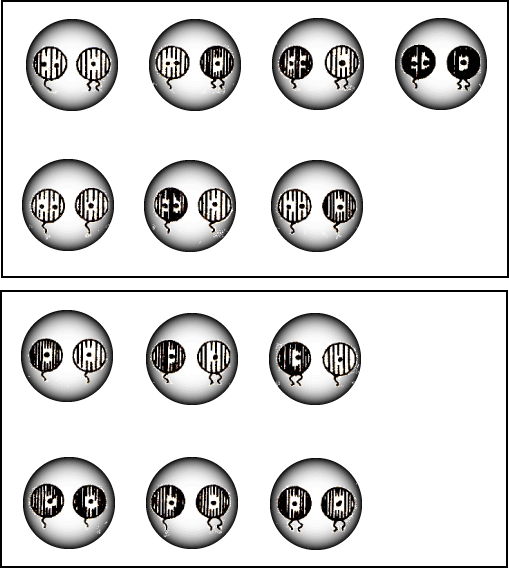
[그림 13] 분류법 형성문제 (Taxonomy Formation Problem) : 핵과 꼬리의 속성을 가진 세포 데이터 집합
여러 가지 방법으로 분류할 수 있겠으나 그림 14 는 하나의 분류형태를 계층적으로 나타내고 있다.
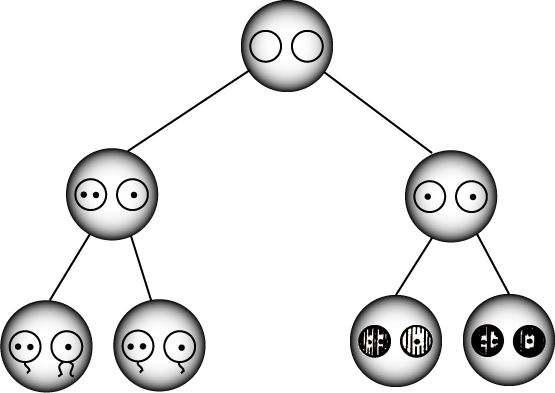
[그림 14] 분류계층 (Taxonomy Hierarchy) : 세포들의 속성 테스트에 따른 탑-다운 계층적 분류 구조
가장 위 분류는 주어진 세포들 전체로 구성되며 이는 크게 두 개의 부분으로 나눌 수 있다. 그리고 그 하위분류로써 핵이 두 개와 한 개로 되어 있는 세포와 각기 한 개의 핵을 가지는 세포로 분류된다. 그리고 전자는 꼬리개수의 조합에 따라 분류되고 후자는 색깔에 따라 분류되고 있다. 이러한 과정을 분류법의 형성 (Taxonomy Formation) 혹은 개념적 집단화 (Conceptual Clustering) 라 하는데 이를 위한 방법으로 여러 가지 연구가 진행되어 왔다.
Fisher의 RUMMAGE 알고리즘과 ID3와의 비교
여기서는 Fisher [85] 가 개발한 RUMMAGE 란 방법론을 소개한다. RUMMAGE 는 대상이 되는 객체를 특성 - 값 (Attribute-value) 의 조합으로 표현한다. 그리고 이들 특성값으로부터 분류에 필요한 정보를 얻는다. 다음은 RUMMAGE 가 취한 개념적 집단화의 과정이다.
1
분류계층의 가장 위 노드(Root Node)를 생성한다.
2
각 특성에 대해서 그 특성값에 따라 객체들을 정렬한다.
3
특성의 각 값에 따라 해당값을 가지는 객체에 대한 개념을 기술한다.
4
개념기술 중에 가장 "좋은", 즉 가장 간단하고 집단간에 유사성을 가장 작게하는 개념기술 (Concept Description) 을 선택하여 해당 특성을 선정한다.
5
이 특성에 따라 객체들을 분류하여 가지(Branch)를 형성하여 자식노드(Child Node)를 생성한다.
6
이러한 과정을 반복하여 어떤 기준 이하로 분류의 가치가 떨어질 때 중단한다.
이러한 과정은 ID3 (의사결정 트리) 와 유사한 점이 많으나 ID3 와 다른 점은 ID3 는 객체를 나타낼 때 특성과 값 외에도 외부에서 미리 주어진 클래스가 부여되나 RUMMAGE 는 이러한 클래스에 관한 기술을 스스로 생성하고 있다는 것이다. 그러나 이 두 가지 모두 트리형태의 표현과 탑-다운 (Top-down) 형태의 전개과정을 사용하고 있다는 점에서는 같다. 그러나 RUMMAGE 는 각 브랜치 (Branch) 를 형성할 때 오직 하나의 특성만을 기준으로 하고 있기 때문에 표현상 한계를 지니고 있다.
🌲 지도형 결정 트리 (ID3 / C4.5)
사전에 부여된 목표 클래스(예: 간염 여부, 생존/사망 등)를 구별하기 위해 엔트로피와 정보 이득을 계산하여 최적의 속성을 분할 기준으로 선택합니다.
💡 개념적 집단화 (RUMMAGE / COBWEB)
목표 클래스가 존재하지 않으며, 집단 간 유사성은 최소화하고 집단 내 유사성은 최대화하는 설명 가능한 개념(Concept)을 시스템이 자율적으로 정의합니다.
SECTION 03 · SCIENTIFIC DISCOVERY
3. 규칙 및 과학적 법칙의 발견 (Empirical Law Discovery)
새로운 수학적 법칙이나 화학반응의 법칙 등을 발견하는 과정은 어떤 규칙성의 관찰이나 흥미있는 현상의 탐구 속에서 이루어진다. 이러한 분야에 대한 연구는 그리 많지 않으나 여기서는 인공지능 역사상 가장 기념비적인 두 시스템인 AM 과 BACON.4 에 대해서 소개한다.
🧮 1) 더글러스 레넛의 AM (Automated Mathematician) — 수 이론(Number Theory)의 자율 탐구
Lenat [83] 의 AM 은 수 이론 (Number Theory) 을 대상 영역으로 한다. AM 은 미리 수백 개의 기본개념, 예를 들어 집합에 대한 소속의 개념 (Set membership), 합집합의 개념 (Set union) 등의 개념들이 미리 주어진 상태에서 출발한다. 또한 이 외에도 새로운 개념을 제시하고 추측하며, 데이터를 모으고, 무엇이 흥미있는 개념인지를 결정할 수 있는 수백 개의 휴리스틱이 주어진다.
예를 들어, 한 휴리스틱은 어떤 개념이 그 예가 불과 몇 개 안될 때 (그러나 한 개 보다는 많음) 이를 흥미있다고 판단한다. 만약에 어떤 개념에 대한 예가 너무 없을 경우에는 AM 은 그 개념을 좀더 일반화시키고, 너무 흔하다면 좀더 구체화시킨다. 또한 서로 다른 경로에 의해 도출된 것이 같은 개념이라고 할 때 이를 흥미있다고 하고 다음 새로운 개념을 도출하기 위한 재료로서 우선권을 부여한다.
AM 은 수리적 개념공간을 흥미의 정도에 따라 탐색하게 된다. AM 은 이러한 기본개념과 휴리스틱을 바탕으로 여러 재미있는 개념들을 도출하였다. 예를 들어, 정수라든지 덧셈, 곱셈, 인수, 소수(Prime Number)와 같은 것이다. 또한 AM 은 모든 정수는 소수의 곱으로 유일하게 표현될 수 있다는 것 (산술의 기본 정리) 과, 모든 정수는 두 개의 소수의 합으로 나타낼 수 있다는 사실 (골드바흐의 추측) 을 자율적으로 도출하였다.
🔬 2) 팻 랭글리 & 허버트 사이먼의 BACON.4 — 물리·화학 법칙의 자동 유도
또 다른 시스템으로서 BACON.4 (BACON 의 4 번째 버전) 는 계량적 법칙을 유도한다. 예를 들어, 변수와 그에 대한 측정치 등이 주어지면 (예를 들어 압력, 부피, 온도 등) 이 시스템은 이들 변수간의 관계에 대한 관측된 법칙을 유도한다 (예를 들어 PV/T = 8.32). BACON.4 는 물리학이나 화학의 역사에서 등장했던 여러 법칙들을 재발견하였다.
BACON 은 이러한 법칙을 발견하기 위해 일련의 데이터 수집을 체계적으로 수행한다. BACON 은 어느 시점에 하나의 독립변수를 변형시키고 그에 따른 종속변수들의 변화를 검토한다. 그리고 이들 변화간의 관계가 일정비율로 일관적인 변화가 발견될 때까지 반복하여 이들 변수들로 위의 예 (PV/T) 와 같이 일정값을 갖게 되는 새로운 변수항을 만든다. 이렇게 발견된 변수항을 상수로 두고 다시 그 다음 차원의 발견을 위해 또 다른 독립변수를 변화시킨다.
■ BACON 의 3단계 발견 휴리스틱 (Discovery Heuristics) :
1
만약 변수 (또는 변수항) X 가 상수에 가까운 값을 가질 때, X 를 포함하는 법칙을 생성한다. (불변량 생성)
2
그렇지 않은 경우, X 가 증가할 때 Y 도 증가한다면 비율 X/Y 를 새로운 변수로 보고 다시 ① 의 단계를 진행한다. (비례 관계 포착)
3
그렇지 않은 경우, X 가 증가할 때 Y 는 감소한다면 곱 XY 를 새로운 변수로 보고 다시 ① 의 단계를 진행한다. (반비례 관계 포착)
BACON 시스템은 이 단순하고 명쾌한 발견 휴리스틱을 바탕으로 케플러의 제3법칙($D^3 / P^2 = C$), 이상기체 상태방정식, 옴의 법칙, 갈릴레오의 가속도 법칙 등을 인간의 개입 없이 데이터로부터 완벽하게 재발견하였습니다.
SECTION 04 · SPECIAL ANALYSIS
4. 발견에 의한 학습이 인공지능(AI) 발전에 기여한 결정적 역할
'발견에 의한 학습(Learning by Discovery)'은 단순히 과거의 한 실험적 연구에 그치지 않고, 인공지능이 '단순한 입력-출력 매핑 기계'에서 '스스로 새로운 과학적 지식을 창출하는 지적 에이전트'로 진화하는 데 결정적인 철학적·기술적 전환점을 마련하였습니다.
🌌 1. 비지도 및 자기지도학습의 사상적 모태
초기 AI가 인간이 주입해 준 레이블과 규칙에 갇혀 있을 때, 발견 학습은 "기계가 교사 없이도 데이터의 내재적 구조(대칭성, 불변량, 통계적 규칙성)를 스스로 요약하고 범주화할 수 있다"는 가능성을 입증하였습니다. 이는 오늘날 비지도 군집화(Clustering), 오토인코더(Autoencoder), 그리고 대규모 언어모델(LLM)의 자기지도학습(Self-Supervised Learning) 패러다임으로 계승되었습니다.
🧬 2. 'AI for Science' (과학적 발견 AI)의 효시
AM과 BACON은 "과학적 발견 과정 자체가 계산적 탐색(Discovery as Search)으로 정식화될 수 있다"는 허버트 사이먼의 통찰을 구현한 최초의 사례였습니다. 이 연구는 오늘날 단백질 접힘 구조를 규명한 알파폴드(AlphaFold), 양자화학 분자 설계, 새로운 물리 법칙을 수식으로 찾는 기호 회귀(Symbolic Regression), 그리고 가설 수립부터 실험 설계·논문 작성까지 자율 수행하는 AI Scientist의 직계 조상이 되었습니다.
🧱 3. 지식 획득의 병목(Bottleneck) 해소
전문가 시스템(Expert Systems)의 치명적 한계였던 "인간 전문가가 자신의 암묵지를 일일이 기호로 기술해야 한다"는 문제를 타파하였습니다. 데이터로부터 자동으로 분류 체계(Taxonomy)와 정량적 법칙을 유도해 냄으로써, 데이터 기반 지식 획득(Automated Knowledge Acquisition)의 길을 열었습니다.
🎯 4. 휴리스틱 기반 개념 공간 탐색의 정립
모든 가능한 수학적 명제나 변수 조합은 무한에 가까워 무차별 탐색(Brute Force)이 불가능합니다. AM의 '흥미도 평가 휴리스틱(Interestingness Heuristics)'과 BACON의 '불변량 탐색 휴리스틱'은 방대한 가설 공간에서 유망한 방향만을 골라내는 발견적 탐색(Heuristic Search)의 탁월한 효용성을 증명하였습니다.
SECTION 05 · VIDEO ARCHIVE
5. 추천 강의 및 다큐멘터리 : AI와 과학적 발견 (AI for Science)
 aistudy 인공지능 & 기계학습 지식포털