전통적인 Information Theory 의 핵심 개념과 4대 기본 원리
일상어로서의 정보는 '어떤 사실에 관한 알림이나 소식'을 의미하지만, 정보이론에서 다루는 정보는 "불확실성(Uncertainty)을 해소하는 정량적 수학적 척도"입니다. 정보를 물질이나 에너지가 아닌 확률변수(Random Variable)로 취급하여, 내용의 주관적 의미와 무관하게 부호화(Encoding)와 전송 효율을 수학적으로 다룹니다.
섀넌 엔트로피 (Shannon Entropy, H)와 비트(Bit)
사건 x가 일어날 확률을 P(x)라 할 때, 그 사건이 발생했을 때 얻는 자기 정보량(Self-information)은 I(x) = -log2 P(x)로 정의됩니다. 일어날 확률이 희박한 놀라운 사건일수록 더 많은 정보량을 가집니다. 시스템 전체의 평균 불확실성인 섀넌 엔트로피 H(X) = -Σ P(x) log2 P(x)는 모든 상태를 표현하는 데 필요한 최소 평균 비트(Bit) 수이자 정보의 본질적 한계를 결정합니다.
섀넌의 제1정리 (정보원 부호화 정리, 압축 한계)
정보원에 내재된 불필요한 중복성(Redundancy)을 제거하여 본질적인 정보를 보존할 때, 아무리 이상적인 무손실 압축 알고리즘을 사용하더라도 데이터의 평균 코드 길이는 엔트로피 H(X)보다 작아질 수 없다는 불변의 수학적 정리입니다. 허프만 코딩(Huffman Coding)이나 산술 부호화(Arithmetic Coding)의 이론적 기초가 되었습니다.
섀넌의 제2정리 (잡음이 있는 채널 부호화 정리, C)
잡음(Noise)이 존재하는 통신로에서도 적절한 오류 정정 부호(Error-Correcting Code)를 적용하면 전송률 R이 채널 용량 C보다 작은 한(R < C), 오류 확률을 0에 가깝게 만들 수 있다는 혁명적 발견입니다. 대역폭 B와 신호 대 잡음비(SNR)로 채널 용량 C = B log2(1 + S/N)을 도출하였습니다.
리던던시 (Redundancy, 여분성)
모든 기호가 등확률로 무작위 발생할 때 엔트로피가 최대가 되며, 실제 언어나 신호는 특정 기호의 빈도가 높거나 앞선 기호에 의존(조건부 확률)하여 엔트로피가 감소합니다. 최대 엔트로피 대비 실제 엔트로피의 비율을 제외한 여분의 비율을 리던던시(Redundancy)라 부르며, 이것이 잡음 속에서도 문맥을 유추하고 복원할 수 있게 하는 핵심 완충 장치입니다.
섀넌의 트럼프 카드 맞추기 실험과 영어 알파벳 엔트로피
1. 트럼프 카드 맞추기 스무고개와 비트(Bit)의 물리적 직관
1비트(bit)는 두 가지의 동등한 확률을 가진 선택지 중 하나를 결정할 때 해소되는 불확실성의 크기입니다. 16장의 트럼프 카드 중 머릿속으로 점찍은 1장을 알아맞히는 과정을 생각해 봅시다.
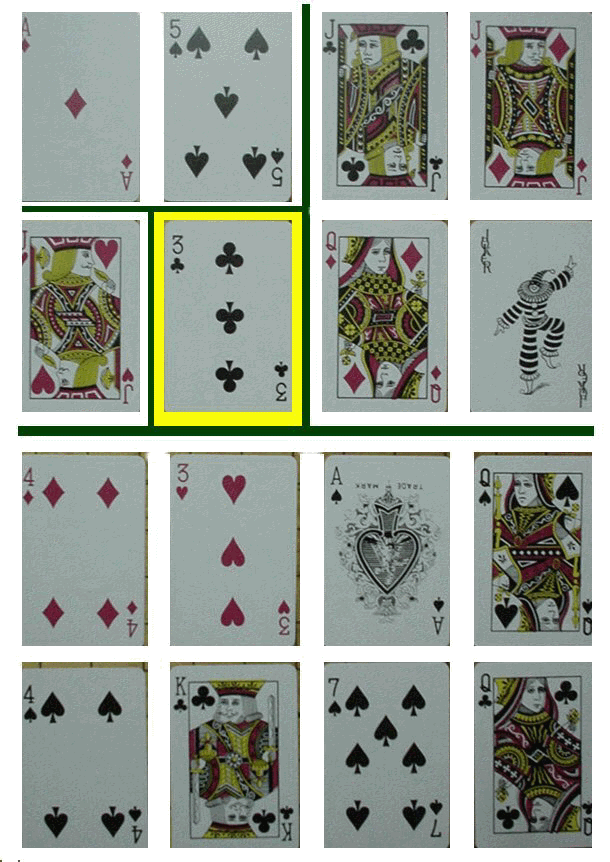
[보존 원본] 가로 세로 4장씩 배열된 16장의 트럼프 카드
Q1. "그 카드는 상단 8장에 있는가?" ➔ "예" (후보 16장 ➔ 8장 절반 감소)
Q2. "상단의 오른쪽 반에 있는가?" ➔ "아니오" (후보 8장 ➔ 4장 감소)
Q3. "왼쪽 반의 상단(1열)에 있는가?" ➔ "아니오" (후보 4장 ➔ 2장 감소)
Q4. "하단의 오른쪽에 있는가?" ➔ "예" (후보 2장 ➔ 1장 클로버 3 확정!)
16장의 카드 속에서 무작위로 1장을 알아맞힐 확률은 P = 1/16입니다. '예/아니오'의 2진 질문을 던져 공간을 절반씩 쪼개나갈 때 필요한 질문 횟수 n은 2n = 16이 되며, 이를 양변에 밑이 2인 로그를 취하면 다음과 같습니다.
즉, 16장의 불확실성을 완전히 해소하기 위해 정확히 4비트의 정보량이 필요함을 명쾌하게 보여줍니다.
2. 영어 알파벳(27문자)의 빈도 분포와 엔트로피 및 리던던시 계산
만일 영어의 26개 알파벳과 공백(총 27개 문자)이 모두 동일한 확률(1/27)로 무작위 발생한다면 엔트로피는 log2(27) = 4.755 비트에 달합니다. 그러나 실제 영어 텍스트는 문자마다 출현 확률이 크게 다릅니다.
| 문자 | 발생확률 | 문자 | 발생확률 | 문자 | 발생확률 |
|---|---|---|---|---|---|
| 공백 | 0.1859 | I | 0.0575 | R | 0.0484 |
| E | 0.1031 | N | 0.0574 | H | 0.0467 |
| T | 0.0796 | S | 0.0514 | L | 0.0321 |
| A | 0.0642 | D | 0.0317 | C | 0.0128 |
| O | 0.0632 | U | 0.0228 | Z (최저) | 0.0005 |
각 문자의 확률 p(si)에 가중치를 두어 계산한 실제 1차 근사 엔트로피는 다음과 같습니다.
H(X) = Σ p(si) log2(1 / p(si)) = 4.08 비트
상대 엔트로피 = 4.08 / 4.755 = 0.848
리던던시(Redundancy) = 1 - 0.848 = 0.152 (15.2%)
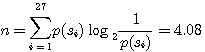
[보존 원본 수식 이미지]
W.R. 베넷의 '무한 타자기 원숭이 정리' 비유처럼, 자판기의 키 크기를 알파벳의 실제 출현 빈도에 비례하게 배치하면(리던던시 부여), 무작위 타이핑에서도 의미 있는 셰익스피어 문맥이 만들어질 확률이 극적으로 높아집니다. 나아가 "th 다음 모음", "q 다음 u"처럼 문맥 조건부 확률(N-gram 및 트랜스포머 주의 집중)을 고려하면 언어의 실제 엔트로피는 문자당 1.0~1.5비트 수준까지 감소합니다.
AI 발전에 미친 영향과 머신러닝에서 활용되는 4대 수학 개념
정보이론은 오늘날 인공지능과 머신러닝의 "목적함수(Loss Function) 설계, 데이터 표현 학습, 그리고 모델 평가"의 공통 수학 언어로 기능합니다. 모델이 학습한다는 것은 곧 데이터의 확률 분포와 모델 예측 분포 사이의 정보학적 거리를 좁혀가는 과정입니다.
교차 엔트로피 (Cross-Entropy, H(P, Q))
실제 정답 데이터 분포 P를 모델의 예측 확률 분포 Q로 부호화할 때 필요한 평균 비트 수입니다. H(P, Q) = -Σ P(x) log Q(x)로 정의되며, 이미지 분류(Softmax Classification)부터 LLM의 다음 토큰 생성 손실까지 현대 딥러닝 최적화의 90% 이상에서 표준 손실함수로 쓰입니다.
쿨백-라이블러 발산 (KL Divergence, DKL)
두 확률 분포 P와 Q 사이의 정보학적 차이(상대 엔트로피)를 측정합니다. DKL(P || Q) = Σ P(x) log [P(x) / Q(x)] = H(P, Q) - H(P). VAE(변분 오토인코더)의 잠재 공간 정규화, 확산 모델(Diffusion)의 시간역전 오차 측정, 강화학습의 정책 업데이트 제약(PPO/TRPO)에서 핵심 패널티 항으로 작동합니다.
상호정보량 (Mutual Information, I(X; Y))
한 변수 X를 관측함으로써 다른 변수 Y에 대해 얻는 정보량의 크기입니다. I(X; Y) = H(X) - H(X|Y). 의사결정나무(Decision Tree)의 분기 기준인 정보 이득(Information Gain), 자기지도학습(Self-Supervised Learning)의 InfoNCE 손실, 특성 선택(Feature Selection)의 핵심 기준입니다.
정보 병목 이론 (Information Bottleneck, 티쉬비 이론)
나프탈리 티쉬비(Naftali Tishby) 교수가 제안한 이론으로, 심층 신경망의 은닉 표현 T는 입력 X의 무관한 잡음 정보 I(X; T)를 최대한 압축해 버리는 동시에 목표 레이블 Y에 대한 정보 I(T; Y)는 최대한 보존하도록 학습한다는 일반화 메커니즘을 규명했습니다.
AI 분야별 정보이론의 실제 적용 사례 6선
의사결정나무 (ID3 / C4.5)
데이터 세트를 분할할 때 엔트로피 감소량(Information Gain, 정보 이득)이 가장 큰 특성을 탐욕적으로 선택하여 트리를 구축합니다.
컴퓨터 비전 & 패턴인식
의료 영상 정합(MRI-CT 융합)에서 상호정보량(MI)을 정렬 지표로 활용하며, 이미지 압축 오토인코더에서 Rate-Distortion 이론이 적용됩니다.
생성 모델 (VAE & Diffusion)
변분 오토인코더(VAE)의 잠재 변수 정규화(ELBO)와 확산 모델(Diffusion)의 각 타임스텝 잡음 제거 손실을 KL Divergence로 최적화합니다.
안전 강화학습 (SAC / PPO)
Soft Actor-Critic(SAC)은 정책의 엔트로피를 보상에 추가(최대 엔트로피 RL)하여 조기 수렴을 방지하고 다양한 탐색(Exploration)을 유도합니다.
뇌과학 & 로보틱스
칼 프리스턴(Karl Friston)의 자유 에너지 원리(Free Energy Principle)는 뇌가 감각 불확실성(엔트로피)을 최소화하도록 예측 코딩을 수행한다고 설명합니다.
최신 LLM(거대언어모델) 혁신과 정보이론의 결정적 역할
"언어 모델은 세상에 대한 최적의 압축기인가?" — OpenAI의 창립 멤버 일리야 수츠케버(Ilya Sutskever)가 강조했듯, "비지도 텍스트 사전학습은 인터넷 데이터의 최적 무손실 압축 과정"이며, 정보이론의 척도들이 최신 LLM의 훈련, 평가, 샘플링 및 컨텍스트 제어를 전적으로 지배하고 있습니다.
차세대 토큰 예측 손실과 샤논 엔트로피
GPT, Claude, Gemini와 같은 디코더 전용 LLM은 주어진 이전 토큰들(x1, ..., xt-1)을 조건으로 다음 토큰 xt의 조건부 확률 분포 P(xt | x<t)를 예측합니다. 이때 모델의 손실함수는 음의 로그 가능도(Negative Log-Likelihood) = 교차 엔트로피 손실이며, 훈련이 진행될수록 언어 데이터의 샤논 엔트로피 하한선으로 손실값이 점근 수렴합니다.
펄플렉서티 (Perplexity, PPL) = 2H
언어 모델의 당혹감/혼란도를 측정하는 PPL(Perplexity)은 정보이론 엔트로피 H의 거듭제곱인 PPL = 2H(P, Q) = exp(Cross-Entropy Loss)로 정의됩니다. PPL이 10이라는 것은 다음 단어를 예측할 때 10개의 동등한 후보 중에서 헷갈리고 있다는 뜻이며, 엔트로피가 낮을수록 모델의 예측력이 우수함을 입증합니다.
온도(Temperature)와 엔트로피 조작
소프트맥스 온도는 로짓(Logit) 벡터의 엔트로피를 물리적으로 조절하는 하이퍼파라미터입니다. 온도가 0으로 수렴하면 엔트로피가 0이 되어 가장 확률이 높은 1개 토큰만 결정론적으로 출력(Greedy Search)되고, 온도를 높이면 엔트로피가 최대화되어 다양한 토큰이 샘플링됩니다. Top-p(Nucleus Sampling) 역시 누적 확률(엔트로피 질량)을 기준으로 롱테일 잡음 토큰을 잘라내는 정보학적 기법입니다.
문맥 압축, KV 캐시 양자화 및 지능의 본질
100만 토큰에 달하는 초장문 문맥을 다루는 Long-Context LLM에서는 주의 집중(Attention) 행렬의 희소성(Sparsity)을 활용해 중복 토큰을 제거하는 KV 캐시 정보 압축이 필수적입니다. 데이터의 리던던시를 최소화하여 컴팩트한 신경망 가중치에 우주의 인과율을 인코딩하는 과정 전체가 섀넌 정보이론의 궁극적 실현입니다.