
1. 인공지능, 머신러닝, 패턴인식에서 자율학습 Clustering이 가지는 본질적 의미
현실 세계 데이터의 90% 이상은 정답 레이블이 없는 원시 데이터입니다. 지도교사(Teacher) 없이 기계가 스스로 데이터의 내재적 질서를 찾아내는 군집화는 지능의 자기조직화(Self-Organization)를 가능케 하는 필수적 초석입니다.
🤖 인공지능(AI) 에서의 의미
외부 지도 없는 자율적 개념 형성(Autonomous Concept Formation)입니다. 어린아이가 어른이 일일이 이름을 알려주지 않아도 주변 사물들의 모양과 질감을 만져보며 "이것들은 푹신한 것들", "이것들은 딱딱한 것들"로 스스로 무리를 짓듯, AI 에이전트가 환경과의 상호작용 속에서 스스로 범주를 귀납적으로 형성하는 인지적 기틀을 제공합니다.
⚙️ 머신러닝(ML) 에서의 의미
비지도 학습(Unsupervised Learning)의 대표적 탐색 도구입니다. 방대한 라벨 없는 데이터셋 X = {x1, x2, ..., xN} 에 내재된 확률 밀도 분포(Density Distribution)와 군집 매니폴드(Manifold)를 자율 추정하여, 데이터의 잠재적 패턴을 요약하고 고차원 데이터를 몇 개의 대표 프로토타입(Centroids)으로 압축합니다.
📐 패턴인식(PR) 에서의 의미
특성 공간(Feature Space)의 자연스러운 위상 분할입니다. 다차원 공간 상에 분포하는 특징 벡터들 간의 상대적 거리를 측정하여 고립된 고밀도 영역을 식별하고, 패턴 간의 유사성을 정량화하여 유사한 패턴들을 동일한 부류(Category)로 묶어내는 공간적 분할 체계를 구축합니다.
2. Clustering의 핵심 개념, 거리 척도 및 평가 기준
군집화의 성패는 데이터를 공간 상에서 어떻게 표현하고, 데이터 간의 '가까움'을 어떤 수학적 척도로 측정하느냐에 달려 있습니다.
🎯 군집화의 본질적인 이중 최적화 목표
1. 군집 내 응집도 극대화 (Maximize Intra-cluster Compactness): 동일한 군집에 속한 데이터 포인트 간의 거리는 최대한 좁아야 합니다. (군집 내 분산 WCSS 최소화)
2. 군집 간 분리도 극대화 (Maximize Inter-cluster Separation): 서로 다른 군집 간의 거리는 최대한 멀어야 합니다. (군집 간 분산 BCSS 최대화)
📏 주요 거리 측정 함수 (Distance Metrics)
두 다차원 패턴 벡터 x = (x1, ..., xM) 와 y = (y1, ..., yM) 사이의 유사도를 평가하기 위해 다양한 거리 측정 함수를 사용합니다:
- 유클리드 거리 (Euclidean Distance): 가장 널리 쓰이는 직선 거리
d(x, y) = [ ∑i=1M (xi - yi)2 ]1/2 - 맨해튼 거리 (Manhattan / City-block Distance): 격자형 축 이동 거리
d(x, y) = ∑i=1M |xi - yi| - 마할라노비스 거리 (Mahalanobis Distance): 변수 간의 상관관계(공분산 행렬 Σ)와 분산을 정규화하여 반영한 통계적 거리
- 코사인 유사도 (Cosine Similarity): 벡터의 크기 대신 두 벡터 간의 사잇각(방향성)을 측정하여 고차원 텍스트 문서 유사도에 적합
- 해밍 거리 (Hamming Distance): 이진(Binary) 또는 범주형 데이터에서 서로 다른 비트의 개수 측정
📊 최적 군집 수(K) 결정 및 품질 평가 지표
정답 라벨이 없기 때문에 군집화 결과는 내부 평가 척도(Internal Validation Measures)를 통해 객관적으로 검증합니다:
- 실루엣 계수 (Silhouette Coefficient): 각 데이터가 속한 군집 내의 조밀도(a)와 가장 가까운 타 군집과의 거리(b)를 결합하여 -1 ~ +1 사이 값으로 평가 (1에 가까울수록 이상적인 군집화).
s(i) = (b(i) - a(i)) / max(a(i), b(i)) - 엘보우 기법 (Elbow Method): 군집 수 K를 증가시키며 군집 내 제곱합(WCSS)의 감소율을 그래프로 그려, 감소 폭이 완만해지는 '팔꿈치(Elbow)' 꺾임점을 최적의 K로 선정.
- 데이비스-볼딘 지수 (Davies-Bouldin Index): 군집 내 거리 대비 군집 간 거리의 비율을 측정하며, 낮을수록 우수한 군집화.
- 던 지수 (Dunn Index): 군집 간 최소 거리 / 군집 내 최대 직경의 비율로, 높을수록 분리도가 뛰어남.
3. 대표적인 군집화 알고리즘 (패러다임별 분석)
군집화 알고리즘은 데이터를 분할하는 방식과 기하학적 철학에 따라 크게 5대 패러다임으로 분류됩니다.
| 패러다임 | 대표 알고리즘 | 핵심 작동 메커니즘 | 장단점 및 적합 데이터 |
|---|---|---|---|
| 분할 군집화 (Partitional) |
K-Means (K-평균) K-Medoids (PAM) ISODATA |
사전에 지정된 K개의 중심점(Centroid)을 설정하고, 거리 기반 할당과 중심점 재계산을 반복하여 오차 제곱합(WCSS)을 최소화하는 중심 기반 분할 | • 장점: 대규모 데이터셋에 대해 속도가 매우 빠름. • 단점: K를 미리 지정해야 하며, 구형(Spherical)이 아닌 비선형/초승달 형태 군집은 포착하지 못함. 이상치에 취약. |
| 계층적 군집화 (Hierarchical) |
병합형 (Agglomerative) 분할형 (Divisive) Ward, Complete Link |
데이터들을 순차적으로 묶거나(상향식) 쪼개어(하향식) 트리 구조의 덴드로그램(Dendrogram)을 생성. 거리 컷오프를 통해 임의의 군집 수 선택 가능 | • 장점: 군집 수를 미리 지정할 필요가 없으며 시각적 계층 해석이 탁월. • 단점: 시간 복잡도가 O(N2) 또는 O(N3)으로 대규모 데이터에 연산 부담이 큼. |
| 밀도 기반 군집화 (Density-Based) |
DBSCAN OPTICS HDBSCAN |
특정 반경(Epsilon, ε) 내에 최소 이웃 개수(MinPts) 이상의 데이터가 밀집된 고밀도 영역을 연결하여 군집을 형성하고, 저밀도 영역은 노이즈(Noise)로 자동 분리 | • 장점: 기하학적으로 복잡하게 얽힌 형태(도넛형, 초승달형)를 완벽히 포착하며, 이상치를 노이즈로 자동 제거. • 단점: 밀도가 영역마다 다른 데이터셋에는 취약. |
| 분포 기반 군집화 (Distribution) |
GMM (Gaussian Mixture Models) with EM 알고리즘 |
전체 데이터가 K개의 다변량 가우시안 정규분포의 가중 결합으로 생성되었다고 가정하고, 기댓값 최대화(EM) 알고리즘으로 각 군집의 평균, 공분산, 혼합률을 추정 | • 장점: 소프트 클러스터링(데이터가 각 군집에 속할 확률 부여) 제공 및 타원형 군집 허용. • 단점: 초기값에 따라 국소 최적해(Local Minima)에 수렴할 수 있음. |
| 격자 및 신경망 기반 (Grid & Neural) |
SOM (자기조직화 지도) STING, CLIQUE |
고차원 입력 패턴 벡터를 2차원 뉴런 격자망 상에 위상 보존(Topological Preserving) 방식으로 경쟁 학습(Competitive Learning)시켜 매핑 | • 장점: 고차원 데이터의 비선형 군집 구조를 2차원 평면으로 직관적 시각화. • 단점: 하이퍼파라미터(학습률, 이웃 반경 스케줄) 튜닝이 까다로움. |
4. 실제 산업 및 학술 연구에서의 Clustering 활용 사례
자율학습 군집화는 빅데이터에서 인사이트를 도출하고 복잡한 시스템의 행동 양식을 규명하는 데 전방위적으로 활용됩니다.
🛒 고객 세분화 및 맞춤형 마케팅
수백만 이커머스 사용자의 최근 구매일(Recency), 구매 빈도(Frequency), 결제 금액(Monetary)을 바탕으로 RFM 군집화를 수행하여 'VIP 충성 고객', '이탈 우려 고객', '신규 유망 고객' 그룹을 자율 도출하고 타겟 프로모션을 실행합니다.
🧬 생물정보학 유전자 발현 패턴 분석
수만 개의 유전자 마이크로어레이(Microarray) 발현 데이터를 계층적 군집화하여 유사한 조건에서 동시에 활성화되는 유전자 무리를 발굴함으로써, 암 발생 메커니즘과 신약 표적 단백질 군을 규명합니다.
🖼️ 컴퓨터 비전 이미지 분할 (Segmentation)
디지털 영상의 픽셀 좌표와 RGB 색상 공간에서 K-Means 군집화를 적용하여 전경(Foreground)과 배경(Background)을 분리하고, 색상 수를 압축하는 색상 양자화(Color Quantization)를 구현합니다.
🚨 사이버 보안 침입 및 이상 징후 탐지
서버 네트워크 트래픽 로그를 DBSCAN 밀도 군집화로 분석하여, 정상적인 사용자 트래픽 군집에 속하지 못하고 고립된 초소형 이상 패턴(DDoS 공격, 데이터 유출 시도)을 이상치(Outlier)로 감지합니다.
📰 대규모 문서 군집화 & 뉴스 토픽 탐색
포털 사이트에 실시간으로 쏟아지는 수십만 건의 뉴스 기사를 TF-IDF 또는 임베딩 벡터로 변환한 후 군집화하여, 사전 카테고리 지정 없이도 '실시간 속보 토픽'과 연관 기사 묶음을 자동으로 편성합니다.
📍 지리정보시스템 (GIS) 상권 핫스팟 분석
도시 내 택시 승하차 위도·경도 좌표나 카드 결제 위치 데이터를 군집화하여 시간대별 유동인구 집중 상권과 물류 거점 허브 설치 후보지를 최적 선정합니다.
5. 그림을 통해 살펴보는 Clustering의 실제 작동 과정
군집화 알고리즘이 특성 공간 상에서 데이터를 어떻게 탐색하고, 그룹을 형성하며, 중심점을 이동시켜 나가는지 기존 패턴인식 연구 도면을 바탕으로 단계별 메커니즘을 상세히 해설합니다.
그림 1: 분할 군집화(K-Means)의 영역 분할과 중심점 수렴 과정
- 1단계 (초기화): 2차원 공간 상에 K개의 중심점(Centroid, + 기호)을 임의의 위치에 배치합니다.
- 2단계 (최근접 할당): 모든 데이터 포인트는 유클리드 거리가 가장 가까운 중심점 군집으로 소속이 결정되며, 중심점들 사이에 보로노이 다이어그램(Voronoi Diagram) 형태의 선형 경계선이 생성됩니다.
- 3단계 (중심점 갱신): 각 군집에 배정된 데이터 포인트들의 무게중심(평균 좌표)을 다시 계산하여 중심점을 이동시킵니다.
- 4단계 (수렴 완료): 중심점의 이동량이 허용 오차 이하가 될 때까지 2~3단계를 반복하여, 데이터의 조밀한 중심부에 안착합니다.
그림 2: 계층적 군집화의 덴드로그램(Dendrogram) 트리 구조
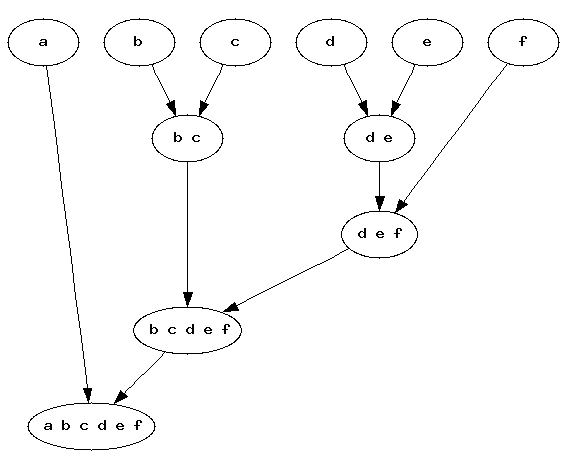
- 상향식 병합 (Agglomerative, Bottom-Up): 각각의 개별 데이터 포인트(말단 노드)에서 출발하여 거리가 가장 가까운 데이터 쌍부터 차례로 병합하여 거대한 하나의 클러스터(루트 노드)로 묶어 나갑니다.
- 하향식 분할 (Divisive, Top-Down): 전체 데이터를 하나의 집합으로 두고 거리가 가장 먼 부분집합부터 점진적으로 분할합니다.
- 거리 컷오프(Cut-off) 기법: Y축(거리/유사도 높이)에서 수평 기준선을 그어 절단함으로써, 데이터의 다층적 계층 구조(세부 분류 vs 대분류)를 분석가가 자유롭게 선택할 수 있습니다.
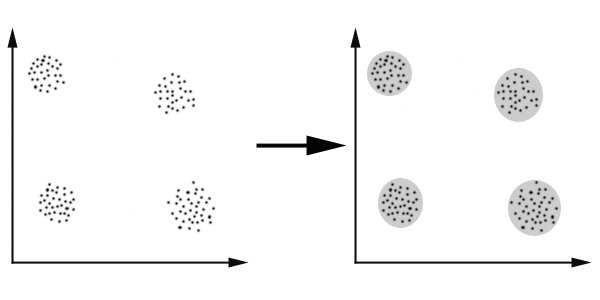
그림 3: 2차원 특성 공간에서의 원시 표본과 자연스러운 군집

- 라벨 없는 원시 공간: 그림과 같이 라벨 태그가 전혀 없는 데이터 포인트들이 산재해 있을 때, 인간의 눈에도 자연스럽게 몇 개의 덩어리(밀집 무리)가 시각적으로 인식됩니다.
- 공간적 밀집도 분별: 알고리즘은 각 표본 간의 상대적 거리를 계산하여, 점들이 조밀하게 모여 있는 영역과 그 사이를 가르는 희소 영역(Low-density Gap)을 판별하여 최적의 군집 경계를 형성합니다.
그림 4: ISODATA의 동적 분할(Split) 및 병합(Merge) 과정

- 고정된 K의 한계 극복: 전통적인 K-Means와 달리, 군집 내부의 표준편차가 기준치보다 과도하게 크면 해당 군집을 2개로 자동 분할(Split)합니다.
- 중심점 간 거리 병합: 두 군집 중심점 사이의 거리가 임계값보다 너무 가까우면 단일 군집으로 자동 병합(Merge)하여 최적의 군집 수를 스스로 탐색해 나가는 지능적 반복 과정을 수행합니다.
6. Classification(분류) 과 Clustering(군집화)의 구체적 차이점
패턴인식 체계에서 분류와 군집화는 상호 보완적이면서도 문제의 정의, 데이터 요구조건, 학습 철학에서 명확한 차이를 보입니다.
| 비교 항목 | 분류 (Classification) | 군집화 (Clustering) |
|---|---|---|
| 학습 패러다임 | 지도 학습 (Supervised Learning) | 비지도 학습 (Unsupervised Learning) |
| 정답 레이블 유무 | 각 데이터마다 사전에 정의된 정답 레이블(Ground Truth) 필수 | 정답 레이블이 전혀 없는 순수 원시 특성 데이터(X)만 사용 |
| 근본적 수행 목적 | 알려진 클래스 기준에 따라 새로운 입력을 올바른 범주로 매핑 | 데이터 자체의 거리와 밀도에 기반하여 숨겨진 자연적 무리 구조 발견 |
| 그룹 수 결정 | 문제 정의 단계에서 클래스 수(C)가 고정되어 주어짐 | 분석가가 하이퍼파라미터(K)를 조정하거나 알고리즘이 자율 결정 |
| 경계 형성 원리 | 오분류 손실을 최소화하는 결정 초평면/결정 경계(Decision Boundary) | 군집 내 거리를 좁히고 군집 간 거리를 넓히는 응집 영역 형성 |
| 성능 평가 방식 | 정확도, 정밀도, 재현율, F1-Score (객관적 정답 대조 채점) | 실루엣 계수, 엘보우 기법, 도메인 전문가의 정성적 의미 해석 |
| 대표 알고리즘 | 로지스틱 회귀, SVM, 의사결정나무, XGBoost, CNN | K-Means, 계층적 군집화, DBSCAN, GMM, SOM |
| 실제 비유 예시 | 도서관 사서가 책의 장르 라벨을 보고 '역사', '소설', '과학' 서가에 정리하기 | 사서 없이 책들의 단어 빈도와 두께가 비슷한 것끼리 자연스럽게 모아두기 |
🔄 분류와 군집화의 실무적 융합 시너지 (Semi-Supervised Learning)
실무에서는 두 기법을 독립적으로 쓰기보다 결합하여 강력한 시너지를 냅니다.
수백만 건의 라벨 없는 원시 데이터를 먼저 군집화(Clustering)하여 대표적인 소수 군집을 추려낸 뒤, 각 군집의 핵심 데이터만 인간 전문가가 선별 라벨링하여 분류(Classification) 모델의 훈련 데이터셋으로 활용하는 준지도 학습(Semi-Supervised Learning) 및 능동 학습(Active Learning) 파이프라인이 널리 채택되고 있습니다.
7. 인간의 Clustering 과 컴퓨터의 Clustering 근본적 차이점
인간의 두뇌가 시각과 인지 과정을 통해 대상을 무리 짓는 지각 심리학적 방식과 기계가 수치 벡터 공간에서 거리를 계산하는 연산 방식 사이에는 본질적인 메커니즘의 차이가 존재합니다.
👁️ 1) 지각 메커니즘: 게슈탈트 인지 vs 수치 거리 최적화
- 인간 (게슈탈트 지각 법칙): 인간은 게슈탈트 심리학(Gestalt Psychology)의 법칙인 근접성(Proximity), 유사성(Similarity), 연속성(Good Continuation), 폐쇄성(Closure)을 뇌에서 순간적으로 통합하여, 점들이나 물체들을 한눈에 직관적인 덩어리(Form)로 지각합니다.
- 컴퓨터 (수학적 오차 최소화): 대상을 고차원 수치 벡터 좌표로 치환한 뒤, 유클리드 거리나 공분산 행렬을 반복 계산하여 오차 제곱합(SSE) 목적 함수를 최소화하는 정량적 최적화만을 수행합니다.
📐 2) 공간 차원성: 2D/3D 시각 직관 vs 고차원 연산과 차원의 저주
- 인간 (2D/3D 시각 특화): 평면이나 3차원 공간 상의 군집은 0.1초 만에 이상치까지 완벽하게 분별하지만, 4차원 이상의 고차원 데이터 공간은 시각화나 인지적 파악이 불가능합니다.
- 컴퓨터 (수천 차원 연산 가능): 수백~수만 차원의 초고차원 벡터 공간에서도 거리를 정확히 계산할 수 있습니다. 그러나 차원이 높아질수록 모든 데이터 간의 거리가 균일해지는 '차원의 저주(Curse of Dimensionality)'에 직면하여 차원 축소(PCA 등) 전처리가 필수적입니다.
🎯 3) 유연성과 목적성: 맥락적 다중 관점 vs 고정된 척도 연산
- 인간 (목적에 따른 동적 그룹화): 사과, 바나나, 당근, 스테이크가 있을 때, '달콤한 디저트' 관점에서는 [사과, 바나나]를 묶고, '식물성 식품' 관점에서는 [사과, 바나나, 당근]을 묶듯, 맥락과 의도에 따라 기준을 유연하게 전환합니다.
- 컴퓨터 (기계적 거리 척도 종속): 알고리즘에 사전 입력된 단 하나의 거리 함수와 가중치에만 의존하여 기계적으로 군집을 분할하므로, 분석가가 의도한 새로운 비즈니스 맥락을 스스로 반영하지 못합니다.
🧩 4) 의미론적 이해: 상식 통합 vs 형태적 이상치 취약
- 인간 (상식과 인과관계): 한 사물이 외형적 크기나 색상이 극단적으로 달라도 상식과 의미론적 지식을 활용해 동일한 군집으로 포용하거나 명백한 노이즈로 직관 배제합니다.
- 컴퓨터 (스케일 왜곡 취약): 데이터 스케일링이 안 되어 특정 변수의 단위가 크면, 의미와 무관하게 그 변수에 의해 군집 경계 전체가 심각하게 왜곡되는 기계적 한계를 갖습니다.
| 비교 관점 | 인간의 군집화 (Human Grouping) | 컴퓨터의 군집화 (Machine Clustering) |
|---|---|---|
| 처리 원리 | 게슈탈트 지각 체계(근접, 유사, 연속) 및 상식 추론 | 수학적 거리 행렬 계산 및 비용 함수 최소화 최적화 |
| 차원 처리 한계 | 2차원, 3차원 시각 공간에 국한됨 (고차원 인지 불가) | 수백~수만 차원의 초고차원 벡터 공간도 수치 계산 가능 |
| 다목적 유연성 | 상황과 맥락, 질문의 의도에 따라 기준을 즉시 변경 | 사전 지정된 거리 함수와 하이퍼파라미터(K, ε)에 종속됨 |
| 대규모 처리 능력 | 수만 개 이상의 점을 동시에 정량 계산 불가 (피로도 발생) | 수천만 건의 데이터를 지치지 않고 일관된 척도로 고속 군집화 |
| 군집 개수(K) 인지 | 데이터 분포 형태를 보고 자연스러운 덩어리 개수를 직관 파악 | 엘보우 기법, 실루엣 스코어 등 탐색적 반복 실험 필요 |
| 이상치(노이즈) 대응 | 명백한 오점을 본능적으로 분리 및 무시 | K-Means 등 일부 알고리즘은 이상치에 중심점이 크게 흔들림 |
🤝 인간-컴퓨터 상호 보완의 미래: 인터랙티브 군집화 (Interactive Clustering)
컴퓨터는 인간이 결코 들여다볼 수 없는 고차원 빅데이터 공간에서 초고속으로 수치적 군집을 형성해 내고, 인간 전문가는 도출된 군집의 실루엣과 시각화 결과를 검토하여 군집 수(K)를 조율하고 비즈니스적 의미(Semantics)를 부여합니다.
이처럼 기계의 막강한 연산력과 인간의 유연한 직관을 융합하는 인터랙티브 군집화 및 인간 중심 데이터 분석(Human-in-the-Loop Clustering)이 현대 인공지능과 데이터 과학의 가장 이상적인 실천 모델입니다.