1. 수학과 통계학에서 차지하는 히스토그램의 위상과 역사적 기원
히스토그램은 현대 통계학의 태동과 궤를 같이하며, 경험적 표본(Sample)과 이론적 확률 법칙(Probability Law)을 잇는 가장 근본적인 다리입니다.
📜 칼 피어슨(Karl Pearson)의 창안 (1891)
1891년 현대 수리통계학의 개척자인 칼 피어슨(Karl Pearson)이 고대 그리스어 'histos(돛대, 기둥)'와 'gramma(그림, 기록)'를 결합하여 공식 도입하였습니다. 이는 단순한 표 형태의 도수분포표를 기하학적 연속 면적 개념으로 확장한 기념비적 도약이었습니다.
📊 비모수적 확률 밀도 추정의 출발점
모집단의 확률 밀도 함수 p(x)의 형태(정규분포 등)를 알 수 없을 때, 어떠한 사전 수학적 분포 가정 없이도 관측 데이터만으로 실제 확률 밀도 함수를 근사적으로 도출해내는 최초이자 가장 근원적인 비모수적 밀도 추정 기법(Nonparametric Density Estimation)입니다.
🔍 데이터 분포 형상의 종합 진단 도구
평균과 분산이라는 단순 수치 2개만으로는 절대 알 수 없는 데이터의 비대칭도(왜도, Skewness), 꼬리의 두께(첨도, Kurtosis), 데이터가 두 개 이상의 봉우리로 나뉘는 다봉성(Multimodality)을 완벽히 드러내는 탐색적 통계학(EDA)의 표준 잣대입니다.
2. AI 와 데이터 분석, 컴퓨터 비전, 패턴인식 에서의 활용
히스토그램은 인공지능과 컴퓨터 과학의 다양한 하위 분야에서 데이터의 통계적 특성을 압축하고 핵심 특징을 서술하는 강력한 무기로 진화하였습니다.
🤖 AI & 데이터 분석 (Data Analytics)
- 탐색적 데이터 분석(EDA) & 이상치 검출: 특성 변수의 결측, 이상치, 분포 편향을 진단하고 로그 변환(Log Transform) 필요성을 판단.
- 데이터 드리프트(Data Drift) 모니터링: 모델 학습 시점의 피처 히스토그램과 실시간 운영 시점의 히스토그램을 비교(PSI, KL-Divergence)하여 성능 저하 사전 감지.
- 트리 모델 고속화 (LightGBM): 연속형 변수를 히스토그램 빈(Bin)으로 이산화하여 최적 분할점 탐색 속도를 10배 이상 가속.
👁️ 컴퓨터 비전 (Computer Vision)
- 히스토그램 평활화 (Histogram Equalization): 조명이 어둡거나 과노출된 영상의 그레이스케일 명암비를 균일하게 펼쳐 디테일 선명화 (CLAHE 기법).
- HOG (Histogram of Oriented Gradients): 국소 영역 내 엣지 기울기 방향의 히스토그램을 결합하여 자율주행 보행자 및 차량 객체 인식.
- SIFT 특징 기술자: 키포인트 주변의 그래디언트 방향 히스토그램을 추출하여 회전·크기 변화에 불변하는 특징점 매칭.
- 색상 역투영(Backprojection) 추적: 목표 객체의 2D 색상 히스토그램을 기반으로 영상 내 실시간 객체 추적(CamShift).
📐 패턴인식 (Pattern Recognition)
- 비모수적 베이즈 판별 결정 (Nonparametric Bayesian Decision): 클래스별 조건부 확률 밀도 p(x|ωi)를 히스토그램 상대 빈도로 직접 추정하여 베이즈 의사결정 규칙 적용.
- 오츠의 이진화 (Otsu's Thresholding): 영상 히스토그램의 계곡(Valley)을 찾아 전경과 배경의 군집 간 분산(Between-class Variance)을 최대화하는 최적 임계치 자동 결정.
- 특성 선택 (Feature Selection): 클래스 간 히스토그램의 겹침(Overlap)이 적은 고분별력 특징을 선별.
3. Histogram의 핵심 개념과 수학적 밀도 추정 공식
히스토그램이 단순한 도수 막대그래프를 넘어 수학적인 확률 밀도 함수 p̂(x) 로 성립하는 메커니즘을 표준 HTML 수식으로 분석합니다.
🎯 핵심 구성 요소
- 구간 / 계급 (Bin 또는 Cell): 변수 x의 전체 범위를 유한 개의 겹치지 않는 부분 구간으로 분할한 셀.
- 계급의 폭 (Bin Width, wj): 각 구간의 가로 크기. 동일한 폭(Equal-width) 또는 도수가 동일한 적응형 폭(Equal-frequency)으로 설정 가능.
- 도수 (Frequency, nj): 해당 구간에 속하는 관측 데이터의 개수.
- 상대도수 (Relative Frequency): 전체 표본 중 해당 구간이 차지하는 비율 (nj / N).
- 확률 밀도 높이 (Density, p̂j): 상대도수를 구간 폭 wj 로 나누어 막대의 면적(가로 × 세로)이 정확히 해당 구간의 확률이 되도록 정규화한 값.
⚖️ 최적 Bin 크기(폭) 결정 공식과 상충 관계
- 과소 평활화 (Oversmoothing / Bin이 너무 큰 경우): 그래프가 지나치게 뭉툭해져(Rough), 데이터가 가진 세부 봉우리(Bimodal 등)와 중요한 통계적 변곡점을 완전히 상실합니다.
- 과대 적합 (Undersmoothing / Bin이 너무 작은 경우): 막대들이 바늘처럼 뾰족뾰족하게 쪼개져(Spiky), 표본의 무작위 노이즈에 과민하게 반응하고 전반적인 분포 윤곽을 읽을 수 없습니다.
- 스터지스 공식 (Sturges' Rule): 정규분포 데이터에 적합한 계급 수 산정:
k = 1 + log2N - 프리드먼-디아코니스 공식 (Freedman-Diaconis Rule): 이상치에 견고한 사분위수 범위(IQR) 기반 최적 폭:
w = 2 · IQR · N-1/3
4. Histogram 생성 알고리즘의 단계별 실행 과정 (Step-by-Step)
원시 수치 데이터셋으로부터 수학적으로 엄밀한 히스토그램을 구축하는 5단계 표준 파이프라인입니다.
데이터 범위(Data Range) 탐색
주어진 표본 데이터셋 X = {x1, x2, ..., xN} 에서 최소값(xmin)과 최대값(xmax)을 산출하여 전체 데이터의 분포 범위인 전범위(Range = xmax - xmin)를 확정합니다.
계급 수(k) 및 계급 폭(w) 결정
표본 수 N과 데이터의 산포도를 고려하여 최적의 계급 수 k(예: 스터지스 공식 1 + log2N) 또는 계급 폭 w(프리드먼-디아코니스 공식)를 결정합니다. 등간격 분할의 경우 각 구간의 폭은 w = Range / k 로 설정됩니다.
계급 경계선(Bin Edges) 설정
최소값부터 시작하여 폭 w씩 증가시키며 연속적인 반열린 구간(Half-open Interval)들을 정의합니다:
[b0, b1), [b1, b2), ..., [bk-1, bk] (마지막 구간은 닫힌 구간으로 최대값 포함).
도수 집계 (Binning & Tallying)
모든 데이터 포인트 xi 에 대해 어느 구간에 속하는지 판별하여 각 구간별 도수(카운트, nj)를 1씩 누적합니다. 모든 구간 도수의 총합은 전체 데이터 수 N과 정확히 일치해야 합니다 (∑ nj = N).
확률 밀도 정규화 및 기둥 시각화 (Rendering)
단순 도수 그래프일 경우 Y축에 도수 nj 를 표시하며, 확률 밀도 함수(PDF)로 사용할 경우 Y축에 정규화된 밀도 p̂j = nj / (N · wj) 를 높이로 하여 직사각형 막대(Bar)들을 연속적으로 렌더링합니다.
5. 그림으로 자세히 살펴보는 Histogram 의 실제 작동 및 의사결정 과정
히스토그램이 구간 폭(Bin Width)의 변화에 따라 실제 정규분포를 어떻게 근사하는지, 그리고 패턴인식에서 두 클래스를 분별하는 비모수적 결정 경계를 어떻게 수립하는지 기존 패턴인식 연구 도면을 바탕으로 정밀 분석합니다.
그림 1: 구간(Interval) 개수 변화에 따른 정규 밀도 근사 비교
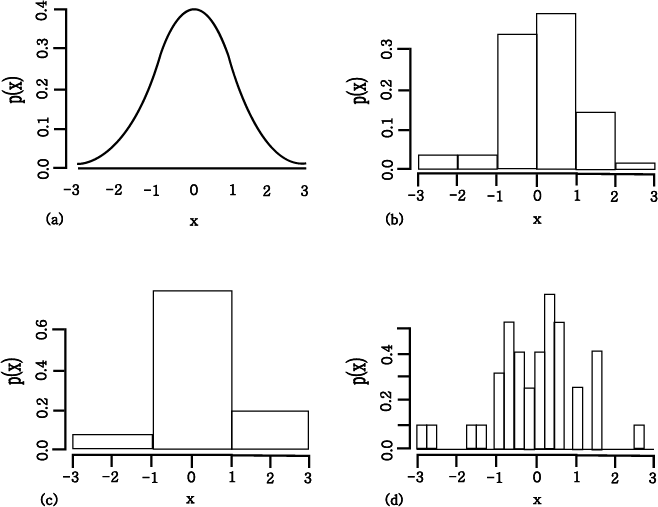
- (a) True Normal Density: 50개의 정규분포 난수 표본이 따르는 이론적인 참 확률 밀도 함수 p(x) 곡선입니다.
- (b) 6개의 구간(Interval) 히스토그램: 50개 표본에 대해 적절한 구간 폭을 설정한 경우로, 이론적 정규분포 곡선(종형 곡선)의 형상을 가장 균형 있게 성공적으로 복원해 냅니다.
- (c) 3개의 구간(Interval) 히스토그램: 과소 평활화 (Oversmoothing). 구간이 너무 넓어 정규분포의 중심 첨도와 분산 정보가 뭉개져 거칠고 왜곡된 평탄화가 발생합니다.
- (d) 24개의 구간(Interval) 히스토그램: 과대 적합 (Undersmoothing). 50개 표본에 비해 구간이 너무 좁아 막대들이 들쑥날쑥 대못처럼 쪼개지며 표본 노이즈에 과민하게 반응합니다.
그림 2: Class A와 Class B의 특성 히스토그램과 최적 판별 기준
 class A and (b) class B.GIF)
- (a) Class A의 특징 x 분포: 좌측 영역에 밀집된 패턴 부류 A의 경험적 히스토그램 밀도 추정치 p̂(x|A).
- (b) Class B의 특징 x 분포: 우측 영역에 밀집된 패턴 부류 B의 경험적 히스토그램 밀도 추정치 p̂(x|B).
- 비모수적 베이즈 판별 경계 (Decision Threshold): 두 클래스의 히스토그램 밀도가 교차하는 지점(p̂(x|A) · P(A) = p̂(x|B) · P(B))을 최적의 분류 기준선(임계값)으로 설정함으로써, 복잡한 수학 공식 없이도 오분류 확률을 최소화하는 비모수적 판별 규칙이 완성됩니다.
그림 3: 히스토그램과 도수분포다각형(Frequency Polygon)의 기하학적 관계
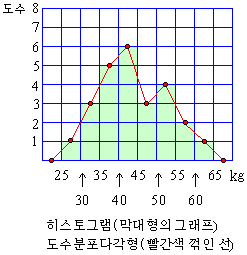
- 도수분포다각형의 형성: 각 히스토그램 직사각형의 윗변 중심점을 선분으로 연결하고, 양쪽 끝에 도수가 0인 가상의 계급을 두어 가로축과 닫힌 다각형을 만듭니다.
- 면적의 동등성 원리: 직사각형 막대 밖으로 삐져나온 삼각형 면적과 안쪽으로 잘려나간 삼각형 면적이 완벽히 합동을 이루어, 히스토그램의 총 면적과 도수분포다각형의 총 면적은 수학적으로 정확히 일치합니다. 이는 이산적인 막대 표현이 연속적인 밀도 곡선으로 전이되는 징검다리 역할을 합니다.
6. 실제 산업 및 최신 인공지능 기술에서의 활용 사례
히스토그램은 단순 통계를 넘어 첨단 의료 영상, 자율주행, 음성 및 텍스트 빅데이터 분석의 핵심 엔진으로 활약하고 있습니다.
🏥 의료 영상 개선 (CLAHE)
X-ray나 저선량 흉부 CT 영상에서 명암 대비가 낮아 식별이 어려운 미세 폐암 병변이나 골절 부위를, 국소 영역별 대비 제한 적응 히스토그램 평활화(CLAHE)를 통해 노이즈 증폭 없이 선명하게 증강시킵니다.
🚶 자율주행 HOG 보행자 검출
차량 전방 카메라 영상에서 픽셀 단위의 그래디언트 크기와 방향을 8×8 픽셀 셀 단위로 집계한 HOG(Histogram of Oriented Gradients) 특징 벡터를 추출하여, 보행자의 실루엣 외곽선을 실시간으로 정확히 감지합니다.
💳 금융 거래 이상치 탐지 (FDS)
수억 건의 고객 결제 금액 히스토그램은 전형적으로 우측 꼬리가 긴(Right-skewed) 지수 분포를 보입니다. 이 히스토그램 밀도의 극단적인 상위 0.01% 임계 구간을 동적으로 설정하여 해킹·사기 거래를 즉시 포착합니다.
🔍 내용 기반 이미지 검색 (CBIR)
쇼핑몰에서 사진을 업로드하여 유사 상품을 찾을 때, 이미지의 3D RGB/HSV 색상 히스토그램을 추출한 후 히스토그램 인터섹션(Histogram Intersection) 거리로 유사도를 고속 비교하여 일치하는 옷과 가방을 추천합니다.
🎙️ 음성 및 음향 주파수 분석
스마트 스피커나 산업용 설비 진단 시스템에서 마이크 신호를 푸리에 변환한 후 주파수 대역별 에너지 분포를 히스토그램으로 누적하여 기계 고장 진동음이나 특정 음성 명령어를 분별합니다.
🌳 LightGBM 등 초고속 AI 훈련
Kaggle과 실무 정형 데이터 분석을 석권한 LightGBM 알고리즘은 연속형 변수를 히스토그램 빈으로 사전 분할함으로써, 트리 분할점 탐색의 시간 복잡도를 O(데이터수)에서 O(Bin수)로 획기적으로 줄여 초고속 학습을 달성합니다.
7. 히스토그램(Histogram) vs 일반 막대그래프(Bar Chart) 결정적 차이 비교
히스토그램(Histogram)과 일반 막대그래프(Bar Chart)는 둘 다 직사각형 막대(Bar)를 사용하여 데이터를 시각화하므로 겉모습이 매우 유사해 보이지만, 다루는 데이터의 본질(연속형 vs 범주형), 막대 간격의 유무, 가로축 순서 변경 가능 여부, 수학적 면적의 의미, 그리고 궁극적 분석 목적에서 완전히 다른 결정적 차이를 갖습니다.
| 비교 항목 | 히스토그램 (Histogram) | 일반 막대그래프 (Bar Chart) | 핵심 판별점 |
|---|---|---|---|
| 1. 데이터의 본질 (Data Type) |
연속형 양적 데이터 (Continuous Quantitative) • 예: 키, 몸무게, 시험 점수, 시간, 영상 화소 밝기(0~255) 등 • 끊김 없이 무한히 쪼갤 수 있는 실수 구간 데이터 |
이산형 / 범주형 데이터 (Categorical / Discrete) • 예: 혈액형(A/B/O/AB), 국가, 성별, 상품 종류, 부서명 등 • 서로 독립적인 개별 명목 항목 또는 서열 항목 |
연속 vs 범주 |
| 2. 막대 사이의 간격 (Bar Spacing) |
간격이 없음 (막대가 서로 맞닿아 밀착됨) • 구간과 구간이 틈새 없이 연속적으로 이어짐을 증명 • (※ 도수가 0인 빈(Bin) 구간만 기둥이 비어 있음) |
의도적인 공백(Gap)이 항상 존재함 • 각 막대가 서로 섞이지 않는 독립된 개별 범주임을 명확히 구별하기 위해 반드시 틈새를 둠 |
밀착 vs 분리 |
| 3. 가로축(X축) 순서 변경 (Order of Bars) |
순서 변경 절대 불가 (고정된 수치 오름차순) • 작은 값에서 큰 값으로 크기순 정렬 필수 • 순서를 임의로 바꾸면 왜도·첨도·봉우리 등 데이터의 분포 형태가 완전히 파괴됨 |
자유롭게 순서 변경 가능 (임의 재배치 허용) • 가나다순, 알파벳순, 값 크기순(내림차순 정렬) 등 분석 목적에 맞게 막대 위치를 자유롭게 변경 가능 |
고정 vs 임의 |
| 4. 막대 너비와 면적 (Width & Area) |
너비(폭 w)와 면적(가로 × 세로)이 수학적 실체 • 가로 폭은 계급 구간 크기(Bin Width)를 의미함 • 막대의 면적 = 도수(또는 확률)에 비례하며, 전체 막대 면적의 합은 총 데이터수 N (정규화 시 1.0) |
너비는 시각적 편의일 뿐 수학적 의미 없음 • 막대 폭은 가독성을 위해 임의로 통일한 디자인 요소임 • 오직 막대의 높이(또는 가로 막대의 길이)만이 해당 범주의 수치 크기를 나타냄 |
면적 vs 높이 |
| 5. 궁극적 시각화 목적 (Primary Goal) |
데이터의 전반적인 "분포 형태(Distribution Shape)" 파악 • 정규분포 여부, 봉우리의 개수(단봉/다봉), 비대칭성(좌우 왜도), 꼬리 두께, 이상치 확인 및 확률밀도함수(PDF) 추정 |
범주별 "수치 크기의 단순 대소 비교 (Comparison)" • 어떤 항목이 더 많고 적은지, 순위와 점유율이 어떻게 다른지 개별 항목 간의 크기를 한눈에 비교 |
분포 vs 비교 |
실무 데이터 분석가를 위한 3초 직관 판별법 (The 3-Second Test)
→ 순서를 바꿔도 무방하다면 막대그래프(Bar Chart)이고, 순서를 바꾸는 순간 그래프가 완전히 파괴된다면 히스토그램(Histogram)입니다.
• 질문 2: "막대와 막대 사이에 빈틈(공백)을 벌려 놓아야 하는가?"
→ 서로 다른 독립된 항목이라 틈을 띄워야 하면 막대그래프, 연속된 수치라 빈틈없이 붙여야 하면 히스토그램입니다.
• 질문 3: "막대의 면적(가로 폭 × 세로 높이)이 실제 확률이나 도수를 의미하는가?"
→ 높이만 보면 충분하면 막대그래프, 가로 폭과 면적까지 계산해야 확률이 나온다면 히스토그램입니다.