1. 인공지능, 머신러닝, 패턴인식에서 자율학습 K-means Clustering이 가지는 의미
K-means는 단순한 데이터 분할 기법을 넘어, 기계가 라벨 없는 고차원 데이터에서 대표적인 원형(Prototype)을 스스로 학습하여 지능적인 인지 기반을 마련하는 초석입니다.
🤖 인공지능(AI) 에서의 의미
프로토타입 기반의 개념 형성(Prototype Theory of Categorization)입니다. 인간이 '참새'나 '비둘기'라는 전형적인 새의 원형을 마음에 품고 새로운 생명체를 인지하듯, AI 에이전트가 데이터 공간 상에 K개의 대표 중심점(Centroid)을 형성하여 방대한 비정형 세계를 유한한 개념 체계로 요약·압축하는 인지적 출발점입니다.
⚙️ 머신러닝(ML) 에서의 의미
비지도 목적 함수(WCSS) 최소화의 정형적 모델이자 필수적인 특성 공학(Feature Engineering) 도구입니다. 정답 레이블이 없는 대규모 데이터에서 잠재 클러스터를 발굴할 뿐 아니라, 각 중심점과의 거리를 새로운 입력 피처로 변환하여 후속 지도학습(선형 분류기, 신경망)의 표현력과 학습 효율을 극대화합니다.
📐 패턴인식(PR) 에서의 의미
특성 공간(Feature Space)의 보로노이 테셀레이션(Voronoi Tessellation) 분할입니다. 다차원 공간 상에 분포하는 표본 벡터들을 가장 가까운 중심점을 기준으로 기하학적 볼록 다포체(Convex Polytope) 영역으로 양분하여, 오차 제곱합을 국소 최소화하는 최적의 패턴 경계를 확립합니다.
2. K-means Clustering의 핵심 개념과 수학적 목적 함수
K-means 알고리즘을 지탱하는 수학적 목적 함수와 주요 메커니즘을 표준 HTML 수식으로 분석합니다.
🎯 핵심 개념 요소
- 중심점 (Centroid, μk): 군집 Ck에 속한 총 Nk개 데이터 벡터의 산술 평균 좌표:
μk = (1 / Nk) · ∑x ∈ Ck x - 씨앗 점 (Seed Point): 알고리즘 시작 시 임의로 선택되는 초기 K개의 중심점 위치. 초기 위치 선정에 따라 최종 수렴 결과가 달라질 수 있습니다.
- 유클리드 거리 척도: 데이터 간의 근접성을 측정하는 기본 척도로써 구형(Spherical) 군집을 형성하는 기하학적 특성을 띱니다.
- 하드 클러스터링(Hard Clustering): 한 데이터 포인트는 오직 단 하나의 군집에만 엄격히 배속됩니다. (소속 확률이 아닌 0 또는 1)
📜 알고리즘 변형: Lloyd vs MacQueen vs Forgy
- 로이드 알고리즘 (Lloyd's Algorithm, 1982): 현재 실무에서 가장 표준으로 쓰이는 방식. 모든 데이터를 각 중심점에 완전히 할당한 후, 한꺼번에 중심점을 배치(Batch) 갱신.
- 맥퀸 알고리즘 (MacQueen, 1967): 원문 논문 방식. 샘플이 군집에 할당되자마자 즉시 중심점(Centroid)을 온라인으로 실시간 재계산. 데이터셋을 단 두 번 패스(Pass)하여 처리하는 특징.
- 포지 알고리즘 (Forgy, 1965): 초기 K개 중심점을 데이터 중에서 무작위로 추출한 뒤 반복 수렴시키는 고전적 표준 기법.
- K-means++ (Arthur & Vassilvitskii, 2007): 초기 중심점들을 서로 최대한 멀리 떨어지도록 거리 비례 확률로 지능적 샘플링하여, 수렴 속도를 2배 이상 높이고 최적해 도달 확률을 극대화.
🔍 최적의 군집 수 K 는 어떻게 결정하는가?
• 실루엣 분석 (Silhouette Analysis): 각 데이터의 군집 내 조밀도와 타 군집과의 분리도를 종합 계산한 실루엣 계수(-1 ~ +1)의 전체 평균이 가장 높은 K를 채택합니다.
3. K-means Clustering의 단계별 실행 과정 (Step-by-Step)
K-means 알고리즘이 초기 무작위 중심점에서 출발하여 최적의 군집 중심으로 수렴해 나가는 4단계 순환 루프입니다.
초기화 (Initialization: Select K Seed Points)
분석가가 사전에 결정한 군집 수 K개의 초기 중심점(Seed Points) μ1, μ2, ..., μK 를 데이터 공간 상에 배치합니다. 고전적으로는 데이터 중 무작위 K개를 선택하며, 현대에는 K-means++ 방식을 적용하여 중심점 간 거리를 최대화하여 배치합니다.
군집 할당 단계 (Cluster Assignment Step)
전체 데이터셋의 각 데이터 포인트 xi 에 대하여 K개의 중심점과의 유클리드 거리를 계산합니다. 가장 거리가 가까운(최소 거리) 중심점을 보유한 군집으로 해당 데이터를 배속시킵니다:
C(i) = argmink ||xi - μk||2
이 단계에서 공간 상에는 중심점들을 경계로 하는 보로노이 영역(Voronoi Cells)이 자연스럽게 형성됩니다.
중심점 갱신 단계 (Centroid Update Step)
2단계에서 각 군집 Ck에 새롭게 할당된 데이터 포인트들의 산술 평균 좌표를 계산하여, 중심점의 위치를 새로운 평균점으로 이동(Update)시킵니다:
μk(new) = (1 / |Ck|) · ∑x ∈ Ck x
수렴 검사 및 반복 종료 (Convergence Check)
중심점의 위치 이동량(||μk(new) - μk(old)||)이 사전에 정의된 허용 오차 이하이거나, 데이터 포인트의 군집 재배속이 더 이상 발생하지 않으면 알고리즘을 즉시 종료합니다. 그렇지 않다면 2단계(할당)로 돌아가 과정을 반복합니다.
📊 K-means 분할 군집화의 단계별 중심점 이동 및 수렴 과정
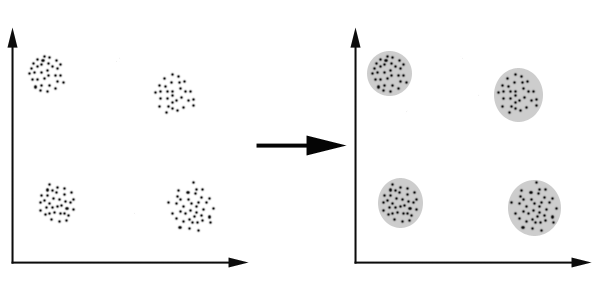
4. K-means Clustering의 실제 산업 및 학술 활용 사례
K-means는 빠른 연산 속도와 구현 용이성 덕분에 모든 비지도 분석 파이프라인의 1순위 알고리즘으로 활용됩니다.
👥 고객 세분화 (Customer Profiling)
금융사 및 유통업체에서 고객들의 거래 빈도, 1회 평균 결제액, 앱 체류 시간을 3차원 특성으로 삼아 K-means(K=4~5)를 수행함으로써 'VIP 자산가', '실속형 할인 추구자', '이탈 고위험군' 등으로 세분화하여 맞춤형 마케팅을 전개합니다.
🎨 이미지 색상 양자화 (Color Quantization)
24비트 트루컬러(약 1,677만 색상) 이미지의 모든 픽셀 RGB 벡터를 K-means(예: K=16 또는 64)로 군집화하여 K개의 대표 중심 색상으로 치환함으로써, 시각적 화질 손실을 최소화하면서 파일 크기를 수십 분의 일로 압축합니다.
📰 뉴스 기사 및 문서 군집화
매일 발행되는 수십만 건의 기사를 TF-IDF나 텍스트 임베딩 벡터로 변환한 후 K-means를 적용하여, 사전 태깅 없이도 '우크라이나 정세', '반도체 실적 발표', '프로야구 경기' 등 실시간 주요 이슈 묶음을 자동으로 분류하여 메인 화면에 편성합니다.
🛡️ 이상 거래 및 침입 탐지 (FDS)
정상적인 결제 로그들을 여러 개의 K-means 클러스터로 학습시킨 뒤, 새로운 결제 건이 어느 중심점과도 거리가 지나치게 멀리 떨어져 있을 경우(오차 거리 임계치 초과), 이를 도난·복제 이상 거래로 간주하여 승인을 차단합니다.
🧬 유전자 발현 패턴 및 생체 신호 분석
시간 경과에 따른 수천 개 유전자의 발현 프로파일을 K-means로 묶어, 동일한 환경 자극에서 동기화되어 활성화되는 유전자 기능 모듈과 생체 바이오마커를 신속히 탐색합니다.
🚚 물류 센터 입지 및 배송 라우팅
수만 개 배송 목적지의 GPS 위도·경도 좌표를 K-means로 군집화하여 K개 구역별 물류 허브 설치 최적 좌표를 도출하고 배송 트럭의 이동 동선을 최단 거리로 스케줄링합니다.
5. 군집화(Clustering) 전체 지형도에서 K-means의 위치와 역할
군집화라는 광활한 비지도 학습의 세계에서 K-means는 어디에 위치하며, 어떤 장점과 한계로 인해 다른 알고리즘들이 파생 발전해 왔는지를 조망합니다.
📊 5대 군집화 패러다임 내 K-means의 좌표
| 군집화 패러다임 | 대표 알고리즘 | 기하학적 가정 및 작동 철학 | K-means와의 상대적 관계 |
|---|---|---|---|
| 분할 군집화 (Partitional) |
K-means K-Medoids (PAM) K-means++ |
중심점 기반(Centroid-based) 오차제곱합(WCSS) 최소화. 전 영역을 K개의 볼록 다포체(보로노이 셀)로 공간 분할 | 분할 군집화의 절대적 표준이자 모든 벤치마크의 기본 기준점 |
| 계층적 군집화 (Hierarchical) |
병합형 (Agglomerative) 분할형 (Divisive) Ward, Complete Link |
거리 덴드로그램 트리를 구축하여 다층적 계층 구조 형성. 군집 수를 사전 지정할 필요 없음 | K-means보다 해석력이 우수하나 계산 복잡도 O(N2)로 대규모 데이터에 불리 |
| 밀도 기반 군집화 (Density-Based) |
DBSCAN OPTICS HDBSCAN |
반경(ε) 내 최소 이웃 수(MinPts)로 고밀도 영역을 연결. 노이즈(이상치) 자동 배제 | K-means가 풀지 못하는 비선형·초승달·도넛형 군집을 완벽 해결 |
| 분포 기반 군집화 (Distribution) |
GMM (가우시안 혼합 모델) with EM 알고리즘 |
다변량 정규분포의 혼합 가정. 타원형 군집 허용 및 소속 확률을 부여하는 소프트 클러스터링 | K-means의 확률론적 일반화(Soft K-means)에 해당 |
| 신경망 기반 군집화 (Neural Grid) |
SOM (자기조직화 지도) Growing Neural Gas |
고차원 입력을 2차원 뉴런 격자망 상에 위상 보존(Topological Preserving) 경쟁 학습 매핑 | 고차원 매니폴드의 비선형 위상 구조를 시각화하는 신경망 모델 |
⚡ K-means의 독보적 강점과 불멸의 이유
- 압도적인 연산 속도: 시간 복잡도가 O(t · K · N · M) 로 데이터 수 N에 대해 선형(Linear) 비례하여, 수억 건의 대규모 빅데이터도 실시간 처리가 가능합니다.
- 탁월한 확장성 (Scalability): 데이터를 메모리에 한 번에 올리지 않고 미니배치 단위로 갱신하는 Mini-Batch K-Means를 통해 테라바이트급 분산 환경(Spark 등)에서도 거뜬히 구동됩니다.
- 직관적 명확성: 중심점의 산술 평균 좌표가 곧 군집의 대표 특성이 되므로 현업 실무자 및 의사결정권자에게 설명(Explainable)하기가 매우 용이합니다.
⚠️ K-means의 본질적 한계와 파생 알고리즘
- 구형(Spherical) 군집 가정: 모든 방향으로 분산이 동일한 둥근 형태만 인식하므로, 길쭉한 타원형 군집은 GMM으로, 도넛형·초승달형은 DBSCAN이나 커널 K-means로 해결합니다.
- 이상치(Outlier) 민감성: 평균(Mean) 계산 특성상 극단값에 중심점이 크게 흔들리므로, 실제 데이터 중간값을 대표로 삼는 K-Medoids (PAM)로 보완합니다.
- 초기값 의존성과 국소 최적해: 무작위 초기화의 불안정성은 K-means++ 확률 분할 기법으로 완벽히 표준화되었습니다.
- 사전 K 지정의 어려움: 표준편차에 따라 스스로 분할하고 합치는 ISODATA나 베이지안 정보 기준(BIC)을 쓰는 X-Means로 진화했습니다.
👑 결론: 데이터 과학의 영원한 베이스라인(Baseline)
군집화 전체 지형도에서 K-means는 "가장 먼저 시도하고, 다른 모든 첨단 알고리즘의 성능을 평가할 때 기준점으로 삼는 절대적인 골드 스탠다드 벤치마크"입니다.
머신러닝 엔지니어는 데이터셋이 주어졌을 때 항상 K-means를 1순위로 실행하여 대략적인 군집 형태와 복잡도를 가늠한 뒤, 필요에 따라 더 복잡한 밀도 기반이나 딥러닝 임베딩 군집화로 나아가는 나침반으로 삼습니다.
6. K-평균 군집화 학술 논문 및 원문 연구 아카이브 (Historical Archives)
K-means 알고리즘의 발전을 이끈 기념비적인 고전 논문들과 국내 통계학회 연구 문헌 자료입니다.
-
J. B. MacQueen (1967): "Some Methods for classification and Analysis of Multivariate Observations", Proceedings of 5-th Berkeley Symposium on Mathematical Statistics and Probability, Berkeley, University of California Press, 1:281-297.
[K-means라는 용어를 최초로 제안하고 다변량 표본 관측의 온라인 분할 군집화 원리를 수학적으로 규명한 역사적 고전 논문] -
The k-means Algorithm : Earl Gose, Richard Johnsonbaugh, Steve Jost 외.
[패턴인식 분야에서 K-means 알고리즘의 수렴 특성과 오차 정정 과정을 수학적으로 분석한 대표적 텍스트] -
K-평균군집화 (K-Means Clustering) : 장남식 교수 (서울시립대학교 경영학부).
[데이터마이닝 실무 환경에서 K-평균 군집화 기법을 적용한 비즈니스 고객 세분화 분석 연구] -
K-평균 군집 방법을 이용한 가중 커널분류기 (Kernel Pattern Recognition using K-means Clustering Method) : 심정욱, 백장선, 한국통계학회 응용통계연구 13권 2호, 2000.
[K-means의 중심점을 커널 분류기의 대표 프로토타입으로 활용하여 비선형 패턴인식 성능을 비약적으로 개선한 연구] -
K-평균 군집화의 재현성 평가 및 응용 (Reproducibility Assessment of K-Means Clustering and Applications) : 허명희, 이용구, 한국통계학회 응용통계연구 17권 1호, 2004.
[초기 씨앗점 선택에 따른 K-means 군집 결과의 통계적 재현성(Reproducibility)을 정량 평가하고 실무 적용 지침을 제시한 논문]