Kernel Estimator 와 Window Estimator 의 결정적 차이점
커널 추정기(Kernel Estimator)와 윈도우 추정기(Window Estimator, Parzen Window)는 비모수 밀도 추정을 수행한다는 최종 수학적 결과는 같지만, "계산을 바라보는 중심축(시점)", "작동 메커니즘(방사 vs 수집)", 그리고 "실제 구현 및 패턴 분류에서의 활용 목적"에서 뚜렷한 개념적 차이를 지닙니다.
시각적 그림 비교: 커널의 '방사 합성' vs 윈도우의 '국소 수집'
• 오른쪽 [윈도우 추정기 (Window Estimator)]: 밀도를 알고 싶은 관심 지점(x0)이 주체가 되어 폭 h의 창문(파란 점선 영역)을 엽니다. 창문 안에 들어온 표본(x1, x2)의 가중치 기여도(w1, w2)만을 수집(Gather)하여 x0 지점의 단일 밀도 스칼라값 p̂(x0)(빨간 기둥)을 즉시 산출합니다.
🌊 커널 추정기 (Kernel Estimator)
데이터 중심 (Data-Centric)
• 핵심 시점: 관측된 각각의 데이터 표본(xi)이 주인공입니다.
• 작동 비유: 모든 데이터 표본에 전구를 하나씩 올려놓고, 빛(커널 함수)을 주변 공간 전체로 방사(Spread)하는 것과 같습니다.
• 계산 방식: 모든 표본 지점에서 퍼져 나온 커널 곡선들을 하나로 중첩 합성(Superposition)하여 전체 영역의 연속 확률밀도 곡선 p̂(x)를 완성합니다.
• 주요 목적: 전 영역의 확률분포 형태 시각화, 미분 경사 계산(Mean Shift), 전체 통계적 모델링.
🪟 윈도우 추정기 (Window Estimator)
목표 지점 중심 (Query-Centric)
• 핵심 시점: 밀도를 평가하려는 특정 관심 좌표(x0)가 주인공입니다.
• 작동 비유: 관심 지점 x0에 특정 크기의 창문(Window)을 열어놓고, 창문 안으로 들어오는 주변 데이터 표본들을 수집(Gather)하는 것과 같습니다.
• 계산 방식: 윈도우 부피 V 내부에 위치한 이웃 표본들의 가중치 기여도를 국소적으로 합산(Accumulation)하여 x0 지점의 밀도 p̂(x0)만 즉시 계산합니다.
• 주요 목적: 특정 입력 벡터 x0의 실시간 패턴 분류(Bayes Classifier), 국소 밀도 우도 평가.
| 비교 기준 | 커널 추정기 (Kernel Estimator) | 윈도우 추정기 (Window Estimator, Parzen) | 핵심 요약 |
|---|---|---|---|
| 관점 및 중심축 (Perspective) |
데이터 표본 중심 (Data-Centric) 각 데이터 포인트 xi가 기준점이 됨 |
평가 목표점 중심 (Target/Query-Centric) 밀도를 구하려는 관심 위치 x0가 기준점이 됨 |
표본 vs 목표점 |
| 동작 메커니즘 (Mechanism) |
방사 및 합성 (Spreading & Superposition) 데이터가 주변 공간으로 영향력(곡면)을 방사 |
개방 및 수집 (Windowing & Gathering) 창문을 열어 내부로 들어오는 데이터를 포착 |
방사 vs 수집 |
| 출력 형태 (Output) |
전체 좌표 공간 x에 정의되는 연속 확률밀도 함수 곡선 전체 | 특정 입력 벡터 x0 위치에서의 국소 확률밀도 스칼라 값 | 전체 함수 vs 국소 값 |
| 패턴인식 실무 활용 (Practical Use) |
• 전체 데이터 분포의 시각화(KDE 플롯) • 미분 경사 계산(Mean Shift 클러스터링) • 비지도 데이터 구조 분석 |
• 특정 테스트 데이터의 클래스 분류(Bayes 판별) • x0 주변 반경 탐색을 통한 고속 분류기 구현 • 이상치(Anomaly) 점수 판별 |
분포 모델 vs 즉시 분류 |
| 수학적 관계 (Mathematical Link) |
수학적 쌍대성(Duality): 커널이 원점 대칭(K(-u) = K(u))일 때 두 추정기의 계산 결과는 완벽히 일치함 (도면 2에서 커널로 합성한 x=3의 높이와, x=3에 윈도우를 열어 구한 값 4/27이 완벽히 같은 원리) |
쌍대적 일치 | |
• "전체 데이터의 분포 곡면이 어떻게 생겼는지 그리고 싶다" → 커널 추정기(Kernel Estimator) 관점으로 접근합니다.
• "새로 들어온 환자/테스트 데이터 x0가 어느 클래스에 속하는지 분류하고 싶다" → 윈도우 추정기(Window Estimator) 관점으로 x0 지점에 창문을 열어 주변 이웃들을 집계합니다.
1. 수학과 통계학에서 차지하는 커널 및 윈도우 추정기의 위상
현대 통계학과 확률 이론에서 커널 밀도 추정(KDE, Kernel Density Estimation)과 파젠 윈도우(Parzen Window)는 모수적(Parametric) 통계학의 경직성을 탈피하여 비모수적(Non-parametric) 통계학으로 도약한 역사적 분수령으로 평가받습니다.
🎯 모수적 vs 비모수적 패러다임 전환
모수적 방법은 데이터가 가우시안이나 포아송 분포를 따른다고 전제하고 평균과 분산만 추정하지만, 실제 복잡한 데이터는 다봉(Multi-modal)이거나 심하게 비대칭입니다. 커널 추정기는 분포 형태에 어떠한 가정도 두지 않고 데이터 스스로 분포를 형성하게 만듭니다.
📊 히스토그램의 불연속성 한계 극복
히스토그램은 구간의 시작점(Bin Origin)과 구간 폭(Bin Width)의 위치에 따라 모양이 급변하며, 계단식 불연속 함수여서 미분이 불가능합니다. 커널 추정기는 구간 경계 의존성을 완벽히 제거하고 전 구간에서 매끄럽게 미분 가능한 연속 곡면을 제공합니다.
🏆 로젠블랫-파젠의 점근적 일치성
1956년 Murray Rosenblatt와 1962년 Emanuel Parzen에 의해 정립된 이론으로, 표본 수 n이 무한대로 갈 때 추정된 밀도 p̂(x)가 참 확률밀도 p(x)로 평균 제곱 수렴(MISE 수렴)함을 수학적으로 완벽히 입증하였습니다.
평균 적분 제곱 오차(MISE)와 대역폭(Bandwidth) 최적화 이론
통계학에서 커널 추정량의 성능은 추정 곡선과 참 곡선 사이의 오차를 전 구간 적분한 MISE(Mean Integrated Squared Error)로 평가됩니다.
• 점근적 편향(Asymptotic Bias): 대역폭 h가 클수록 과도하게 뭉개져 편향이 증가합니다 (O(h2)).
• 점근적 분산(Asymptotic Variance): 대역폭 h가 작을수록 표본의 국소 노이즈에 민감해져 분산이 폭증합니다 (O(1 / (n · h))).
• 수학적으로 편향과 분산의 합을 최소화하는 최적 대역폭 h*는 표본 크기 n에 대해 n-1/5에 비례함이 증명되었습니다 (Silverman, 1986).
2. AI, 데이터 분석, 컴퓨터 비전, 패턴인식에서의 핵심 활용
커널 및 윈도우 추정기는 단순히 통계학적 분포 시각화에 그치지 않고, 패턴인식의 결정 경계 생성, 비지도 클러스터링, 비디오 객체 추적, 그리고 동적 배경 분리에 이르기까지 인공지능 전 분야에서 핵심 알고리즘의 심장 역할을 수행합니다.
🏷️ 패턴인식: 비모수 베이지안 분류 (Bayes Classifier)
각 클래스 Ci에 속하는 훈련 표본들로부터 클래스 조건부 확률밀도 p(x | Ci)를 커널/윈도우 방법으로 추정합니다. 새로운 입력 벡터 x0가 들어오면 베이즈 정리 P(Ci | x0) ∝ p(x0 | Ci) · P(Ci)를 계산하여 사후확률이 최대인 클래스로 분류합니다. 복잡하고 비선형인 적응형 결정 경계(Adaptive Decision Boundary)를 자연스럽게 형성합니다.
🚨 머신러닝: 이상치(Anomaly) 및 OOD 탐지
정상 데이터셋으로 커널 밀도 추정 모델 p̂(x)를 구축한 후, 새로운 데이터 xtest의 밀도 값이 사전에 정의한 임계값 θ보다 낮으면(p̂(xtest) < θ), 이를 정상 분포에서 벗어난 이상치(Outlier) 또는 OOD(Out-of-Distribution, 미학습 데이터)로 정밀 판정합니다.
🎯 컴퓨터 비전: Mean Shift 및 CamShift 객체 추적
Mean Shift 알고리즘(Comaniciu & Meer, 2002)은 커널 밀도 함수의 기울기 벡터(Gradient Vector)를 계산하여 밀도가 가장 높은 극댓점(Mode)을 향해 윈도우를 반복 이동시키는 기법입니다. 비디오 영상에서 물체의 색상 분포 밀도를 추적하는 CamShift(Continuously Adaptive Mean Shift)는 자율주행과 지능형 CCTV의 실시간 물체 추적에 널리 사용됩니다.
🎥 컴퓨터 비전: 비디오 동적 배경 차분 (Background Subtraction)
CCTV 카메라 영상에서 바람에 흔들리는 나뭇가지, 잔잔히 일렁이는 호수 수면, 조명 깜빡임 등은 가우시안 1개로 모델링하기 어렵습니다. 비모수 배경 모델링(Elgammal et al., 2002)은 각 픽셀의 최근 프레임 색상 값들에 커널 밀도 추정을 적용하여 복잡한 다봉 배경 분포를 완벽히 모델링하고 전경(Foreground) 움직임을 깨끗이 분리합니다.
📊 데이터 분석 & EDA: 바이올린 플롯과 다봉성 탐지
현대 데이터 사이언스(Seaborn, ggplot2)의 바이올린 플롯(Violin Plot)과 조이플롯(Joyplot)은 상자 그림(Box Plot)의 단순 통계량 뒤에 숨겨진 다봉성(Bimodal, Multimodal)과 비대칭 왜도를 드러내기 위해 좌우 대칭 KDE 곡선을 활용합니다.
🤖 생성형 AI: 스코어 매칭과 디퓨전 모델의 기초
최신 생성 AI의 핵심인 스코어 기반 생성 모델(Score-based Generative Models) 및 확산 모델(Diffusion Models)은 데이터의 로그 확률밀도의 기울기인 점수 함수(Score Function, ∇x log p(x))를 학습합니다. 이 점수 함수의 모태가 바로 커널 밀도 추정에서의 밀도 경사 계산입니다.
3. 핵심 개념과 수학적 표현식 (표준 HTML 수식 표기)
커널 및 윈도우 추정기는 "불연속적인 델타 스파이크의 합"에서 출발하여 "부드러운 커널 함수의 중첩(합성)" 및 "국소 윈도우 내 가중치 수집"이라는 두 가지 상호 쌍대적(Dual) 관점으로 완성됩니다.
1) 델타 함수(Delta Spikes)의 불연속성과 스무딩(Smoothening)의 필요성
관측된 n개의 표본 데이터(예: x = {1, 2, 4})가 주어졌을 때, 각 표본 지점에 폭 δ가 매우 좁고 높이가 1 / (n · δ)인 직사각형 스파이크(Dirac Delta의 이산 근사)를 세우면 전체 면적의 합은 1.0이 됩니다.
하지만 이 델타 함수 근사치는 표본 지점 이외의 모든 곳에서 밀도가 0이 되며, 계단형 불연속 함수이므로 패턴 분류기의 실제 의사결정에서는 유용하게 사용될 수 없습니다. 따라서 이 뾰족한 델타 함수를 매끄러운 커널(Kernel) 함수로 대체하여 면적 합이 1이 되도록 부드럽게 펴주는 평활화(Smoothening) 과정이 필수적입니다.
🌊 관점 1: 커널 방법 (Kernel View - 방사/합성 관점)
각 훈련 표본 xi가 중심이 되어 주변 공간으로 자신의 영향력(커널 곡면)을 퍼뜨립니다. 전체 공간의 추정 밀도 p̂(x)는 모든 표본이 방사한 커널들의 정규화된 총합(Superposition)으로 구해집니다.
🪟 관점 2: 윈도우 방법 (Parzen Window View - 수집 관점)
밀도를 평가하고자 하는 특정 관심 지점 x0를 중심으로 부피 V = hd인 윈도우 영역을 펼칩니다. 윈도우 내부로 들어오는 주변 표본들의 가중 기여도를 모아서 합산(Accumulation)합니다.
커널 함수가 원점에 대해 대칭(K(-u) = K(u))이면, K((x0 - xi)/h) = K((xi - x0)/h)가 성립합니다. 즉, "각 데이터 표본이 커널을 뿌려 합성하는 것"과 "평가 지점에서 윈도우를 열어 주변 데이터를 수집하는 것"은 수학적으로 완벽히 동일한 계산 결과를 산출합니다.
주요 4대 커널 함수(Kernel Functions)의 수학적 형태와 특성
유효한 커널 함수 K(u)는 반드시 다음 수학적 조건을 만족해야 합니다: (1) 비음수성 K(u) ≥ 0, (2) 전체 적분합 ∫ K(u) du = 1.0 (확률밀도 성질), (3) 원점 대칭성 K(-u) = K(u), (4) 1차 모멘트 ∫ u · K(u) du = 0.
| 커널 명칭 | 수학적 정의 K(u) | 유효 지지 집합 (Support) | 평활화 특성 및 장단점 |
|---|---|---|---|
| 사각 커널 (Rectangular / Uniform) |
K(u) = 1/2 | |u| ≤ 1 | 계산이 매우 빠르나 경계(|u|=1)에서 불연속 계단 발생, 미분 불가 |
| 삼각 커널 (Triangular) |
K(u) = 1 - |u| | |u| ≤ 1 | 연속 곡선이지만 꼭짓점(|u|=0, 1)에서 미분 불가능한 꺾임 발생 |
| 가우시안 / 정규 커널 (Gaussian / Normal) |
K(u) = [ 1 / √(2π) ] · exp( -u2 / 2 ) | -∞ < u < ∞ (전 구간) | 무한 번 미분 가능(Smooth), 꼬리가 길어 모든 표본을 매끄럽게 반영 (실무 최고 선호) |
| 에파네치니코프 커널 (Epanechnikov) |
K(u) = (3/4) · (1 - u2) | |u| ≤ 1 | MISE(오차)를 수학적으로 최소화하는 이론적 최적 효율 커널 |
⚖️ 대역폭 h(Bandwidth)의 편향-분산 트레이드오프 (Bias-Variance Dilemma)
• h가 너무 큰 경우 (과도한 평활화, Over-smoothing):
→ 데이터의 세밀한 구조와 다봉(Multimodal) 피크가 모두 뭉개져 사라집니다. 높은 편향(High Bias) 및 과소적합(Underfitting) 발생.
• h가 너무 작은 경우 (과소 평활화, Under-smoothing):
→ 각 표본 위치마다 뾰족한 가시 스파이크가 솟아오르며 배경 노이즈까지 모조리 표현합니다. 높은 분산(High Variance) 및 과적합(Overfitting) 발생.
• 실버만의 경험 법칙 (Silverman's Rule of Thumb):
가우시안 커널 사용 시 최적 대역폭 추정치: h* ≈ 1.06 · σ̂ · n-1/5 (여기서 σ̂는 표본 표준편차, n은 데이터 개수).
4. 커널 및 윈도우 추정 알고리즘 실행 5단계
임의의 1차원 또는 다차원 데이터셋이 주어졌을 때, 컴퓨터가 커널 및 윈도우 추정기를 통해 연속 확률밀도를 계산하고 의사결정에 활용하는 전체 파이프라인 5단계입니다.
1단계: 표본 데이터셋 수집 및 정의 (Data Collection)
분석 대상 표본 집합 X = {x1, x2, ..., xn}을 수집합니다. 1차원 수치(예: 시험 점수, 센서 전압) 또는 d차원 특징 벡터(예: 영상 색상 좌표, 음향 주파수 특성)로 구성됩니다.
2단계: 커널 함수 K(u) 및 최적 대역폭 h 선정 (Kernel & Bandwidth Selection)
미분 가능성과 평활도가 필요하다면 가우시안 커널을, 연산 속도가 중요하다면 사각/삼각 커널을 선택합니다. 실버만 경험 법칙이나 K-겹 교차 검증(K-Fold Cross Validation)을 통해 오차(MISE)를 최소화하는 대역폭 h를 확정합니다.
3단계: 평가 지점(Grid / Query Point) x 설정 (Evaluation Point Setting)
밀도를 추정하고자 하는 특정 질의 좌표 x(또는 전 구간을 일정 간격으로 쪼갠 등간격 그리드 벡터들)를 지정합니다.
4단계: 정규화 거리 ui 계산 및 커널 가중치 평가 (Distance & Kernel Evaluation)
평가 지점 x와 각 표본 xi 사이의 정규화된 상대 거리 ui = (x - xi) / h를 구한 뒤, 커널 함수에 대입하여 기여 가중치 K(ui)를 각각 계산합니다.
5단계: 가중치 총합 누적 및 정규화 계수 적용 (Normalization & Density Output)
계산된 모든 표본의 커널 가중치를 합산하고 정규화 계수 1 / (n · hd)를 곱하여 최종 추정 확률밀도 p̂(x)를 출력합니다. 이 값을 기반으로 패턴 분류, 이상치 판정, 모드 탐색을 수행합니다.
5. 핵심 원본 도면 정밀 시각화 및 학술적 상세 해설
아카이브에 보존된 4개의 역사적 원본 도면을 바탕으로, 델타 함수 근사의 한계부터 커널과 윈도우의 계산 과정, 커널 종류별 형상, 그리고 가우시안 평활화의 우수성을 완벽히 해설합니다.
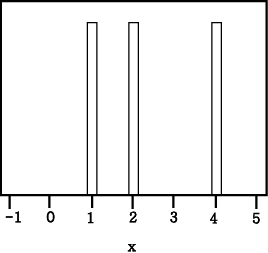
도면 1: 3개의 델타 함수(Delta Spikes)에 의한 거친 근사치
• 데이터 배치: x = 1, 2, 4 위치에 각각 표본이 존재합니다 (총 표본수 n = 3).
• 스파이크의 규격: 각 막대(Bar)의 폭은 δ이고 높이는 q / (n · δ) (여기서 q = 1)로 설정되어 있습니다.
• 면적의 합: 각 막대의 면적은 폭 × 높이 = δ × [ 1 / (3·δ) ] = 1/3 이며, 3개 막대 면적의 총합은 1/3 + 1/3 + 1/3 = 1.0이 됩니다.
• 학술적 시사점: 전체 면적의 합은 정확히 1이지만, 데이터가 없는 구간(예: x=1.5, 3.0)에서는 밀도가 0이 되어 연속적인 확률적 의사결정에 전혀 활용할 수 없습니다. 이것이 부드러운 커널이 도입된 직접적 이유입니다.
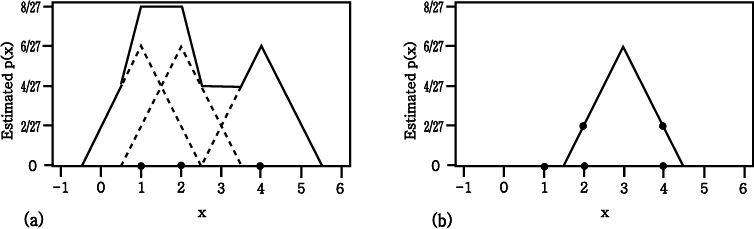
도면 2: 커널 합성 방법(a) vs 윈도우 수집 방법(b)의 계산 비교
• (a) 커널 방법 (Kernel View): 표본 x = 1, 2, 4 위치에 각각 밑변이 6, 높이가 1/9인 삼각 커널(점선)을 배치한 후 합산한 결과가 실선 곡선입니다. 실선 아래의 전체 면적 합은 정확히 1.0입니다.
• (b) 윈도우 방법 (Window View): 평가 대상 지점 x = 3에서 확률밀도 p̂(3)을 계산하기 위해 x=3을 중심으로 폭이 3인 윈도우 함수를 위치시킵니다. 이 윈도우에는 x=2와 x=4 두 개의 표본이 포함되며, 각 표본 위치에서의 윈도우 높이는 각각 2/27입니다.
• 수치 계산 결과: p̂(3) = 2/27 + 2/27 = 4/27 (≈ 0.1481) 이 도출되며, 이는 커널 방법 (a)에서 x=3 지점의 실선 높이와 완벽히 일치합니다!
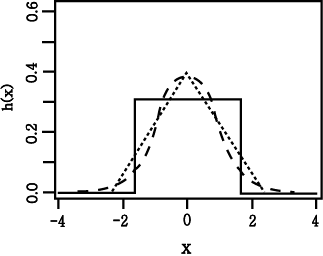
도면 3: 3대 대표 커널 함수(사각, 삼각, 정규) 형상 비교
• 공통 기준: 세 커널 모두 곡선 아래 면적의 합은 1.0이고 표준편차도 1.0으로 엄격히 정규화되어 있습니다.
• 사각 커널 (Rectangular, 실선): 양 끝단에서 수직으로 떨어지는 계단형 구조를 보입니다.
• 삼각 커널 (Triangular, 점선): 중앙 피크에서 양측으로 선형 감쇠하며 밑변 끝에서 0이 됩니다.
• 정규분포 커널 (Normal / Gaussian, 파선): 종 모양(Bell-curve)의 유려한 대칭 곡선으로 양 끝이 0에 점근적으로 수렴합니다. 미분 연산이 필요한 모든 AI 모델에서 표준으로 채택됩니다.
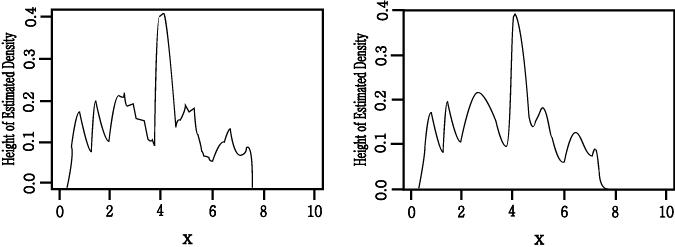
도면 4: 삼각 커널(a) vs 정규 커널(b)에 의한 추정 밀도 비교
• (a) 삼각 커널 추정 결과: 각 표본의 삼각형들이 겹치면서 꺾이는 모서리(Discontinuous derivative)가 다수 발생하여 톱니바퀴 형태의 각진 밀도 함수가 형성됩니다.
• (b) 정규(가우시안) 커널 추정 결과: 모든 표본의 가우시안 곡선이 매끄럽게 융합되어 전 구간에서 미분 가능(Continuously Differentiable)한 유려한 곡면을 형성합니다.
• 패턴인식 결론: 정규 커널이 삼각 커널보다 훨씬 우수한 평활화(Smoothening) 효과를 발휘하며, 역전파 경사 하강법이나 결정 경계 계산에 최적임을 명확히 보여줍니다.
6. 실제 산업 및 최신 기술 활용 사례 (Real-World Case Studies)
커널 및 윈도우 추정기는 첨단 자율주행, 금융 보안, 스마트 팩토리, 헬스케어에 이르는 다양한 산업 현장에서 핵심 인공지능 모듈로 작동하고 있습니다.
🚗 자율주행차: LiDAR 3D 포인트 클라우드 장애물 검출
라이다(LiDAR) 센서가 수집하는 수십만 개의 불규칙한 3D 점 구름에 3차원 가우시안 커널을 적용하여 공간 밀도 맵을 생성합니다. 밀도가 급격히 솟아오르는 극댓점을 Mean Shift로 클러스터링하여 보행자, 자전거, 차량을 실시간으로 감지하고 분리합니다.
💳 핀테크: 신용카드 부정 결제(FDS) 이상 거래 탐지
고객의 평소 결제 시간대, 결제 금액, 위치 좌표를 커널 밀도 추정기로 다차원 모델링합니다. 해외 IP나 비정상적인 새벽 시간대에 거액이 결제될 때 해당 좌표의 추정 확률밀도 p̂(x)가 임계값 미만으로 급락하면 즉시 거래를 차단하고 알림을 발송합니다.
🔬 의료 바이오: 디지털 병리 영상의 암세포 군집 밀도 분석
기가픽셀(Gigapixel) 규모의 암 조직 슬라이드 영상에서 검출된 세포핵 위치에 2D 가우시안 KDE를 적용하여 '종양 침윤 림프구(TIL) 밀도 히트맵'을 자동 생성합니다. 이를 통해 면역 항암제 반응성을 정밀 예측합니다.
🗺️ 지리정보시스템(GIS): 도시 범죄 및 교통사고 위험도 히트맵
경찰청 및 지자체 관제 센터에서 과거 발생한 범죄 및 야간 보행자 사고 위치 좌표에 사각/에파네치니코프 커널을 적용하여 연속 밀도 지도를 생성합니다. 순찰차의 최적 배치 경로와 가로등 우선 설치 구역을 데이터 기반으로 도출합니다.
7. 비모수 밀도 추정 3대 방식 결정적 차이 비교
비모수 통계학과 패턴인식에서 밀도를 추정하는 대표적인 세 가지 방식(히스토그램, 고정 부피 파젠 윈도우, 가변 부피 KNN)의 작동 원리와 차이점을 비교합니다.
| 비교 항목 | 히스토그램 (Histogram) | 커널 & 파젠 윈도우 (KDE) | K-최근접 이웃 (KNN Estimator) |
|---|---|---|---|
| 구간 / 부피 설정 | 고정된 구간 폭(Bin Width)과 사전 정의된 고정 격자 원점 | 고정된 대역폭(h) 및 고정 윈도우 부피(V = hd) | 가변 부피(Adaptive Volume): k번째 최근접 이웃까지의 거리에 따라 부피 V가 팽창/수축 |
| 연속성 및 미분 | 불연속 계단형 함수 (미분 불가) | 가우시안 커널 사용 시 완벽히 매끄럽고 전 구간 미분 가능 | 표면이 꺾이는 부분이 존재하여 연속이지만 고계도 미분 어려움 |
| 밀도 극단 구간 반응 | 샘플이 드문 곳은 빈 칸(0)으로 방치됨 | 데이터 희소 영역에서 노이즈 스파이크 발생 위험 | 데이터 희소 지역에서 부피가 자동 팽창하여 국소 노이즈를 효과적으로 억제 |
| 핵심 통제 매개변수 | 계급의 수(Bins), 구간 폭 w | 대역폭 h (Bandwidth), 커널 함수 K(u) | 이웃의 개수 k (Number of Neighbors) |
비모수 밀도 추정의 핵심 원리 요약
• K-최근접 이웃 (KNN Density Estimator): "데이터 개수(k)를 고정시키고, k개를 포함할 때까지 부피(Volume V)를 늘린다."
• 두 기법 모두 표본 크기 n이 무한대로 증가할 때 참 확률밀도함수로 수렴하는 우수한 비모수적 성질을 지닙니다.