Feedback의 핵심 개념과 작동 원리
피드백 시스템의 본질은 "스스로 측정한 결과와 목표(Target) 사이의 오차(Error)를 계산하여, 미래의 입력을 능동적으로 수정하는 닫힌 루프(Closed Loop)"에 있습니다. 이때 시스템 자체에 되먹임 신호에 반응하여 상태를 수정할 수 있는 내적 구동 및 제어 능력(Controllability)이 필연적으로 갖추어져 있어야 합니다.
음의 피드백 (Negative Feedback, 음되먹임)
출력값이 목표값을 초과하면 입력을 줄이고, 목표값에 미달하면 입력을 늘림으로써 오차를 0으로 상쇄(억제)시키는 방향으로 작용합니다. 보일러의 온도 조절기(Thermostat), 인체의 혈당·체온 항상성(Homeostasis) 유지, 와트의 원심 조속기 등 모든 안정적인 자동화 제어 기구의 표준 원리입니다.
양의 피드백 (Positive Feedback, 양되먹임)
출력 신호가 입력을 더욱 자극하여 시스템의 반응을 기하급수적으로 폭증·가속시키는 방향으로 작용합니다. 마이크와 스피커의 하울링(하울링 발진), 화학의 벨로우소프-자보틴스키(BZ) 자가 촉매 반응, 금융 시장의 패닉 바잉/셀링, 신경 세포의 활동전위(Action Potential) 개시 등이 대표적입니다. 제어되지 않으면 시스템 폭주나 파괴를 초래합니다.
제어공학에서의 Feedback vs AI 에서의 Feedback 심층 비교
제어공학의 피드백이 "엄밀한 수학적 물리 모델에 기반한 실시간 연속 출력 안정화"를 목표로 한다면, 인공지능(AI)의 피드백은 "데이터 손실 함수와 보상 신호를 통한 모델 내부 파라미터의 적응적 학습"을 목표로 합니다.
| 비교 항목 | 제어공학의 Feedback (Control Engineering) | AI / 머신러닝의 Feedback (Machine Learning) |
|---|---|---|
| 피드백의 대상 | 현재 제어 입력값(Control Input u(t)) (모터 전류, 밸브 개폐율, 조향각 등) |
신경망 가중치(Weights W) 및 정책(Policy π) (모델의 내부 지식 구조 및 행동 규칙) |
| 오차 계산 방식 | 목표치 r(t)와 센서 측정치 y(t)의 물리적 차이: e(t) = r(t) - y(t) | 손실함수(Loss L)의 편미분 기울기(Gradient) 또는 환경의 스칼라 보상값(Reward R) |
| 시간 척도 (Latency) | 밀리초(ms) 단위 초고속 실시간 반응 (100Hz ~ 10kHz 하드웨어 인터럽트 루프) |
에포크(Epoch) 단위 오프라인 훈련 또는 초 단위 추론/에이전트 의사결정 루프 |
| 수학적 보증 | 리아푸노프(Lyapunov) 안정성 및 보데 선도(Bode plot)에 의한 결정론적 안정 마진 보증 | 확률적 경사 하강법(SGD)의 국소 최적해 수렴성 (블랙박스적이며 수학적 엄밀 보증 제한) |
| 대표적 메커니즘 | PID 제어, 칼만 필터(Kalman Filter), 모델 예측 제어(MPC) | 역전파(Backpropagation), 벨만 최적 피드백(RL), RLHF / DPO |
로봇과 자율주행 에서의 계층적 Feedback 구조
휴머노이드 로봇과 자율주행차는 단일 피드백 루프만으로 작동할 수 없습니다. "고주파 저수준 액추에이터 제어(1kHz)"부터 "중간 주파수 궤적 추종(50Hz)", 그리고 "저주파 고수준 인지 경로 계획(10Hz)"까지 다층 계층적 피드백 루프(Hierarchical Multi-Rate Feedback)가 유기적으로 맞물려 작동합니다.
저수준 모터 토크 피드백
로봇 관절의 광학 엔코더와 전류 센서, IMU(관성측정장치)로부터 초당 1,000회 이상 피드백을 받아 모터의 토크와 조향각을 실시간 조정합니다. 울퉁불퉁한 지면에서도 균형을 잃지 않는 외란 보정의 핵심입니다.
궤적 추종 MPC & SLAM
라이다(LiDAR), 레이더 및 카메라 정보를 기반으로 차량의 현재 위치(SLAM)와 전방 장애물을 인식하고, 모델 예측 제어(MPC)를 통해 미래 수 초간의 오차를 시뮬레이션하여 부드러운 차선 유지 및 회피 기동을 수행합니다.
고수준 행동 및 인지 계획
신호등 상태, 보행자의 돌발 행동, 내비게이션 경로 데이터를 종합하여 감속, 차선 변경, 비상 정지 등의 고수준 정책을 결정합니다. 환경 변화에 따른 경로 재탐색(Re-planning) 루프가 끊임없이 순환합니다.
최신 LLM(거대언어모델) 발전에 미친 Feedback의 혁신적 영향
단순한 '텍스트 다음 단어 생성기'였던 LLM이 실세계에서 문제를 스스로 해결하는 자율 지능형 에이전트(Agentic AI)로 대도약할 수 있었던 원동력은 바로 다층 피드백 루프의 결합에 있습니다.
환경 피드백 기반 ReAct 및 자가 교정(Self-Correction)
기존의 단발성 응답(Open-loop)과 달리, 최신 LLM 에이전트는 코드를 실행하고 터미널 오류 메시지(Traceback)를 관찰(Observation) 피드백으로 수신하여 스스로 코드를 디버깅합니다. ReAct(Reasoning + Acting) 및 자가 성찰(Reflexion) 루프는 사이버네틱스 음의 피드백을 통해 목표 달성 성공률을 비약적으로 끌어올립니다.
RLHF, RLAIF 및 DPO 모델 정렬 (AI Alignment)
인간의 선호도 피드백(RLHF) 및 AI 비평가 피드백(RLAIF, Constitutional AI)은 초거대 언어 모델이 환각(Hallucination)이나 유해한 편향을 일으키지 않도록 출력을 제어하는 강력한 피드백 메커니즘입니다. 보상 모델(Reward Model)은 제어기의 오차 검출기 역할을 수행합니다.
추론 시점 연산(Test-Time Compute)과 MCTS 검증 루프
OpenAI o1, o3 및 DeepSeek-R1과 같은 최신 추론형 모델은 토큰을 즉시 사용자에게 뱉어내는 대신, 내부 체인 오브 소트(CoT) 과정에서 몬테카를로 트리 탐색(MCTS)과 PRM(Process Reward Model) 피드백을 통해 중간 추론 단계를 자가 평가하고 잘못된 가설을 백트래킹(Backtracking)하여 정답을 도출합니다.
멀티 에이전트 상호 비평(Peer Review) 피드백
기획 에이전트, 개발 에이전트, QA 검증 에이전트가 상호 메시지 교환을 통해 결과물을 교차 검증하고 수정 지시를 주고받는 멀티 에이전트 시스템은 전체 팀의 산출물 품질을 일정 수준 이상으로 수렴시키는 분산 협력 피드백 망을 형성합니다.
역사적 피드백 도해 보존 및 생체 항상성(Homeostasis)
[보존 원본 도해] 일반적인 피드백 시스템의 모식도
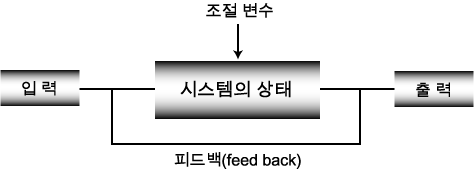
목표 입력 ➔ 오차 비교기(Σ) ➔ 제어 요소 ➔ 제어 대상(플랜트) ➔ 출력 및 센서 검출을 거쳐 음의 피드백으로 되돌아오는 고전적 폐루프 구조
1. 증기기관 조속기와 노버트 위너의 정립
1782년 제임스 와트의 증기기관 조속기(Centrifugal Governor)는 회전 속도가 과도하면 원심력으로 추가 올라가 증기 밸브를 열어 압력을 낮추고, 속도가 줄면 밸브를 닫아 회전 속도를 서서히 회복하는 기계식 음의 피드백 장치였습니다.
1948년 수학자 노버트 위너(Norbert Wiener)는 이를 기계와 생물체를 아우르는 사이버네틱스(Cybernetics)의 보편 원리로 정립하여 현대 공학과 컴퓨터 과학의 기틀을 마련했습니다.
2. 인체 신경계의 항상성과 양의 피드백 사례
인간의 뇌와 중추신경계 및 자율신경계는 수면, 호흡, 혈압 조절 등 생명 유지에 필요한 항상성(Homeostasis)을 무수한 음의 피드백으로 조율합니다.
반면 의료 쇼크 증상이나 트라우마(속담 '자라 보고 놀란 가슴 솥뚜껑 보고 놀란다')처럼 미세한 자극을 비합리적으로 증폭시키는 병리적 현상은 비선형 양의 피드백이 초래하는 부작용의 전형적인 사례입니다.